Более 6560 заметок о VMware, AWS, Azure, Veeam, Kubernetes и других
VM Guru / News / Оптимизация развертываний AI с помощью VMware Cloud Foundation - максимальная производительность, эффективность и гибкость в мультитенантных средах
Оптимизация развертываний AI с помощью VMware Cloud Foundation - максимальная производительность, эффективность и гибкость в мультитенантных средах
VMware Cloud Foundation (VCF) обеспечивает операционную эластичность и эффективность использования ресурсов, необходимые современным масштабируемым AI-средам, и помогает превратить аппаратную AI-систему в частную, гибкую и готовую к AI инфраструктуру корпоративного уровня. На фоне резкого роста стоимости оборудования для центров обработки данных за последний год ИТ-директора компаний стремятся выжать максимум из каждого компонента своих ЦОД. VCF помогает предприятиям повысить загрузку ресурсов и оптимизировать AI-инфраструктуру.
Платформа VMware Cloud Foundation (VCF) недавно получила сертификацию NVIDIA для гипервизоров. VMware vSphere 9.1 (и все последующие релизы vSphere 9.x) теперь является сертифицированным NVIDIA гипервизором (NVIDIA-Certified Hypervisor) с производительностью AI-нагрузок, близкой к bare metal.
Команда Broadcom Performance провела обширные тесты производительности, демонстрирующие эффективность и гибкость VCF при выполнении AI-нагрузок в различных конфигурациях. Для разъяснения результатов опубликован технический документ (white paper) и готовится серия из четырех статей:
Часть 1 (эта статья): максимальная производительность, эффективность и гибкость в мультитенантных средах
Часть 2: максимальная загрузка GPU для наилучшей совокупной стоимости владения
Часть 3: максимальная загрузка CPU и памяти для наилучшей совокупной стоимости владения
Часть 4: использование разделения времени (time-slicing) для оптимизации пропускной способности инференса
Ниже представлена первая часть этой серии.
В мультитенантной среде каждым тенантом может быть подразделение, проект или внешний заказчик, и все тенанты используют одно и то же оборудование. VCF предоставляет необходимые возможности изоляции, оптимизации ресурсов и самообслуживания, которые делают AI более эффективным и безопасным в эксплуатации.
Основные тезисы:
VCF позволяет гибко развертывать множество вариантов облачных AI-архитектур, отвечающих требованиям корпоративного управления и обеспечивающих максимальное использование облачных ресурсов.
Для строгой изоляции и безопасности рабочие нагрузки каждого тенанта можно развернуть в отдельной виртуальной машине. В качестве альтернативы они могут работать в одной ВМ, но быть изолированы в контейнерах. GPU могут выделяться виртуальным машинам через passthrough GPU, vGPU или MIG vGPU, и любой из этих способов применим как при совместном использовании ВМ тенантами, так и при размещении их в отдельных ВМ.
В экспериментах с инференсом LLM было показано, что две разные архитектуры развертывания обеспечивают практически одинаковую пропускную способность и задержку.
Оптимизация развертывания AI-нагрузок в мультитенантных средах
VCF поддерживает множество гибких архитектур развертывания ИИ-систем, которые помогают максимально загрузить GPU и сохранить высокую производительность, одновременно обеспечивая изоляцию, безопасность и высокую доступность частных ИИ-облаков.
Для ресурсоемких ИИ-нагрузок, полностью потребляющих вычислительные ресурсы и память сервера, ИТ-администраторы могут с помощью VCF выделять отдельные физические серверы, что повторяет развертывание на bare metal, но при этом сохраняет доступ ко многим возможностям VCF. В предыдущей публикации было показано, что VCF демонстрирует лидирующие в отрасли результаты в бенчмарках MLPerf Inference 5.1 на различных GPU и CPU, включая NVIDIA H200 и B200, а также Intel Xeon с ускорением AMX, и на различных типах AI-нагрузок, включая Speech-to-Text (Whisper), Text-to-Video (Stable Diffusion XL), большие языковые модели (Llama3.1 405B, Llama2 70B, Llama3 8B), графовые нейронные сети (R-GAT) и компьютерное зрение (RetinaNet).
Во многих реальных сценариях вычислительные ресурсы корпоративных частных облаков большую часть времени недозагружены, поскольку рабочие нагрузки легкие (например, низкая интенсивность запросов на инференс или малый размер батча). Выделение отдельного оборудования под такие нагрузки приводит к значительной неэффективности и раздувает операционные расходы. В подобных случаях консолидация нескольких рабочих нагрузок на общем оборудовании критически важна для устойчивой и экономически эффективной эксплуатации частных AI-облаков.
В мультитенантных средах VCF ИТ-администраторы могут развертывать тенантов и управлять ими вручную либо через VCF Automation (модели развертывания тенантов описаны здесь). В зависимости от требований предприятия к безопасности и изоляции, управлять AI-нагрузками можно следующими способами:
Нагрузки тенантов в отдельных ВМ (изоляция на уровне ВМ):
Безопасность и сценарий использования: оптимально при строгих требованиях к безопасности и изоляции.
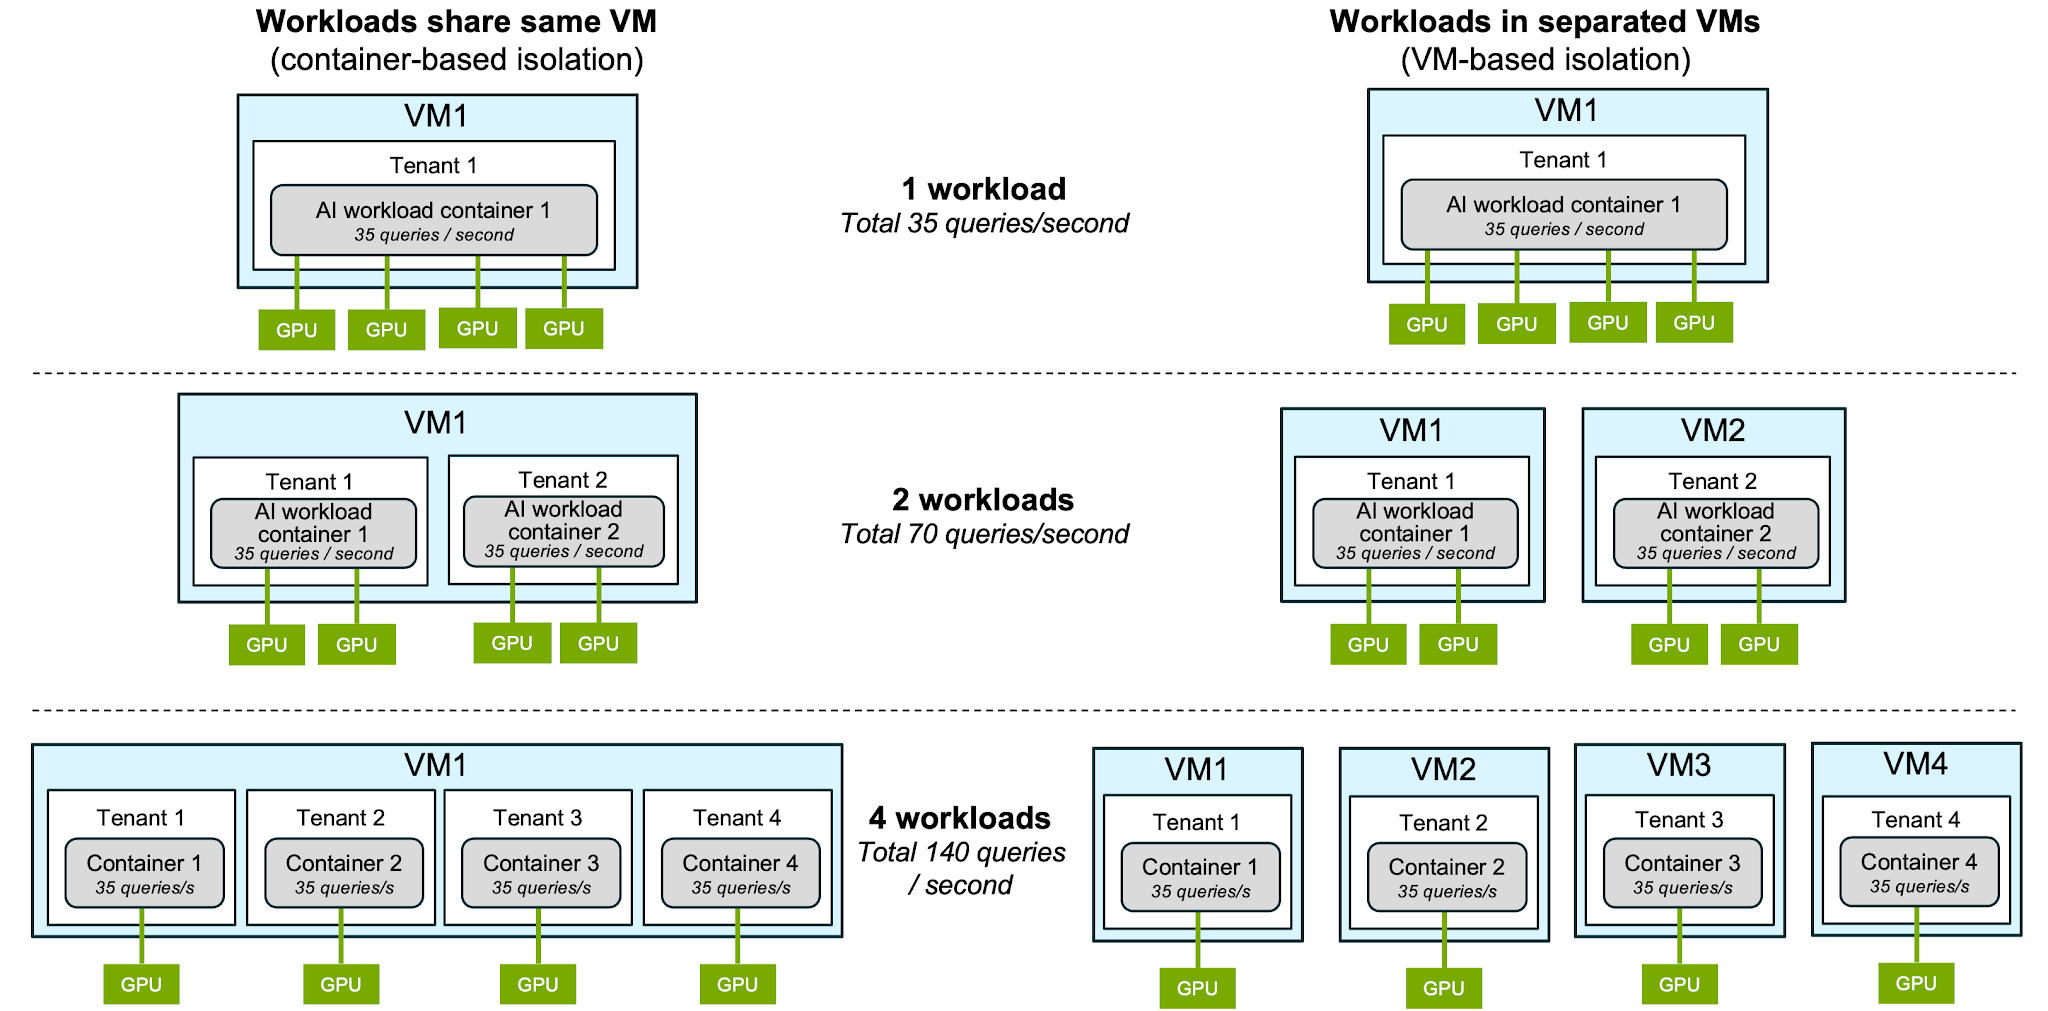
Конфигурация: рабочие нагрузки каждого тенанта развертываются в отдельных ВМ. GPU выделяются виртуальным машинам через прямой проброс (passthrough) GPU или NVIDIA vGPU. С vGPU виртуальной машине можно выделить целый GPU или его часть (дробное выделение), что позволяет совместно использовать ресурсы GPU между ВМ разных тенантов. Пример такой изоляции показан в правом столбце на рисунке 1. Эта конфигурация полностью поддерживается как VCF Automation, так и при ручном управлении.
Нагрузки тенантов в одной ВМ (изоляция на уровне контейнеров):
Безопасность и сценарий использования: оптимально для сред с более низкими требованиями к безопасности, где приоритетом являются консолидация нагрузок и упрощение управления AI-облаком.
Конфигурация: рабочие нагрузки разных тенантов консолидируются в одних и тех же ВМ, которым GPU могут назначаться через прямой проброс (passthrough) или vGPU. Пример такой изоляции показан в левом столбце на рисунке 1 (ниже). Совместное размещение нагрузок нескольких тенантов в одной ВМ поддерживается только при ручном управлении тенантами (VCF Automation требует, чтобы каждый тенант размещался в выделенной ВМ).
Сравнение производительности двух вариантов развертывания
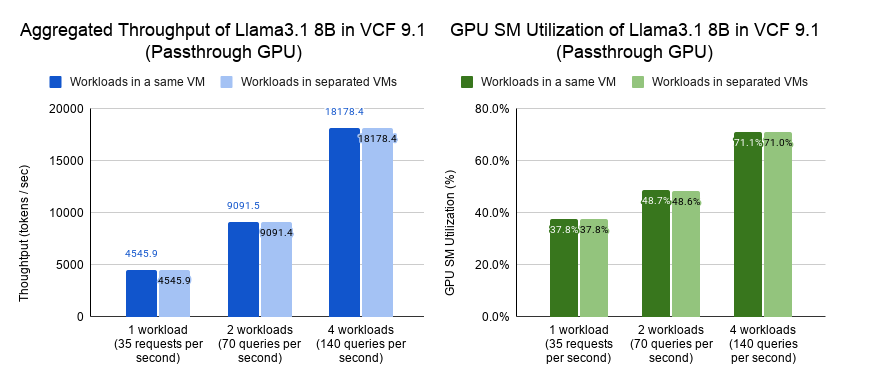
Для наглядности был проведен эксперимент, в котором рабочей нагрузке одного тенанта изначально выделяются все четыре GPU системы, как показано в первой строке рисунка 1 («1 workload»). Если предположить, что эта нагрузка сильно недозагружает GPU (как видно по загрузке потоковых мультипроцессоров GPU на рисунке 2), на сервере можно разместить больше нагрузок для повышения утилизации GPU, как показано во второй («2 workloads») и третьей («4 workloads») строках рисунка 1. В левом столбце представлены тестовые сценарии, в которых нагрузки всех тенантов находятся в одной ВМ, в правом — нагрузки каждого тенанта в отдельной ВМ.
Для имитации AI-нагрузки тенанта запускался MLPerf Inference с нагрузкой Llama3.1 8B при интенсивности 35 запросов на инференс в секунду на системе Dell PowerEdge XE7745 с двумя 64-ядерными процессорами AMD EPYC 9555 (всего 256 логических ядер), 768 ГБ памяти и четырьмя GPU NVIDIA RTX Pro 6000 96 ГБ. Каждая из этих нагрузок инференса выполняется внутри контейнера. Поскольку при такой легкой нагрузке GPU были недозагружены, на том же сервере удалось разместить до четырех аналогичных нагрузок, как показано на рисунке 1. При одновременной работе всех четырех нагрузок суммарная нагрузка на серверы составляет 140 запросов в секунду. Подробности экспериментальной установки, включая программное обеспечение, оборудование, конфигурацию ВМ и рабочие нагрузки, приведены в техническом документе.
Рисунок 1: тестовые сценарии с нагрузками в одной ВМ и нагрузками в отдельных ВМ. В обоих случаях GPU назначаются ВМ через passthrough GPU или vGPU.
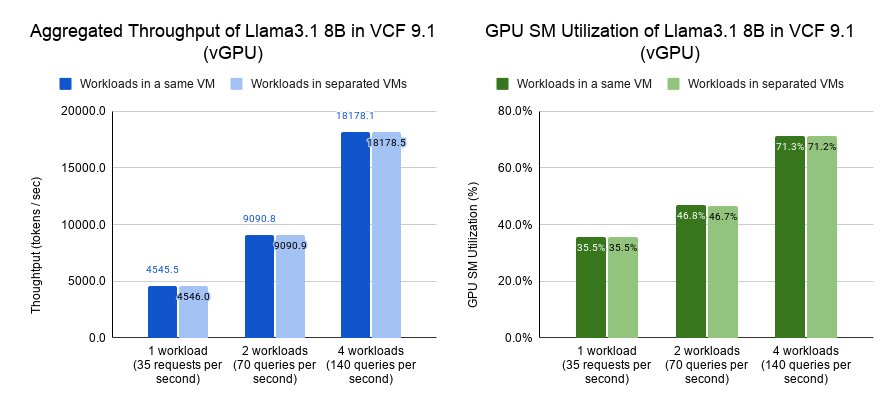
Эксперименты проводились как с passthrough GPU (рисунок 2), так и с vGPU (рисунок 3), чтобы продемонстрировать, что VCF поддерживает оба варианта для мультитенантных развертываний.
Основные результаты экспериментов:
Увеличение числа одновременных нагрузок на одном сервере с 1 до 4 позволило повысить пропускную способность инференса системы почти в четыре раза (примерно с 4500 до 18000 токенов в секунду), как показано на рисунках 2 и 3. Нагрузка определяется количеством одновременных запросов к движку инференса.
Загрузка потоковых мультипроцессоров (Streaming Multiprocessor) GPU выросла до 71% при четырех тенантах вместо 36–38% при развертывании только одного тенанта.
Разница в пропускной способности между двумя способами изоляции нагрузок (изоляция на уровне ВМ и изоляция на уровне контейнеров) практически отсутствовала.
Сравнение производительности при развертывании с passthrough GPU
Рисунок 2: производительность тенантов в отдельных ВМ и тенантов в общей ВМ с passthrough GPU.
Сравнение производительности при развертывании с vGPU
Рисунок 3: производительность тенантов в отдельных ВМ и тенантов в общей ВМ с vGPU.
Заключение
VCF — гибкая, эффективная и безопасная платформа для управления частным AI (Private AI) в мультитенантных корпоративных средах. Предоставляя ИТ-администраторам выбор между изоляцией на уровне ВМ для строгих требований безопасности и изоляцией на уровне контейнеров внутри общей ВМ для упрощения управления, VCF отвечает самым разным операционным и инфраструктурным потребностям.
Результаты экспериментов наглядно показывают, что консолидация нескольких легких, недозагруженных рабочих нагрузок на общем оборудовании решает распространенную проблему недоиспользования ресурсов практически без потерь производительности — независимо от того, распределены ли тенанты по отдельным ВМ или объединены в одной ВМ.
VCF позволяет предприятиям оптимизировать AI-инфраструктуру, обеспечивая высокую доступность, надежную безопасность и максимальную эффективность использования GPU. Это помогает компаниям контролировать затраты на AI-инфраструктуру.


 RSS