Искусственный интеллект несёт в себе потенциал для преобразования бизнеса, однако его промышленное внедрение на предприятиях по-прежнему ограничено. Приватность, защита интеллектуальной собственности и соответствие нормативным требованиям представляют собой серьёзные экзистенциальные угрозы. Организациям приходится устанавливать детальные границы доступа и оберегать проприетарные данные. Стремительный переход к агентному AI многократно усиливает эти исходные точки трения, порождая критически важные проблемы эксплуатации, стоимости и управления. В отличие от традиционных моделей вывода с одиночным вызовом, автономные агенты работают в динамических циклах, что приводит к непредсказуемому нелинейному росту затрат на токены и перегружает унаследованную ИТ-инфраструктуру.
Новые вызовы эпохи агентного AI
В эпоху агентного AI перед предприятиями встают дополнительные задачи, которые необходимо решать.
Эксплуатационная сложность: агентные рабочие нагрузки ведут себя не так, как традиционные запросы на вывод. Агенты выстраивают цепочки из десятков вызовов моделей, обращений к инструментам и циклов рассуждений. Традиционная инфраструктура попросту не создавалась под такой устойчивый и динамичный характер спроса. К трудностям развёртывания относятся:
Развёртывание Day 0: вычислительные ресурсы, сети, хранилище, Kubernetes и сетевая инфраструктура.
Эксплуатация Day 2: управление жизненным циклом, включая установку исправлений, обновления, версионирование моделей и миграции между фреймворками, — всё это превращается из отдельных проектов в непрерывные, накладывающиеся друг на друга циклы.
Рост затрат на токены: AI-агенты работают в итеративных циклах, поэтому потребление токенов масштабируется нелинейно. Более того, по прогнозам, к 2030 году стоимость токенов вырастет вплоть до 24 раз. Раздувание контекста, обмен сообщениями между несколькими агентами, исправление ошибок и рефлексия, а также внутренние промпты «размышления» — всё это примеры причин непредсказуемого удорожания токенов. Облачные LLM тарифицируются по числу токенов, и их пользователи уже сталкивались с неожиданным ростом расходов.
Пробелы в управлении: инженерные команды создают приложения и разворачивают автономных агентов быстрее, чем за ними успевают процессы приватности, безопасности, управления и эксплуатации. В результате возникла разрозненная среда, в которой у руководителей может не быть централизованной картины того, какие модели, инструменты и агенты используются и каким именно образом. Инфраструктура обязана обеспечивать детальный контроль приватности, а также доступа к инфраструктуре и данным, ограничивая то, что каждый агент может читать и изменять, — даже если сама базовая модель считается доверенной.
VMware Private AI Cloud
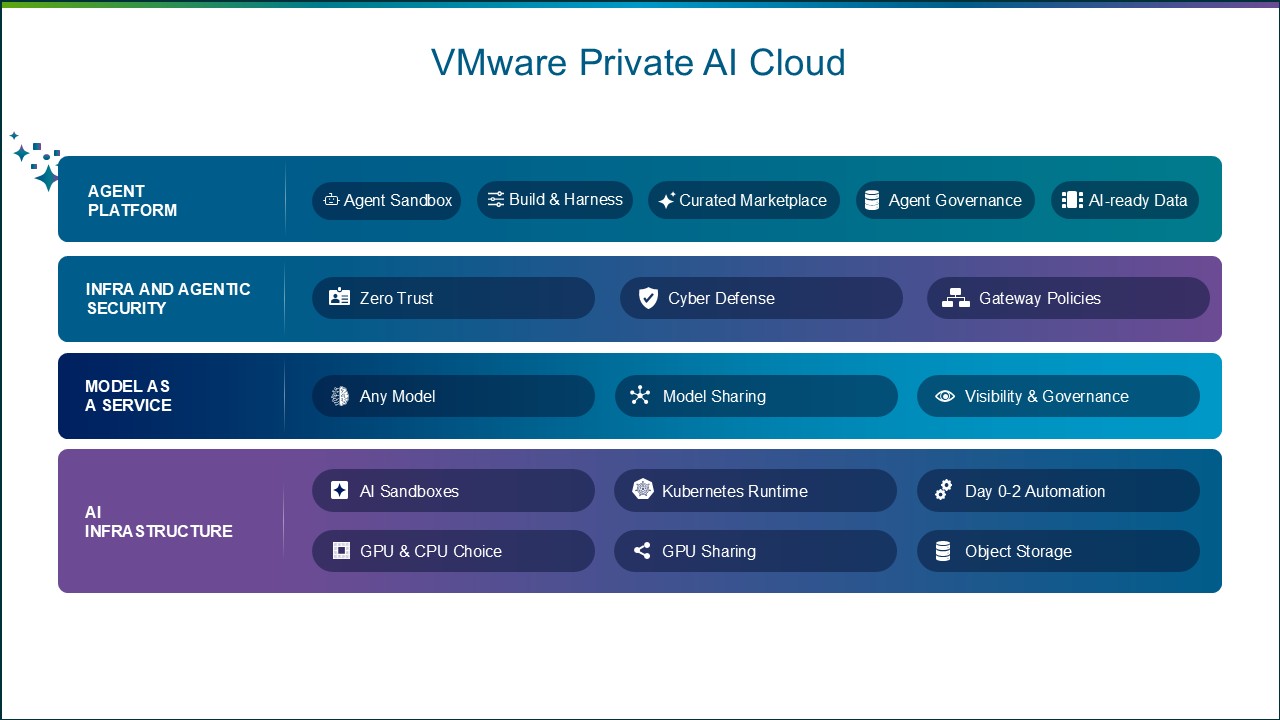
Для решения этих задач компания Broadcom представила VMware Private AI Cloud — решение, позволяющее предприятиям экономично масштабировать AI, работать более безопасно и быстро внедрять инновации. Построенный на передовых программных возможностях Broadcom, VMware Private AI Cloud даёт организациям готовый к промышленной эксплуатации путь к безопасной разработке, запуску и управлению нагрузками вывода, агентными приложениями и традиционными корпоративными нагрузками — совместно, на платформе VCF, с широким выбором оборудования, моделей и ускорителей.
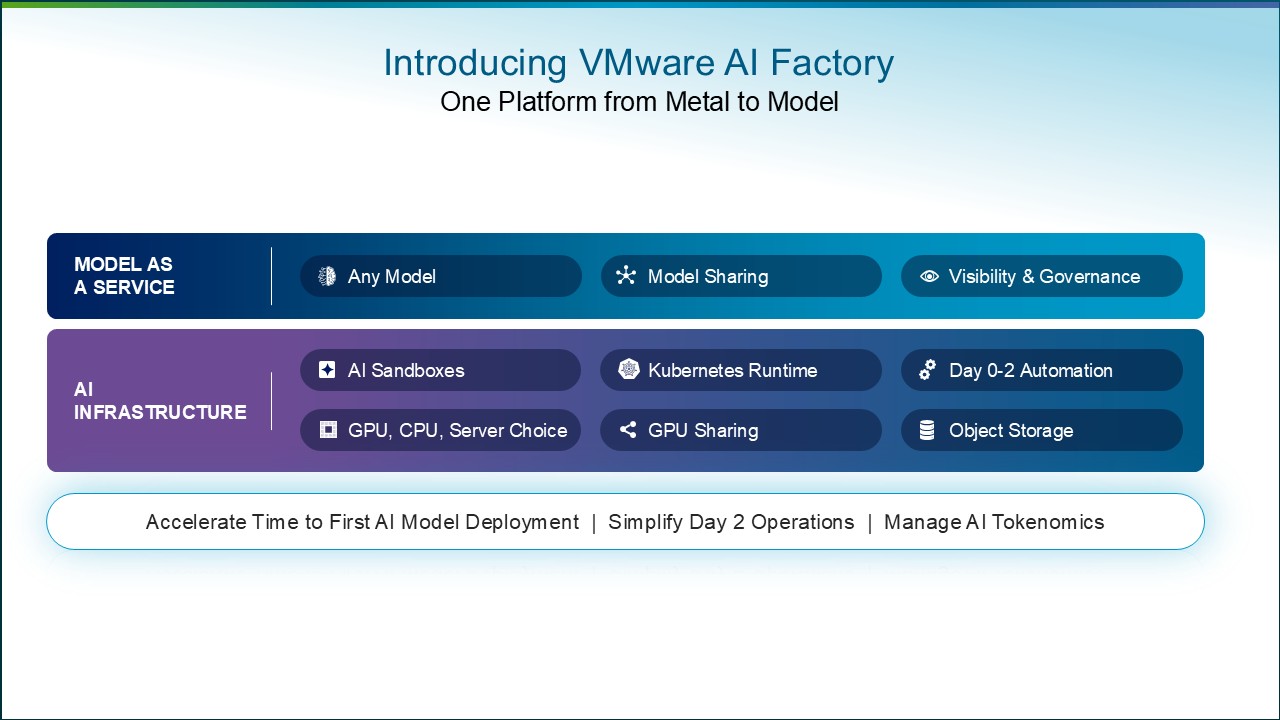
Экономичное масштабирование AI: VMware Private AI Cloud охватывает три основных источника затрат на AI — капитальные вложения в оборудование, эксплуатационную сложность и экономику токенов (токеномику). VCF поддерживает графические процессоры, CPU и ускорители ведущих производителей, а также серверное оборудование крупных OEM- и ODM-поставщиков, что позволяет заказчикам экономично эксплуатировать гетерогенные кластеры. Для оптимизации токеномики и использования ресурсов предусмотрены мониторинг токенов, мультитенантное совместное использование моделей, расширенный учёт GPU/vGPU и панель наблюдаемости AI-метрик. Одна из ключевых инноваций VMware Private AI Cloud — VMware AI Factory, обеспечивающая быстрый путь от развёртывания на «голом железе» до запуска первой модели.
Более безопасная эксплуатация: платформа VCF построена по принципу эшелонированной защиты в соответствии с NIST CSF 2.0 и противостоит угрозам, усиленным средствами AI, за счёт минимизации поверхности атаки и обеспечения непрерывного соответствия требованиям. Автоматические обновления, не нарушающие работу сервисов, поддерживают системы в актуальном состоянии, а VMware vDefend применяет виртуальное патчирование и горизонтальную защиту на уровне гипервизора с микросегментацией, реализуя принцип Zero Trust и блокируя эксплойты. Кроме того, многоуровневая защита от угроз vDefend, а также межсетевой экран уровня веб-приложений и защита API в VMware Avi Load Balancer предотвращают сложные атаки.
Быстрые инновации для эпохи агентного AI: в отличие от традиционных приложений, автономные AI-агенты способны действовать бесконтрольно, выходить за рамки своих полномочий или неверно истолковывать инструкции. Соответственно, доверие к ним зависит от надёжных механизмов контроля и целостности данных. VMware Tanzu Platform в связке с VMware vDefend формирует основу для доверенных корпоративных агентов за счёт архитектуры с запретом по умолчанию, готовой обвязки (harness) и курируемого маркетплейса.
Ниже — подробности о VMware AI Factory, ключевой инновации в составе VMware Private AI Cloud.
VMware AI Factory: движущая сила VMware Private AI Cloud
VMware AI Factory — это программно-определяемый фундамент VMware Private AI Cloud. Он даёт заказчикам упрощённый путь к промышленному AI благодаря новым средствам автоматизации развёртывания инфраструктуры, готовой к ИИ-нагрузкам, и поддержки операций Day 2. С VMware AI Factory заказчики могут быстрее выйти на развёртывание первой модели и эффективнее управлять токеномикой AI.
VMware AI Factory приближает AI-приложения непосредственно к корпоративным приватным данным внутри защищённой среды частного облака. Уникальные возможности автоматизации инфраструктуры в VCF позволяют сократить время от развёртывания сервера на «голом железе» до обслуживания первой AI-модели с недель до считанных часов. VMware AI Factory упрощает управление AI-инфраструктурой, полностью автоматизируя выделение оборудования, включение программного стека и сквозное управление жизненным циклом. Объединяя операции с оборудованием и программным обеспечением в единое автоматизированное решение, организации получают возможность быстро масштабировать AI-нагрузки при минимальной эксплуатационной сложности.
Партнёрства, обеспечивающие работу VMware AI Factory
VMware AI Factory сочетает VCF с сертифицированными серверами Dell PowerEdge и узлами VCF AI ReadyNodes от Cisco, Lenovo, Supermicro и других вендоров, а также с предпочитаемыми заказчиком программными средствами AI и архитектурами ускорителей.
Broadcom и AMD совместно работают над вариантом VMware AI Factory, объединяющим VCF с графическими процессорами AMD Instinct и открытой программной экосистемой AMD ROCm. Технология zero-touch provisioning будет оркестрировать сквозное развёртывание всего стека — от vSphere и vSAN до Kubernetes и оператора AMD GPU, — а драйвер AMD DVX сможет подключать графические процессоры к крупным виртуальным машинам, которые использует кластер VMware vSphere Kubernetes Service.
Для дальнейшего упрощения развёртывания VCF AI Factory Broadcom объявила о новом партнёрстве с MetalSoft, в рамках которого будет реализована интегрированная гетерогенная автоматизация работы с «голым железом» для VCF, сокращающая время подготовки физических серверов с недель до минут. Интеграция поможет ИТ-специалистам выделять или переразвёртывать физические серверы разных производителей напрямую через консоль управления VCF, объединяя жизненный цикл программного обеспечения и оборудования в единую операционную модель и снимая необходимость в специфичных для каждого вендора инструментах управления оборудованием и прошивками.
Новые возможности VMware AI Factory
Сервисы VCF Private AI Services помогают сделать AI управляемым, контролируемым и экономически эффективным и входят в состав VMware Cloud Foundation (VCF). Число сервисов, предлагаемых в рамках VCF Private AI Services, будет и дальше расширяться. Рассмотрим эти возможности подробнее.
Доступно в общем релизе
Мультитенантное совместное использование моделей
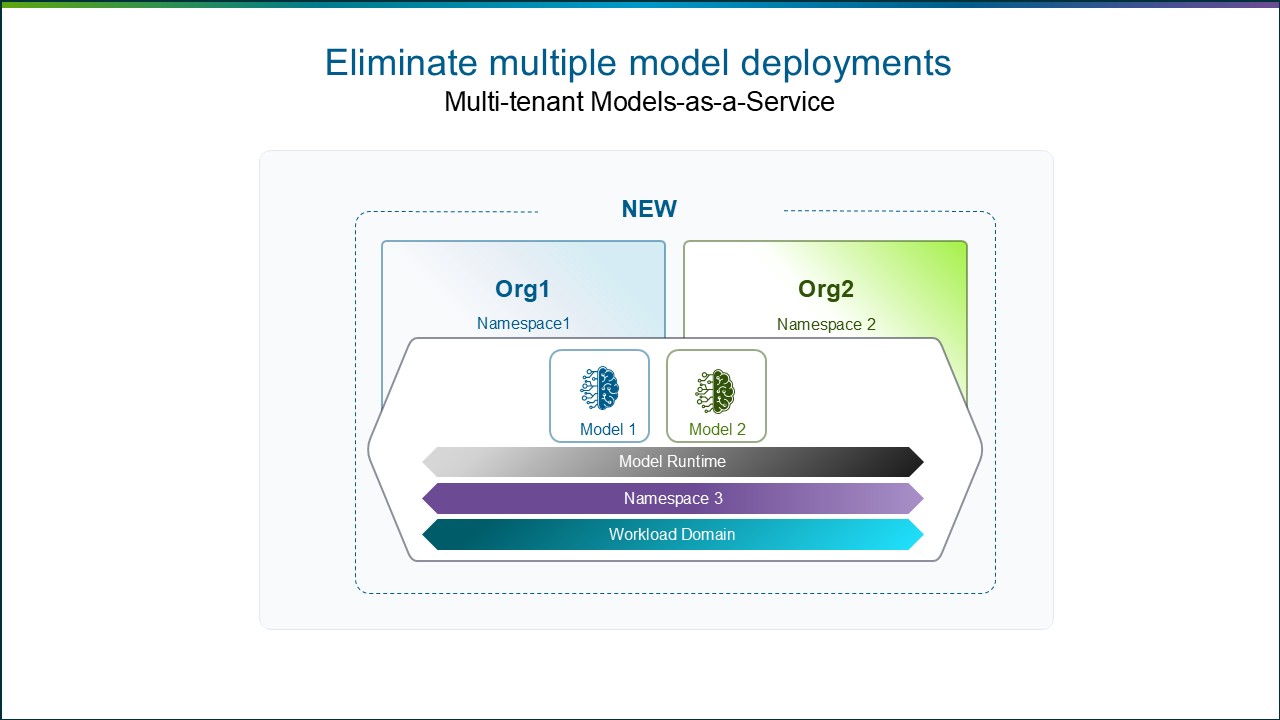
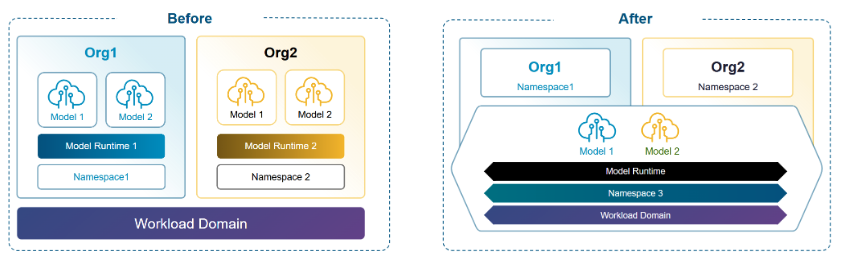
В релизе VCF 9.1.1 компонент Model Runtime был доработан так, чтобы обеспечить безопасное совместное использование AI-моделей между тенантами или отдельными направлениями бизнеса в их пространствах имён при полном сохранении приватности данных каждого из них. На практике это означает, что предприятия и облачные провайдеры теперь могут иметь один запущенный сервис Model Runtime, который обслуживает и масштабирует модели для всей организации, тогда как каждая команда или подразделение располагает отдельным приватным и защищённым пространством имён для своих данных. Эта возможность устраняет необходимость разворачивать избыточные копии модели, впустую расходуя выделенные GPU и инфраструктурные ресурсы. Одновременно сохраняются приватность и изоляция данных при оптимизации совокупной стоимости владения.
Возможности будущих релизов
AI Gateway
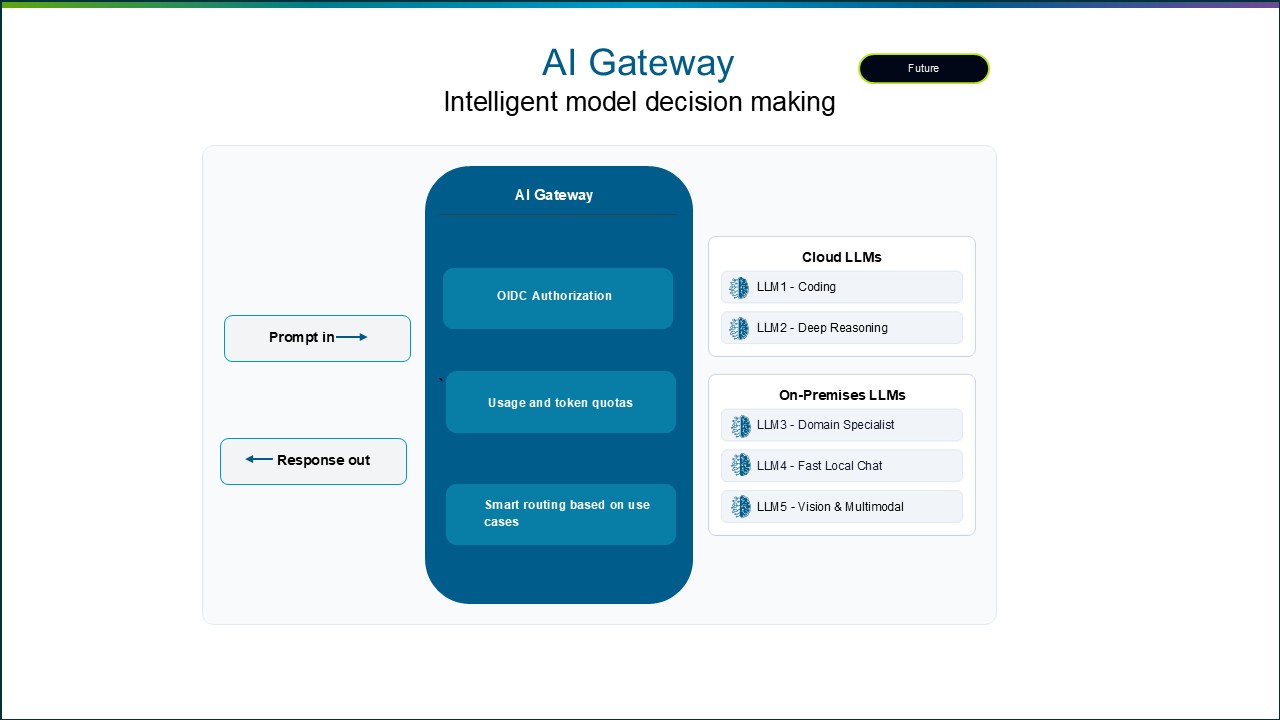
Чтобы сбалансировать сегодняшние потребности в оптимизации стоимости токенов, сценариях использования и производительности, предприятиям нужны модели, развёрнутые и в облаке, и локально. Облачные LLM могут потреблять большое количество токенов, поэтому управление ими приобретает первостепенное значение. Возможность AI Gateway существенно поможет в разрешении этих конкурирующих компромиссов. Вот конкретные детали:
Интеллектуальная маршрутизация промптов: динамически сопоставляет и распределяет входящие запросы между наиболее подходящими локальными или облачными моделями с учётом таких факторов, как сценарий использования, специализация в предметной области и стоимость токенов, — для оптимизации производительности.
Ограничение использования и токенов: ограничение потребления и числа токенов на уровне пользователя помогает минимизировать расход токенов.
Авторизация приложений: определяет приложение, отправившее запрос, до маршрутизации промпта. AI Gateway использует авторизацию на основе токенов OpenID Connect для применения политик доступа.
Secure Agent Framework
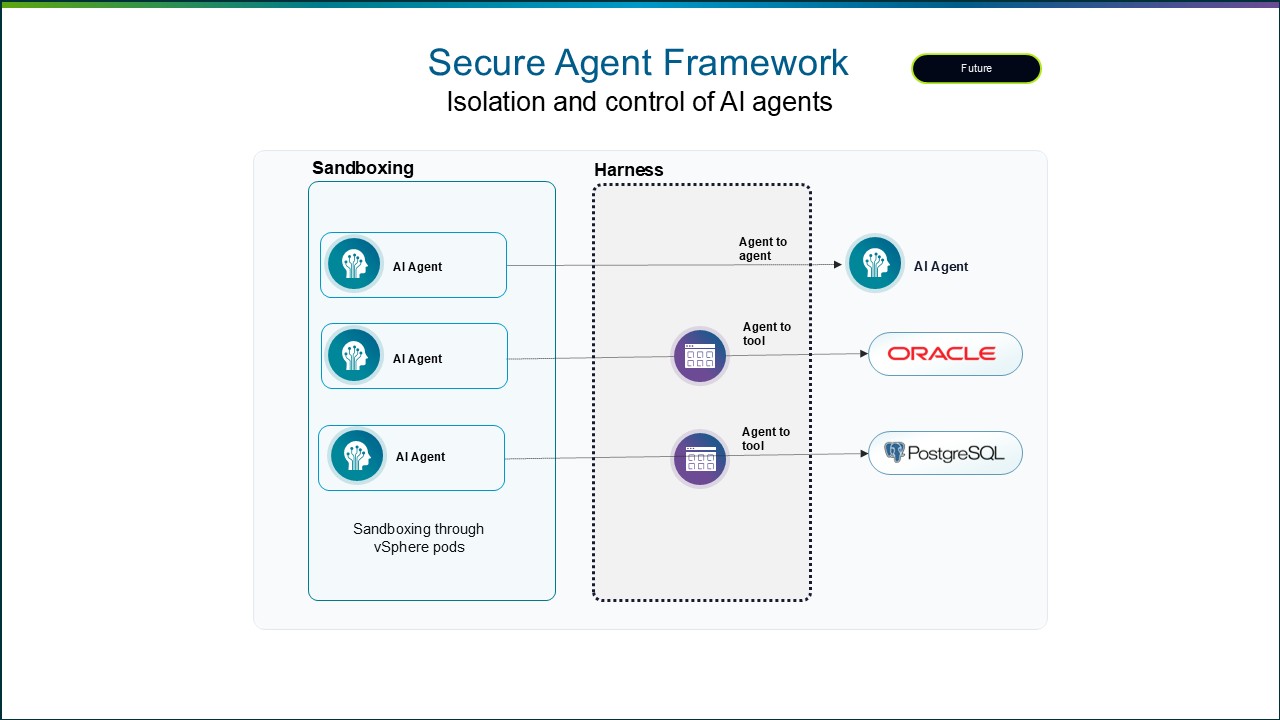
Автономные AI-агенты динамически генерируют и выполняют код, что без строгого контроля создаёт значительные риски безопасности. Бесконтрольный агент — не имеющий детерминированных ограничений на то, к чему он может обращаться, — способен случайно выполнить катастрофические команды, например удалить виртуальные машины или стереть локальные базы данных, как это продемонстрировали тестовые агенты нескольких облачных AI-провайдеров, вышедшие из-под контроля.
Будут выпущены две связанные возможности, обеспечивающие контроль и защитные механизмы для AI-агентов:
Sandboxing: создаёт защищённое виртуализированное контейнерное пространство, в котором динамически сгенерированный агентом код изолируется и исполняется без влияния на остальную среду.
Agent Harness: формирует уровень управления, определяющий, как вызываются агенты, к каким инструментам они имеют доступ, как они взаимодействуют друг с другом и как проверяются результаты их работы, прежде чем по ним будут предприняты действия.
Автоматическое масштабирование моделей
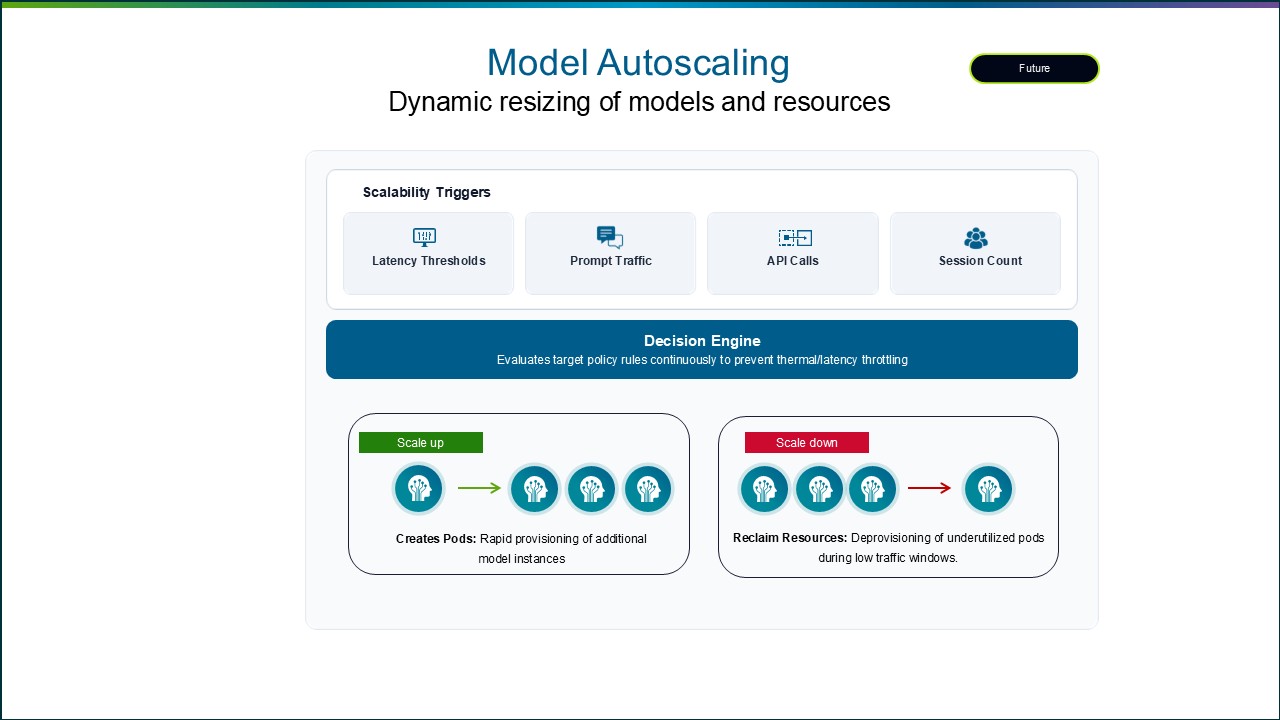
AI-нагрузки не умеют динамически реагировать на внезапные всплески запросов или агентные циклы. Для решения этой проблемы будет представлена возможность Model Autoscaling. С её помощью администратор или AI-оператор сможет задать пороговые значения по задержке и числу сессий, и при их достижении AI-модель будет масштабироваться автоматически, чтобы соблюдались SLA по задержке и производительности. Когда нагрузка опускается ниже порогового значения, рабочая нагрузка масштабируется в обратную сторону.
Благодаря этой возможности предприятия получат прирост производительности и снижение совокупной стоимости владения за счёт событийно-управляемого масштабирования, которое удерживает задержку по токенам на низком уровне, и смогут избежать избыточного выделения ресурсов GPU. Кроме того, организации смогут дополнительно оптимизировать вложения в AI за счёт более эффективного совместного использования дорогостоящих графических процессоров разными рабочими нагрузками.
Другие AI-новинки и анонсы с Explore
Поддержка Broadcom широкого спектра моделей в составе VCF
Стремительно развивающаяся область ИИ требует доступности разных моделей. Потребность в разнообразии AI-моделей вытекает из нескольких конкурирующих факторов: приватность, безопасность, управление, стоимость токенов, а также специализация и экспертиза в предметной области.
Broadcom намерена помогать предприятиям справляться с этими конкурирующими факторами, поддерживая как модели с открытыми весами, так и строго коммерческие решения. VMware AI Factory даёт предприятиям готовый к промышленной эксплуатации путь к запуску ведущих AI-моделей локально. Использование vLLM в качестве среды исполнения моделей по умолчанию позволяет заказчикам запускать на VCF более 150 моделей с открытым исходным кодом с оптимизацией по производительности. Broadcom объявила, что на работоспособность в VCF протестированы следующие модели:
Nemotron 3: семейство открытых мультимодальных моделей NVIDIA Nemotron 3 обеспечивает ведущую точность и эффективность, помогая агентам быстрее выполнять задачи. Сочетание гибридной архитектуры Mamba-Transformer MoE, контекстного окна в один миллион токенов и обучения с подкреплением в нескольких средах позволяет Nemotron 3 поддерживать масштабируемые длительные агентные рабочие процессы в корпоративных приложениях.
Gemma 4: новейшее семейство мультимодальных моделей Google DeepMind с открытым исходным кодом и открытыми весами, созданное специально для разработчиков и исследовательского сообщества, обеспечивающее локальное исполнение и позволяющее предприятиям создавать и разворачивать автономных AI-агентов.
cotomi: проприетарная AI-модель компании NEC, оптимизированная для японского языка и обученная на тщательно отобранных, высоконадёжных наборах данных. Она сочетает высокую скорость обработки с повышением эффективности использования токенов на 40%.
Qwen3.8-27B: разработанная Alibaba модель Qwen3.8-27B — плотная визуально-языковая модель с открытыми весами от команды Qwen. Она подходит для написания кода, профессиональных рабочих процессов, исследований, мультимодального взаимодействия и длительных агентных задач, а режим «размышления» в ней можно включать и отключать. Это нативно мультимодальная плотная модель на 27 млрд параметров, рассчитанная на эффективное локальное развёртывание и коммерческое использование.
GLM 5.2: General Language Model с открытым исходным кодом от Z.ai (ранее Zhipu AI) позволяет предприятиям локально разворачивать агентов для написания кода и рассуждений в многошаговых автономных сценариях с соблюдением суверенитета данных и оптимальной производительностью оборудования.
VCF получила сертификацию NVIDIA: производительность AI-нагрузок подтверждена на уровне, близком к «голому железу»
Недавно NVIDIA запустила программу NVIDIA-Certified Hypervisors. Она удостоверяет, что участвующие в ней гипервизоры обеспечивают для AI- и HPC-нагрузок производительность, близкую к «голому железу».
VMware vSphere 9.1 (и все будущие релизы vSphere 9) получили сертификат NVIDIA-Certified Hypervisor. Таким образом, ИИ- и HPC-нагрузки на VCF теперь официально сертифицированы на работу с производительностью, близкой к «голому железу». Эта сертификация позволяет заказчикам уверенно использовать VCF в качестве оптимизированной по производительности платформы частного облака с поддержкой со стороны основных партнёров экосистемы — для обеспечения работы AI-приложений и приложений ускоренных вычислений в корпоративных центрах обработки данных. Более подробно об этом рассказано в недавно опубликованной статье.
Новые партнёры экосистемы VCF Private AI Services
Работа по укреплению корпоративной экосистемы ИИ продолжается. Помимо развития базовых функций, VCF Private AI Services расширяет охват за счёт новых стратегических альянсов. К числу новых партнёров относятся:
Appian: Appian предоставляет AI-автоматизацию для критически важных задач, автоматизируя сложные процессы в крупных предприятиях и государственных структурах. Платформа Appian известна своей надёжностью и масштабируемостью, подкреплёнными более чем 25-летним опытом в области корпоративных операций. Документация по установке Appian на VCF доступна на этой странице.
ClearML: ClearML предоставляет уровень оркестрации AI, управляющий доступом к GPU, моделями и агентами в рамках VMware Cloud Foundation. Это повышает утилизацию графических процессоров и снижает стоимость выполнения AI-нагрузок, давая предприятиям встроенный путь к модели AI-as-a-Service. Подробнее о ClearML можно узнать здесь.
Eve Security: Eve обеспечивает управление, наблюдаемость и контроль времени исполнения, необходимые предприятиям для безопасного масштабирования AI-агентов. Её агент, встроенный в контур, автоматически проверяет высокорисковую или аномальную активность, обогащает решения контекстом из систем управления идентификацией, DLP и нижележащих систем, а при необходимости применяет средства контроля в реальном времени. Подробнее об Eve Security — здесь.
Solo.io: Solo.io создаёт агентную инфраструктуру с открытым исходным кодом для предприятий, эксплуатирующих AI в продуктивной среде. Среда исполнения kagent и плоскость данных agentgateway дают платформенным командам возможность разворачивать AI-агентов и контролировать каждый вызов модели, инструмента и обращение агента к агенту — на инфраструктуре, которой они владеют и управляют. Дополнительные сведения о сотрудничестве Solo.io и Broadcom приведены в этой статье.
TrueFoundry: TrueFoundry предоставляет AI Gateway корпоративного уровня, объединяющий LLM Gateway, MCP Gateway и Agent Gateway, что позволяет предприятиям подключать, наблюдать и контролировать агентные AI-приложения разных провайдеров из единой плоскости управления. Дополнительные подробности о TrueFoundry доступны здесь.
Недавно в Лас-Вегасе прошла конференция VMware Explore 2026 — со встречами с заказчиками и партнёрами, техническими сессиями и воркшопами. К мероприятию приурочен анонс общей доступности VMware Cloud Foundation (VCF) 9.1.1 — первого maintenance-релиза для ветки VCF 9.1.
Примечание: хотя для maintenance-релизов и экспресс-патчей (EP) жёсткая последовательность установки не задана, для релиза VCF 9.1.1 предусмотрено особое исключение — несколько компонентов необходимо обновлять в строго определённом порядке (соответствующие предварительные проверки уже встроены в релиз). В одном из будущих maintenance-релизов эти исключения будут сняты, но пока о них следует помнить.
Fleet LCM необходимо обновить до 9.1.1 прежде, чем обновлять до 9.1.1 остальные компоненты VCF.
VCFMS необходимо обновить до 9.1.1 прежде, чем обновлять до этой же версии Identity Broker и компонент Salt Master/RaaS.
VCF Automation (VCFA) необходимо обновить до 9.1.1 прежде, чем обновлять компонент VCD Migrator.
Как maintenance-релиз он включает все накопленные исправления ошибок и обновления безопасности из ранее вышедших экспресс-патчей (EP), а также улучшения стабильности платформы и доработки, упрощающие переход на VCF 9.1.
Улучшений в этом релизе много, но ниже разобраны десять, которые заслуживают отдельного внимания.
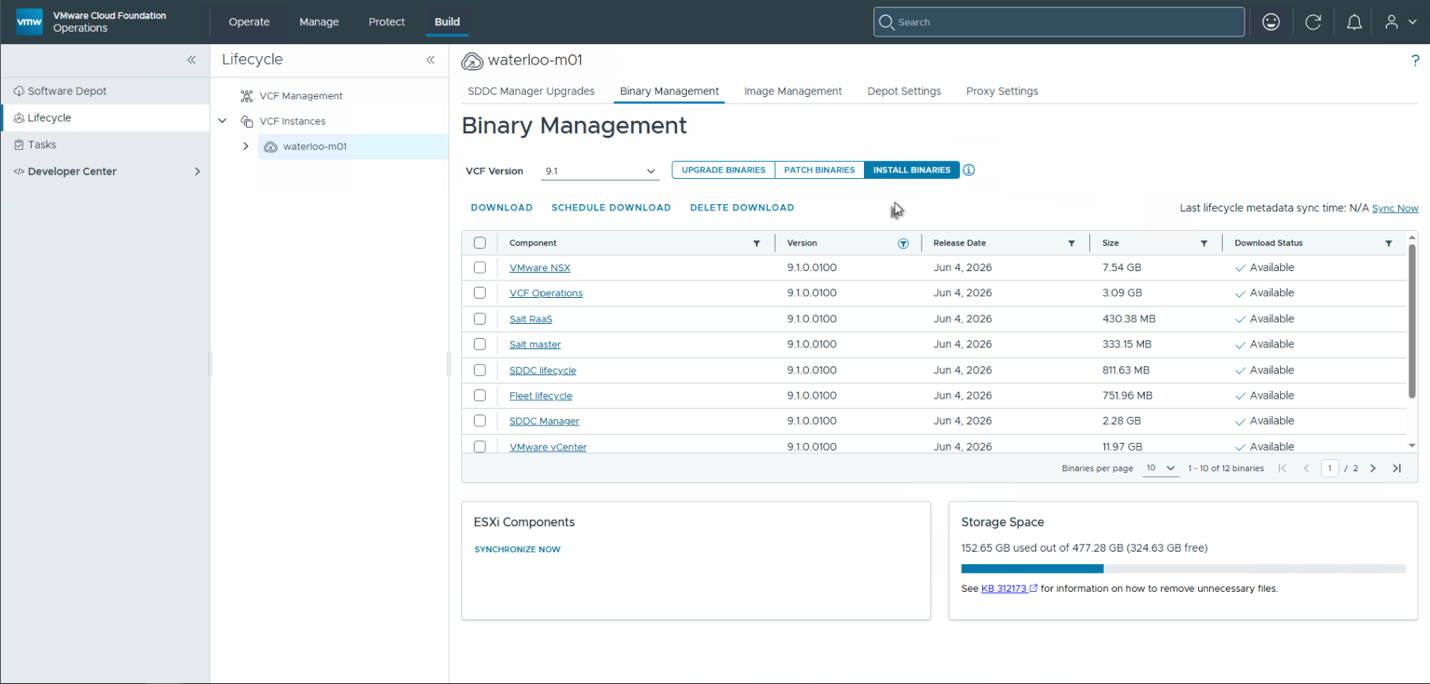
2. Поддержка актуальных версий компонентов VCF в VCF Download Tool (VCFDT)
Экспресс-патчи (EP) для компонентов VCF выходят всё чаще, и определить актуальные версии всех компонентов, необходимых для новой установки или обновления VCF, становится всё сложнее. VCF Download Tool (VCFDT) позволяет без труда узнать последнюю версию отдельного компонента, но с определением актуальных версий по всему программному стеку VCF всё обстояло не так просто.
В VCFDT 9.1.1 задачу упрощает новый флаг --latest: он автоматически отбирает необходимые компоненты VCF в их последних версиях с экспресс-патчами — как для сценария установки, так и для сценария обновления.
Команда для вывода списка последних бинарных файлов VCF 9.1.0, необходимых только для первоначальной установки:
vcf-download-tool binaries list --depot-download-token-file=/Users/lamw/vcf_download_token.txt --vcf-version=9.1.0 --sku=VCF --type=INSTALL --automated-install --latest
Команда для загрузки последних бинарных файлов VCF 9.1.0, необходимых только для первоначальной установки:
3. Поддержка OCI-артефактов, а также образов vSphere Supervisor, VKS и VKR в VCF Download Tool
Унифицированный VCF Software Depot представляет собой единый репозиторий, в котором хранятся все бинарные файлы, используемые развёртыванием VCF, — OVA, ZIP-архивы, PAK-файлы и артефакты в формате OCI. VCFDT остаётся основным инструментом взаимодействия с онлайновым VCF Software Depot: с его помощью загружают содержимое и создают офлайновый VCF Software Depot. Однако одно ограничение сохранялось — инструмент не умел работать с артефактами в формате OCI, включая vSphere Kubernetes Releases (VKR).
В VCF 9.1.1 в VCFDT появилась новая команда artifacts, которая упрощает загрузку сервисов vSphere Supervisor, включая vSphere Kubernetes Service (VKS), и, что особенно важно, релизов vSphere Kubernetes Releases (VKR). Новая команда позволяет выбрать, какие именно VKR нужно загрузить. Раньше подписка на онлайновую библиотеку контента VKR делала доступными для развёртывания сразу все релизы VKR, и у операторов платформы не было простого способа контролировать, какие из них используются.
В составе подкоманды artifacts появился также фильтр по категориям, который позволяет быстро отобрать конкретный тип бинарных файлов для просмотра или загрузки:
SUPERVISOR — обновления управляющего уровня vSphere Supervisor
4. Уменьшенный ресурсный след VCF Management Services (VCFMS)
Когда в VCF 9.1.0 появился компонент VCF Management Services (VCFMS), размеры его виртуальных машин подбирались с расчётом на самый крупный из опциональных сервисов Day-N. Это снижало вероятность того, что при включении дополнительных сервисов потребуется переход на более крупную конфигурацию ВМ. Но в средах, где такие опциональные сервисы Day-N не разворачивались, часть виртуальных машин VCFMS оказывалась больше, чем необходимо.
В VCF 9.1.1 размеры VCFMS оптимизированы под первоначальное развёртывание Day-0. Кроме того, отдельные компоненты VCFMS были дополнительно перенастроены так, чтобы каждый сервис резервировал только те ресурсы, которые ему действительно требуются, — это повышает общую эффективность использования ресурсов. Например, при развёртывании Simple (без высокой доступности) теперь будет на один рабочий узел VCFMS меньше (12 vCPU / 24 ГБ памяти).
У тех, кто обновляет существующее развёртывание VCF 9.1 до версии 9.1.1, текущие размеры VCFMS останутся без изменений. При этом воспользоваться уменьшенным футпринтом VCFMS всё же можно — запустив после обновления скрипт перенастройки размеров, когда все компоненты VCFMS будут обновлены до 9.1.1.
5. Поддержка развёртывания Small HA для VCF Management Services (VCFMS) в VCF Installer
В VCF 9.1.0 конфигурация Small для VCFMS поддерживалась, но была доступна только в модели развёртывания Simple (без высокой доступности). В результате тем, кому требовалась высокая доступность управляющих узлов VCFMS, приходилось разворачивать следующий по размеру вариант VCFMS, обменивая дополнительное потребление ресурсов на повышенную доступность.
В VCF 9.1.1 для VCF Management Services (VCFMS) появился новый вариант развёртывания Small HA: высокой доступности можно добиться, не выходя за пределы ресурсов самой компактной конфигурации.
Если эта возможность используется через JSON API VCF Installer, в качестве значения размера развёртывания в секции vspClusterSpec, описывающей конфигурацию VCF Management Services (VCFMS), указывается small_ha.
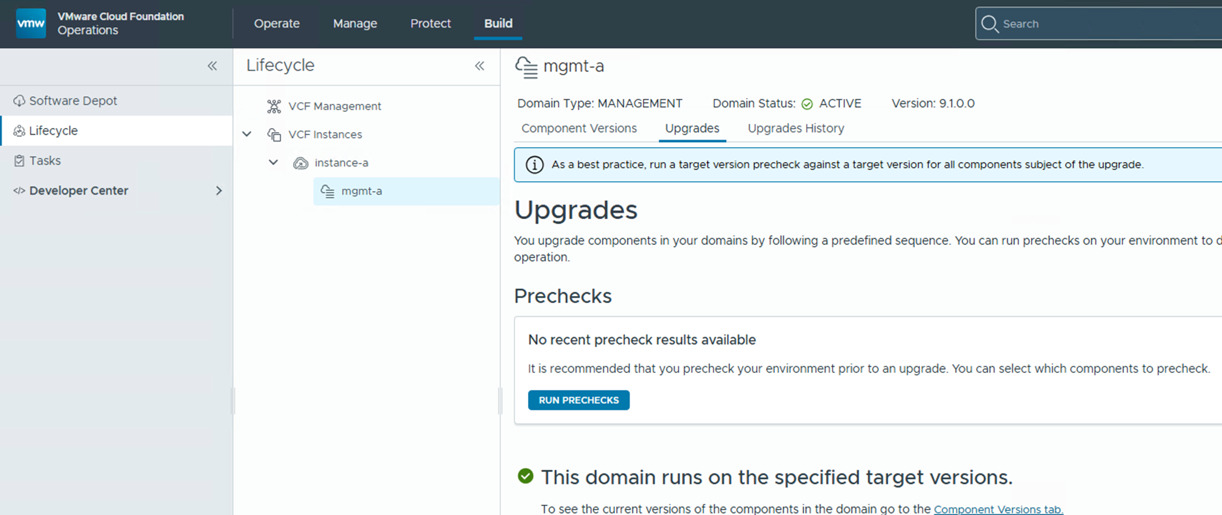
Если VCF Fleet развёрнут в варианте Small без высокой доступности, масштабировать его до Small HA можно как операцию Day-N — через интерфейс VCF Operations в разделе Build > Lifecycle > VCF Management > Components > VCF Services Runtime, выбрав Action > Scale.
6. Поддержка HTTP и произвольного URL для офлайнового депо в интерфейсе VCF Installer
Возможность настроить офлайновый депозиторий VCF через HTTP-эндпоинт, включая поддержку произвольного пути в URL, появилась в API VCF Installer ещё в VMware Cloud Foundation (VCF) 9.1.0. Начиная с VCF 9.1.1 то же самое доступно непосредственно в интерфейсе VCF Installer: средам, которым не нужен HTTPS и/или которые используют собственный URL офлайнового депо, больше не требуется обращаться к API VCF Installer.
7. Поддержка дисков вне HCL vSAN ESA в интерфейсе VCF Installer
В лабораторных и пилотных развёртываниях доступ к NVMe-накопителям, сертифицированным для vSAN ESA, есть далеко не всегда. По умолчанию VCF Installer допускает использование с vSAN ESA только сертифицированных NVMe-устройств. Раньше это поведение можно было переопределить, добавив соответствующую настройку в VCF Installer. Начиная с VCF 9.1.1 поддержка несертифицированных NVMe-устройств с vSAN ESA встроена непосредственно в VCF Installer, и ручная настройка больше не нужна.
Важно: в продуктивных средах VVF и VCF с vSAN ESA поддерживаются только NVMe-устройства, перечисленные в Broadcom Compatibility Guide (BCG).
Для использования этой возможности через JSON API VCF Installer в секцию vsanSpec добавлено новое свойство skipHclAutoDiskClaim. Установка его в true включает то же поведение, что и в интерфейсе VCF Installer.
8. Поддержка развёртывания на одном хосте ESX в интерфейсе VCF Installer
В лабораторных и пилотных средах с ограниченными аппаратными ресурсами выполнить минимальные требования к количеству хостов ESX удаётся не всегда. Хотя обходной путь через переопределение настройки доступен ещё с VCF 5.x, интерфейс VCF Installer всё равно требовал соблюдения минимального числа хостов и блокировал развёртывание даже при заданном переопределении. В результате развёртывание приходилось выполнять через Cloud Builder или JSON API VCF Installer.
Начиная с VCF 9.1.1 интерфейс VCF Installer учитывает такое переопределение, и подобные развёртывания можно выполнять прямо из UI. Для тех, кто только начинает знакомиться с VCF в лабораторных и пилотных средах, это заметно упрощает работу.
9. Поддержка дисков вне HCL vSAN ESA в процедуре ввода хостов в эксплуатацию
При добавлении нового домена рабочей нагрузки VCF или расширении существующего, если в нём используется vSAN ESA, для ввода в эксплуатацию хостов ESX с несертифицированными NVMe-устройствами раньше требовалось дополнительное переопределение настроек. Продолжая линию на упрощение работы, заданную в VCF 9.1.1, ввод хостов ESX в эксплуатацию теперь выполняется прямо из интерфейса vCenter Server или SDDC Manager без этого дополнительного переопределения.
Прежде чем добавлять введённый в эксплуатацию хост ESX с несертифицированными NVMe-устройствами в кластер vSAN ESA, необходимо убедиться, что функция vSAN Managed Disk Claim отключена. По умолчанию она автоматически захватывает сертифицированные NVMe-устройства для использования с vSAN ESA. Несертифицированные устройства требуют ручной обработки, поэтому в противном случае операция будет заблокирована.
Важно: в продуктивных средах VVF и VCF с vSAN ESA поддерживаются только NVMe-устройства, перечисленные в Broadcom Compatibility Guide (BCG).
10. Поддержка VPC на базе VLAN без Overlay Tunnel Endpoint (TEP)
С появлением Distributed Transit Gateway (DTGW) для начала работы с Virtual Private Cloud (VPC) достаточно распределённой группы портов (DVPG) на базе VLAN, однако дополнительно всё равно приходилось настраивать overlay-сеть для Tunnel Endpoint (TEP) между хостами ESX. В VCF 9.1.1 у DTGW появился ещё один вариант — на базе VLAN и без необходимости настраивать сеть TEP на каждом хосте ESX, что сокращает объём конфигурации, требуемой для начала работы с VPC.
Примечание: новый вариант развёртывания VPC на базе VLAN полностью совместим с vSphere Kubernetes Service (VKS) и VCF Automation (VCFA), но имеет ряд ограничений. В их числе — отсутствие приватных подсетей VPC, сервисов SNAT/DNAT/VPN и поддержки протоколов, отличных от IP (например, VRRP и Multicast).
Вслед за успешно прошедшей конференцией VMware Explore в Лас-Вегасе и майским запуском VMware Cloud Foundation (VCF) 9.1 объявлено о переходе в стадию общей доступности версии VCF 9.1.1. Этот релиз развивает возможности VCF 9.1 и приносит усиленную защиту, объектное хранилище vSAN Object Storage (в статусе технического превью, о чём сообщалось ранее), а также новые функции, призванные сделать частное облако лучшей площадкой для запуска AI-нагрузок, управления ими и их защиты — при одновременном снижении совокупной стоимости владения (TCO) и операционной сложности.
Рассмотрим, что нового появилось в этой версии.
Multi-Tenant Model Sharing: безопасное совместное использование AI-моделей
По мере того как организации разворачивают всё больше моделей AI в разных бизнес-подразделениях, они сталкиваются с хорошо знакомым противоречием: команды хотят самостоятельно и без ограничений использовать модели, тогда как MLOps-специалисты и платформенные инженеры обязаны обеспечивать конфиденциальность данных и соблюдение регламентов. Поддержка отдельного стека моделей для каждого тенанта увеличивает затраты и порождает разрастание инфраструктуры.
Механизм Multi-Tenant Model Sharing решает эту задачу, позволяя безопасно делиться моделями между тенантами или отдельными направлениями бизнеса с сохранением конфиденциальности данных. Команды получают доступ к общим моделям без раскрытия чувствительных обучающих данных и без необходимости создавать изолированные инфраструктурные «острова».
Рисунок 1: Multi-Tenant Model Sharing в VMware Cloud Foundation
К операционным преимуществам такого подхода относятся:
Снижение TCO за счёт общей инфраструктуры моделей вместо дублирующих развёртываний для каждого тенанта.
Упрощение операционной сложности благодаря единой плоскости управления доступом к моделям и политиками.
Сохранение конфиденциальности данных за счёт изолированных по тенантам средств контроля доступа.
Именно так выглядит платформа, изначально спроектированная под AI, а не дополненная соответствующими функциями постфактум.
AI Assistant for VCF: диагностика и конструктор management packs
Инфраструктурные команды тратят значительное время на анализ первопричин сбоев и на поиск проблем в смежной инфраструктуре. По мере роста среды до сотен хостов и кластеров Kubernetes эти трудозатраты только накапливаются.
Помощник AI Assistant for VCF берёт на себя диагностику и построение пакетов управления (management packs). Диагностика на базе AI сокращает среднее время устранения неисправностей (MTTR), помогая командам быстрее выявлять первопричины. С помощью AI пользователи могут разбирать инциденты — например, конкуренцию за ресурсы процессора и память на ESX или иные диагностические аномалии — не обладая узкоспециализированными навыками. Другой пример работы помощника при устранении неполадок — совместный анализ множества ошибок vMotion, позволяющий точно определить, почему миграция vMotion даёт сбой в рамках всей среды vCenter.
AI Assistant for VCF также помогает заказчикам создавать интеграции со сторонними продуктами: конструктор контента задействует API для формирования management packs и content packs, которые в противном случае пришлось бы готовить вручную.
Сочетание диагностики на основе AI с более глубокой видимостью сторонних систем позволяет современным частным облакам устранять операционные узкие места, благодаря чему инфраструктурные команды работают на опережение, а не в режиме реагирования на инциденты.
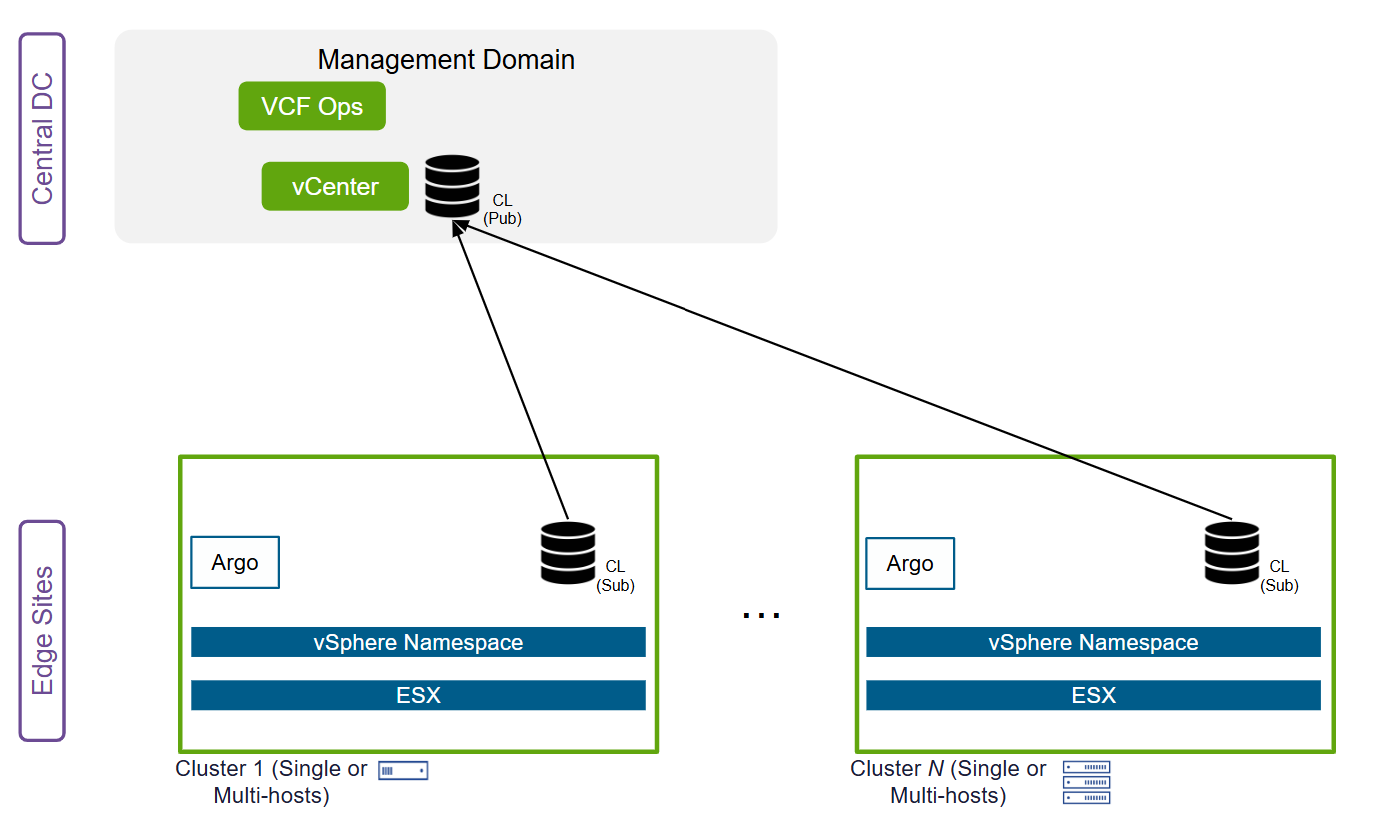
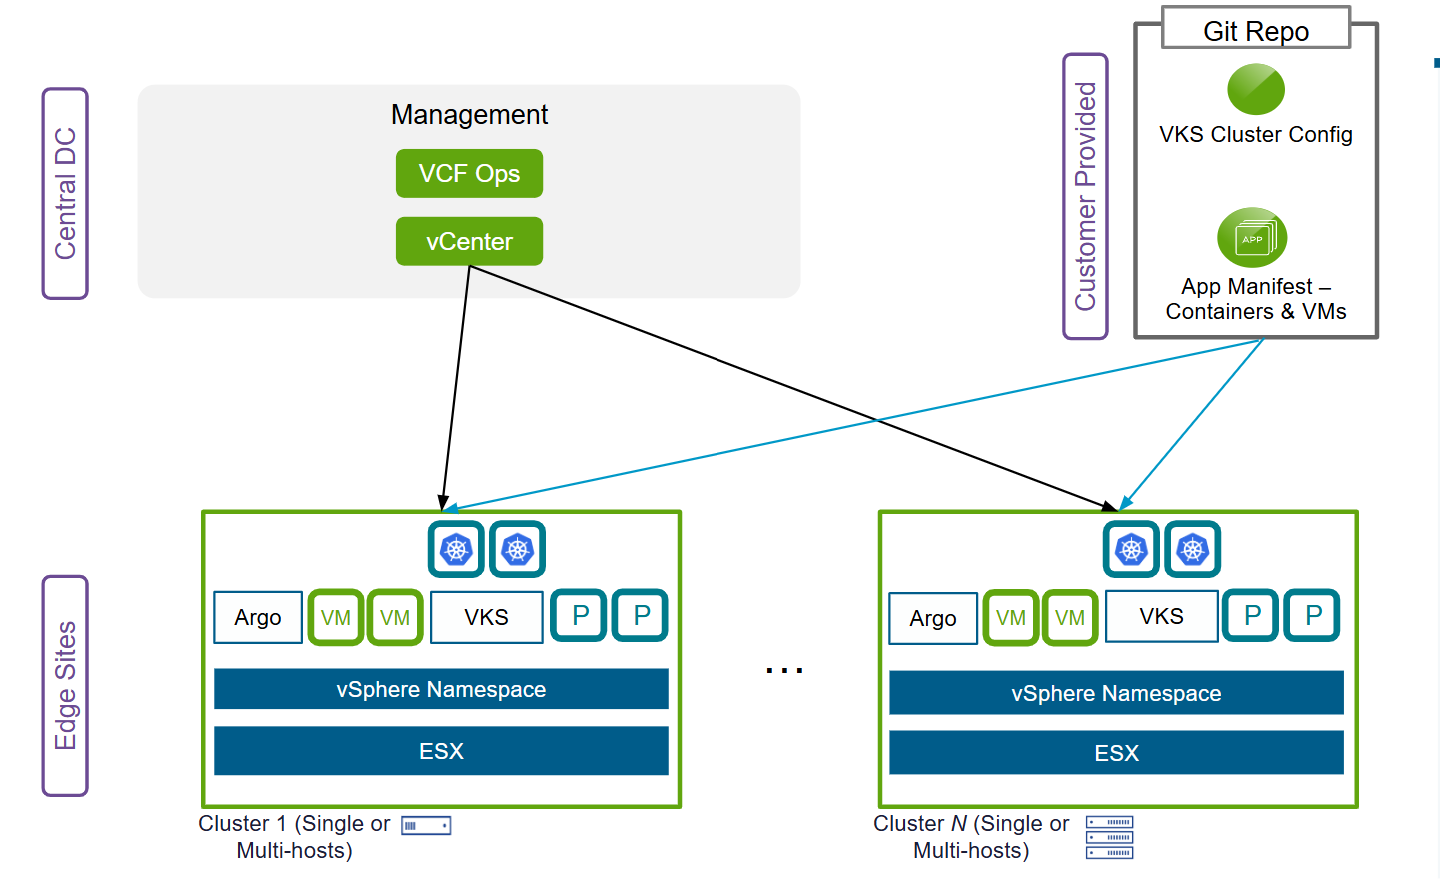
Новый сервис GitOps [техническое превью]: Argo CD внутри VCF
Команды платформенного инжиниринга всё активнее опираются на GitOps для автоматизации развёртывания и управления жизненным циклом. Однако интеграция инструментов GitOps исторически означала работу за пределами управляющей среды VCF, что добавляло сложности в цепочку инструментов и размывало зоны ответственности при поддержке.
Новый GitOps Service (выпущен в статусе технического превью) добавляет Argo CD в качестве нативного GitOps-сервиса в рамках сервисной управляющей среды VCF. Это объединяет развёртывание и управление жизненным циклом непосредственно в интерфейсе VCF Automation, перенося процессы GitOps в ту же операционную плоскость, где находится остальная инфраструктура. Сокращая разрастание инструментария, команды повышают операционную эффективность и отдачу от вложений. Кроме того, сервис GitOps защищает доступ к конвейерам с помощью аутентификации OIDC, интегрированной с VCF Automation.
Командам платформенного инжиниринга предлагается ранний доступ в формате технического превью — чтобы вместе с ними дорабатывать функциональность под масштабы реальных платформенных команд.
По мере роста сред частного облака растёт и сетевая сложность. Сетевые команды сталкиваются с трудоёмкой настройкой, ограничениями производительности и связанными с этим сложностями при диагностике.
Архитектурные улучшения EVPN: проще и масштабируемее
В VCF 9.1.1 появились важные архитектурные улучшения EVPN, включая оптимизированный путь передачи данных между транзитными шлюзами VCF и физической фабрикой для трафика «восток - запад». Прямые туннели VXLAN между транзитным шлюзом и коммутаторами уровня leaf оптимизируют производительность датаплейна для трафика «восток - запад». Помимо этого, сетевые сервисы — NAT, балансировка нагрузки NSX, балансировка нагрузки AVI и DHCP relay — теперь доступны в режиме распределённой связности EVPN VXLAN. В совокупности эти улучшения обеспечивают критически важную мультитенантную и внешнюю связность, а также дают более высокую производительность, более простую конфигурацию и упрощённую диагностику сред EVPN.
Улучшенная совместимость с физической фабрикой означает, что сетевые команды могут проектировать и эксплуатировать более крупные и гибкие сети частного облака без той сложности, которая традиционно замедляла их работу.
Add-on Management Framework в VMware vSphere Kubernetes Service 3.7: уверенность при масштабировании
По мере роста сред Kubernetes разрастается и экосистема дополнительных инструментов — сетевых, средств наблюдаемости, безопасности, хранения данных. Основные трудности проявляются на этапе Day 2: управление жизненным циклом дополнений и устранение возникающих проблем. Ситуацию усугубляет неясность в зонах ответственности за поддержку - непонятно, к кому обращаться, когда что-то ломается. Механизм Add-on Management Framework в vSphere Kubernetes Service (VKS) 3.7 обеспечивает предсказуемую поддержку с прозрачным распределением ответственности и даёт заказчикам свободу выбора при внедрении экосистемных инструментов. Чёткие маршруты поддержки на каждом уровне сокращают время до решения проблемы, давая командам уверенность при масштабировании и скорость для внедрения инноваций.
Следующий шаг
Версия VCF 9.1.1 уже доступна. Для тех, кто уже эксплуатирует VCF 9.1, этот релиз продолжает линию регулярных обновлений с усилением безопасности, удерживающих частное облако на переднем крае AI-инфраструктуры. Для тех, кто пока только оценивает VCF, сейчас лучшее время для перехода.
Передовой искусственный интеллект (frontier AI) коренным образом меняет ландшафт кибербезопасности: он повышает скорость, масштаб и изощрённость атак и одновременно сжимает окно, за которое защита успевает отреагировать. Такие ускоренные векторы атак требуют проактивной защитной позиции. Заказчикам помогают ориентироваться в новом ландшафте угроз с помощью стратегических рекомендаций, изложенных в этом материале.
Усиление защиты частного облака остаётся критически важной задачей, однако из-за внутренней сложности уникальных пользовательских сред универсальные сценарии действий оказываются неэффективными. Понимание текущего положения дел и выявление критических пробелов необходимы, чтобы расставить приоритеты среди наиболее результативных практик, особенно для ИТ-команд, работающих в условиях жёсткого дефицита времени.
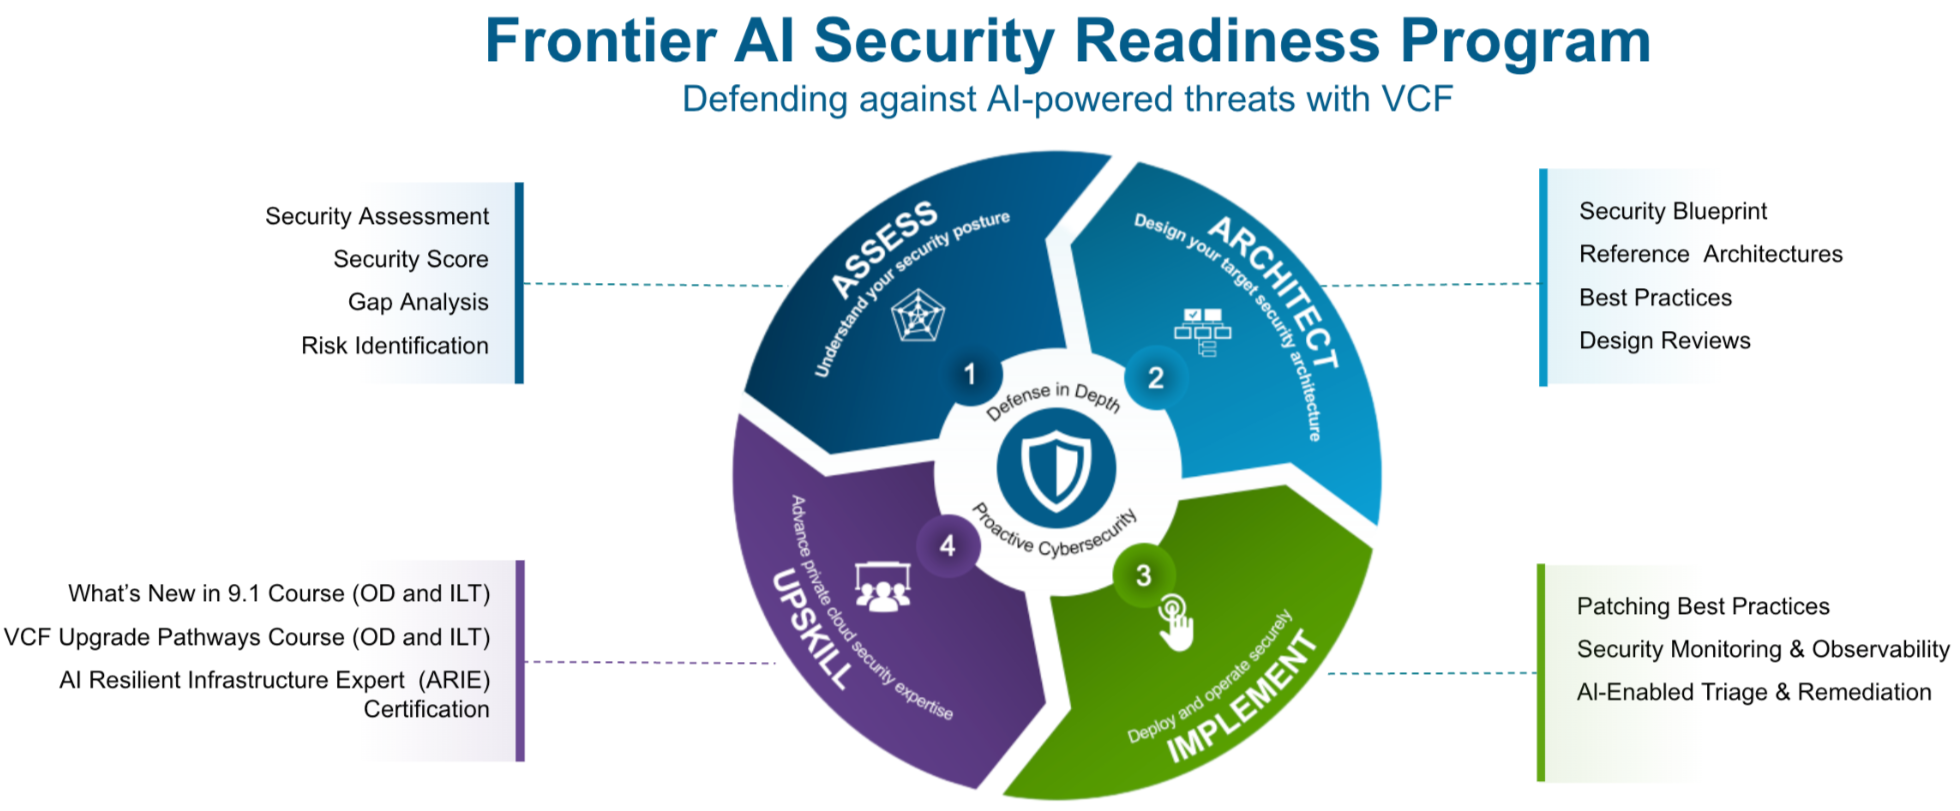
Сегодня по всему миру запускается программа Frontier AI Security Readiness Program, которая предлагает заказчикам направляемую, предписывающую и адаптированную траекторию движения к более устойчивому частному облаку. Эффективная защита от угроз, управляемых AI, требует сквозного, целостного подхода к безопасности, а не разрозненных фрагментарных решений.
Программа объединяет комплексную методологию, состоящую из четырёх взаимосвязанных этапов:
Assess (оценка): количественно измерить экспозицию и пробелы в защитной позиции, чтобы получить базовую линию, основанную на данных.
Architect (проектирование): определить целевое состояние, объединив результаты анализа пробелов с проверенными блупринтами по пяти разрезам.
Implement (внедрение): развернуть усиленные конфигурации, опираясь на бесшовное обновление, непрерывный мониторинг и сортировку инцидентов с помощью AI.
Upskill (повышение квалификации): развить компетенции организации за счёт специализированных учебных курсов по VMware Cloud Foundation (VCF) 9.1 и будущей сертификации AI Resilient Infrastructure Expert (ARIE).
В эпоху передового AI автономные угрозы эксплуатируют задержки с установкой обновлений и нехватку квалификации персонала на машинной скорости. Объединяя технологии, автоматизацию и развитие кадров, эта методология обеспечивает четыре стратегических результата: построение устойчивого частного облака, минимизацию поверхности атаки, быстрое реагирование на уязвимости и поддержание адаптивной позиции безопасности.
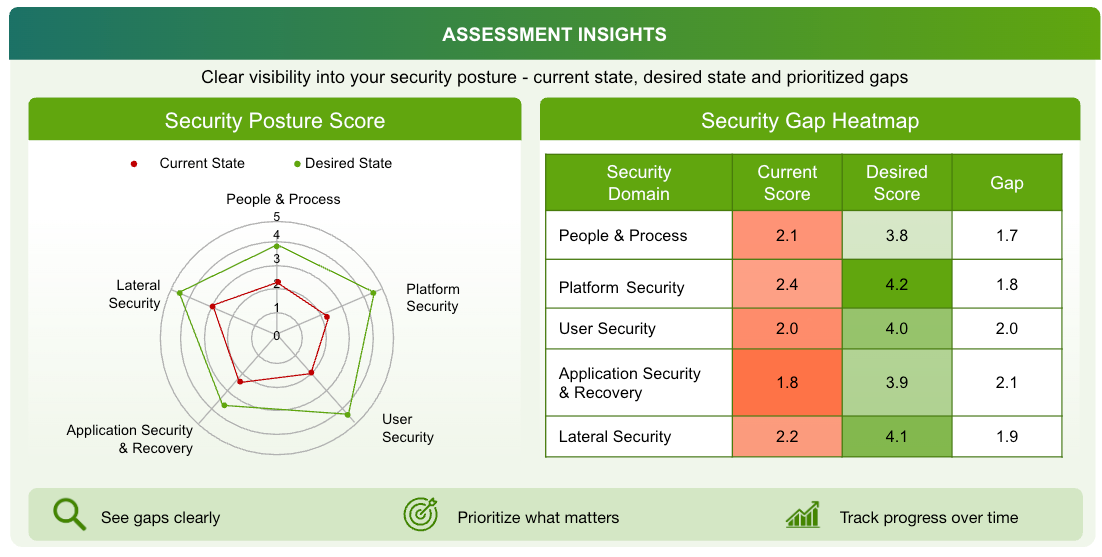
Чтобы построить устойчивое частное облако, первым фундаментальным шагом программы безопасности становится оценка, поскольку нельзя защищать то, что не измерено. Веб-инструмент VCF Security Assessment даёт объективную, основанную на баллах видимость защитной позиции по всему стеку, применяя риск-ориентированную систему оценок, чтобы приоритизировать значимые продуктивные среды и DMZ над менее критичными лабораторными нагрузками.
Защита частных облаков VMware Cloud Foundation (VCF) от управляемых ИИ угроз, действующих на машинной скорости, требует отказа от статических периметров в пользу автоматизированной модели secure-by-design. Лепестковая диаграмма и анализ пробелов, которые формирует опросник оценки безопасности, помогают совершить этот переход: они вскрывают критические уязвимости и дают немедленную визуальную ясность по пяти архитектурным опорам — People and Process, User Security, Platform Security, Lateral Security и Application Security & Recovery. Вооружившись этими данными, организации могут выстроить устойчивую базовую линию платформы, которая минимизирует поверхность атаки, обеспечивает строгий контроль идентичностей, ограничивает горизонтальное перемещение и позволяет быстро восстанавливаться. Тем самым реактивное управление обновлениями превращается в целенаправленную непрерывную защиту, способную выдерживать атаки эпохи Frontier AI.
Этап Architect
После того как базовая линия безопасности установлена, этап Architect переводит сырые результаты оценки в конкретный устойчивый целевой дизайн. Сочетание баллов оценки безопасности и тепловых карт пробелов с VCF Security Blueprints по тем же пяти ключевым разрезам — People & Process, Platform, User, Lateral и Application Security & Recovery — даёт чёткие предписывающие рекомендации. Это обеспечивает точный набор строительных блоков для реализации: от внедрения строгого RBAC и SSO до перехода на VCF 9.1+ ради автоматизированного обновления в рамках жизненного цикла и встраивания базовых сетевых механизмов, шифрования и средств аварийного восстановления.
С точки зрения угроз передового AI такой системный конвейер критически важен. Автономные атакующие движки используют архитектурную несогласованность, дрейф конфигураций и задержки в установке патчей, чтобы связывать эксплойты в цепочки гораздо быстрее, чем команды успевают реагировать вручную. Соединяя данные оценки с чертежами по пяти разрезам для выработки предписывающих рекомендаций, можно устранить догадки при проектировании и обеспечить стандартизированные, жёстко заданные ограничители по всему стеку VCF. Это помогает гарантировать, что архитектура структурно защищена от непрерывных атак, оркестрируемых AI.
Этап Implement
Как только целевая архитектура определена, этап внедрения и эксплуатации переводит безопасность в плоскость повседневных операций через три ключевых вида деятельности:
Развёртывание компонентов по проверенным, усиленным блупринтам
Выполнение бесшовного автоматизированного обновления для поддержания соответствия требованиям
Использование сканеров безопасности для бюллетеней VMware Security Advisories, чтобы быстро приоритизировать уязвимости
Помимо этих базовых активностей интегрируются развивающиеся возможности AI, включая операции с AI-поддержкой, сортировку и устранение проблем силами AI, непрерывное применение политик и аналитику угроз в реальном времени. Эти возможности дают командам силы защищать, обнаруживать и реагировать в нужном масштабе.
С точки зрения угроз передового AI этот операционный фундамент становится передним краем обороны. Автономные атакующие агенты целенаправленно эксплуатируют операционную задержку между публикацией бюллетеня безопасности и установкой патча, выполняя эксплойты на машинной скорости. Чтобы бороться с AI при помощи AI, автоматизированные сценарии обновления, непрерывная аналитика безопасности и анализ первопричин на базе AI сокращают окно уязвимости практически до нуля. Это помогает частному облаку динамически адаптироваться и самокорректироваться, оставаясь устойчивым к современным векторам угроз.
На всех трёх этапах заказчики работают рука об руку со своими системными инженерами (SE) и техническими менеджерами (TAM), либо с партнёрами. Стоит отметить, что VCF Professional Services предлагает набор сервисов, соответствующих этапам программы (Assess, Architect, Implement), а экспертное сопровождение способно заметно ускорить сроки проектов. Подробности о VCF Professional Services можно узнать у своей команды по работе с клиентами.
Этап Upskill
Заключительная опора программы готовности к безопасности сосредоточена на готовности людей и реализуется через специализированное обучение и лидирующие в отрасли сертификации. В эпоху передового AI повышение квалификации сотрудников становится фундаментальным требованием: только так команды смогут грамотно проектировать, эксплуатировать и поддерживать структурно устойчивое частное облако перед лицом эволюционирующих угроз на машинной скорости.
Учебная программа VCF 9.1 даёт глубокое понимание современных путей обновления и функций киберустойчивости, помогая персоналу оставаться в курсе новейших архитектурных ограничителей.
Сертификационный трек AI Resilient Infrastructure Expert (ARIE), скоро
Готовящийся трек ARIE предлагает три целевых учебных маршрута, рассчитанных на структурное усиление защиты платформы VCF:
Специалисты по продажам (4 часа): фокус на свободном владении темой устойчивости к AI, позиционировании VCF как стека безопасности и эффективных стратегиях общения с CISO.
Системные инженеры (около 10 часов): технические погружения во внутреннее устройство DFW, VM-identity, Avi WAF, Live Recovery и VulnOps для защиты на машинной скорости.
Кандидаты VCDX (40 часов): продвинутые лабораторные работы, ведущие к сертификациям VCAP/VCDX, с упором на применение Zero Trust и автономное реагирование на угрозы.
Эти адаптированные маршруты позволяют персоналу получить предписывающую экспертизу, необходимую для защиты стека VCF от современных векторов атак. По завершении специализированной учебной программы команды будут способны:
Проектировать архитектуры Zero Trust в соответствии с методиками NIST, CIS и MITRE.
Обеспечивать защиту рабочих нагрузок средствами микросегментации vDefend, IDS/IPS и Avi WAF.
Использовать Salt для автоматизации непрерывного контроля соответствия и устранения дрейфа конфигураций.
Обеспечивать устойчивость к программам-вымогателям и выполнять быстрое ускоренное восстановление.
С обучением AI Resilient Infrastructure Expert команды не просто узнают о защите современного частного облака. Они получают сертификацию на защиту платформы VCF. Стоит учитывать, что сертификации сгруппированы по нескольким технологическим направлениям и имеют уровни как для новичков в отрасли, так и для экспертов. Подробнее об этом рассказывает страница VMware Certification.
Во-вторых, стоит связаться со своей командой по работе с клиентами или партнёром, чтобы разобраться в предложениях VCF Professional Services, которые помогают ускорить высокоприоритетные ИТ-проекты. Наконец, стоит воспользоваться правами на обучение VCF Learning, чтобы повысить или сменить квалификацию с помощью продвинутых курсов и новых сертификаций VCAP и VCDX, а также следить за анонсом будущего трека обучения и сертификации AI Resilient Infrastructure Expert (ARIE).
Одна мысль звучит от заказчиков VMware постоянно: перенос нагрузок Kubernetes на VMware vSphere Kubernetes Service (VKS) — самый важный шаг на пути внедрения VMware Cloud Foundation (VCF). Долгое время он же оставался и самым трудным для объяснения. У большого числа заказчиков миграция раз за разом всплывала как блокер номер один на пути к VCF. Опасения были реальными и повторяющимися: длинные окна переключения, риск потери данных и методы резервного копирования и восстановления, которые попросту не поспевали за масштабом крупных наборов данных. В отдельных случаях заказчикам приходилось полностью отказываться от старой среды и разворачивать новые кластеры VKS с нуля — только чтобы обойти эту сложность.
Именно эту проблему и взялись решить. За несколько последних месяцев команды профессиональных сервисов, решений и инженерная команда проверили три различных пути миграции на широком наборе исходных топологий: от Tanzu и OpenShift на vSphere до Kubernetes на «голом железе» и облачных дистрибутивов вроде EKS, GKE и AKS. Результатом стал повторяемый плейбук из трёх путей, за которым стоят скрипты, ранбуки и технические документы. Этот материал обобщает четыре документа, кодифицирующих плейбук, и даёт практическую систему выбора нужного пути под конкретную ситуацию. Полный список документов доступен по ссылкам ниже.
OpenShift на «голом железе», облачные Kubernetes, любой сторонний CSI
Методология, общая для всех сценариев
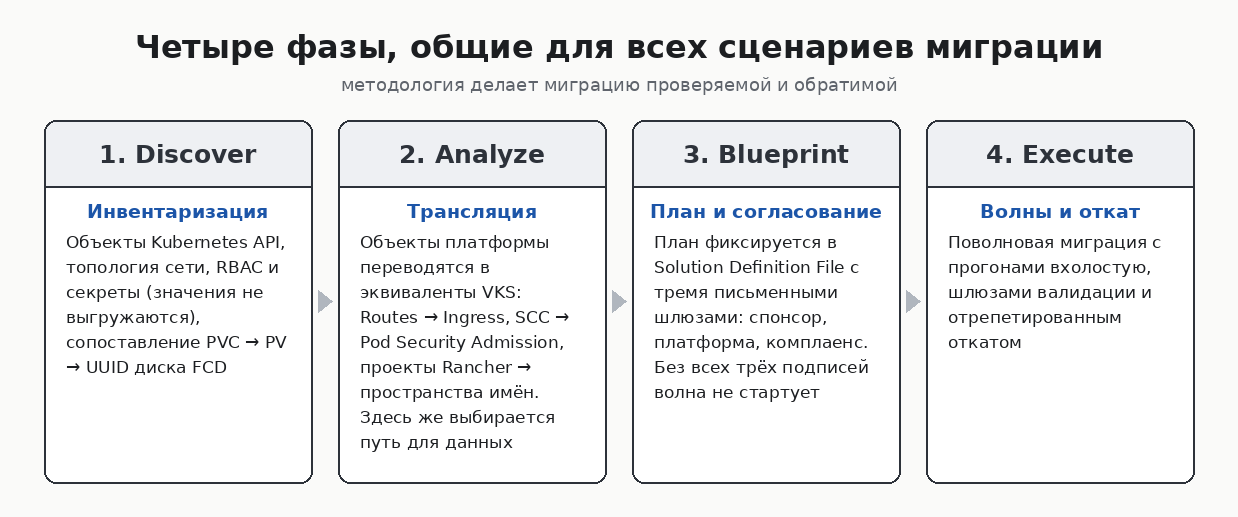
Все четыре документа опираются на один и тот же каркас — четырёхфазную методологию, которая сохраняет миграцию проверяемой и обратимой:
Discover — инвентаризация всего: объекты Kubernetes API, топология сети, RBAC и секреты (значения никогда не выгружаются), а также перекрёстная сверка с FCD в vSphere, сопоставляющая каждый PVC с PV и с UUID диска FCD.
Analyze — трансляция специфичных для платформы объектов в эквиваленты VKS (Routes в OpenShift становятся Ingress, SCC — Pod Security Admission, проекты Rancher — пространствами имён) и выбор пути для данных.
Blueprint — фиксация плана в файле Solution Definition File (SDF) с тремя письменными шлюзами согласования: спонсор, платформа, комплаенс. Ни одна волна не выполняется, пока не подписаны все три.
Execute — поволновая миграция с прогонами вхолостую, шлюзами валидации и отрепетированным откатом.
Различаются ситуации тем, какой путь для данных выбирается на второй фазе: именно он определяет простой, риск потери данных и инструментарий.
Варианты переноса постоянных данных
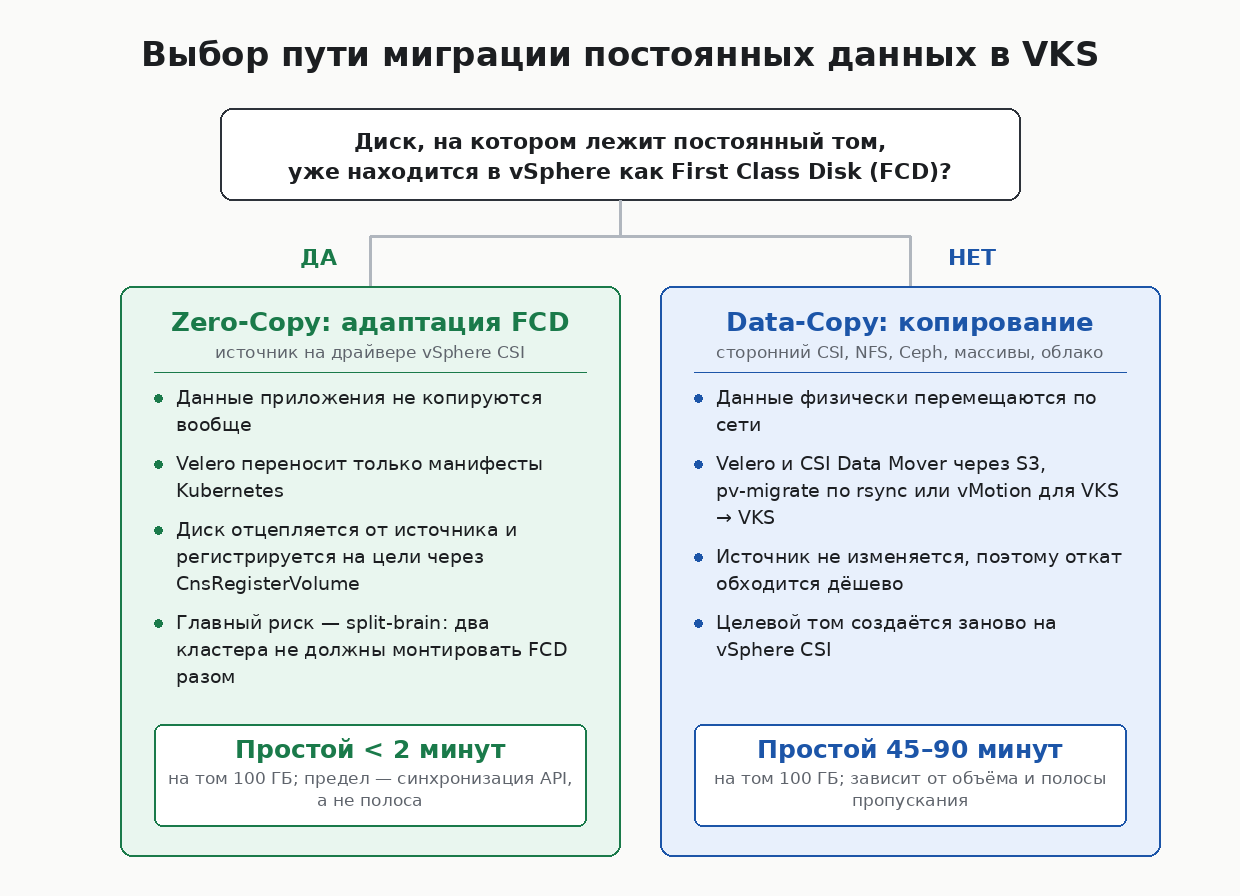
Это самое важное решение в любой миграции на VKS, и сводится оно к одному вопросу: находится ли диск, на котором лежит постоянный том, уже внутри vSphere?
Путь 1: Zero-Copy, адаптация FCD только на уровне метаданных
Применяется, когда источник использует драйвер vSphere CSI, а диск First Class Disk (FCD) присутствует в базе данных vCenter. Данные приложения не копируются вообще. Velero переносит манифесты Kubernetes (PV, PVC и снимки при этом исключаются), а сам FCD отцепляется от источника и заново регистрируется на целевом кластере через CnsRegisterVolume. Всё это время том физически остаётся на том же хранилище данных.
Простой: ограничен синхронизацией API, а не полосой пропускания — менее 2 минут для тома объёмом 100 ГБ.
Риск потери данных: низкий, поскольку копирования нет, но операционный риск вполне реален — опасность в разделении состояния (split-brain). Оба кластера ни в коем случае не должны монтировать FCD одновременно, иначе повреждение данных наступает немедленно. Источник должен быть масштабирован до нуля прежде, чем целевой кластер подключит диск.
Предварительные требования: хранение источника на vSphere CSI; FCD разрешается в vCenter; политика reclaim у PV изменена на Retain до освобождения исходного claim; проверена целостность UUID диска FCD (Storage vMotion между хранилищами может изменить UUID); подключением должен управлять драйвер CSI, а не команда govc disk.attach.
Путь 2: Data-Copy, копирование данных
Применяется, когда хранение реализовано не на vSphere CSI (AWS EBS, Ceph, NFS, облачные блочные хранилища) либо когда FCD в vCenter отсутствует. Данные физически перемещаются через S3-совместимое объектное хранилище с помощью Data Mover для снимков CSI в Velero: встроенный в агент узла движок Kopia выполняет дедупликацию, сжатие, шифрование и выгрузку блоков, а целевая сторона создаёт новый том vSphere CSI и загружает данные в него.
Простой: растёт вместе с объёмом тома и зависит от полосы пропускания — 45–90 минут для тома 100 ГБ. Замеры дали около 24 минут для одного PVC на 450 ГиБ при использовании движка под управлением оператора и около 86 минут для четырёх томов по 450 ГиБ (1,8 ТиБ) параллельно.
Риск потери данных: выше, поскольку данные активно копируются. Но источник при этом не изменяется, поэтому откат обходится дёшево: достаточно удалить целевое пространство имён и заново созданные тома, а источник остаётся главным вплоть до момента переключения.
Предварительные требования: Velero и CSI Data Mover (либо файловое резервное копирование для драйверов без поддержки снимков); общая точка BackupStorageLocation на S3, доступность которой подтверждена с обоих кластеров; сетевая доступность; класс хранения с немедленной привязкой (Immediate) на целевой стороне; MinIO или S3 объёмом не менее 1,2 от самой крупной партии.
Замечание об инструментах: путь с копированием данных использует Velero вместе с Restic или Kopia (либо Data Mover для снимков CSI в составе Velero). Для источников вне vSphere документы описывают также pv-migrate — более прямой инструмент переноса данных «точка-точка» на базе rsync. А для переездов между кластерами VKS в разных vCenter блоки FCD переносит сам vMotion, и этот вариант предпочтительнее и Velero, и pv-migrate, поскольку он уже является частью vSphere.
Какой путь выбрать: руководство по принятию решения
Ниже — практическая рекомендация для каждой ситуации.
Ситуация 1: инфраструктура уже на vSphere (TKG, OpenShift, Rancher, upstream)
Это идеальный случай, и именно на него приходится основной спрос со стороны заказчиков сегодня: более 300 кластеров на vSphere CSI ждут такого переезда. Почти наверняка такая инфраструктура подходит под zero-copy-адаптацию FCD, которая превращает многочасовое окно простоя в считанные минуты. Схема принятия решения из документа выглядит так:
Драйвер хранения — csi.vsphere.vmware.com, и FCD присутствует в vCenter: zero-copy через CnsRegisterVolume.
Любой другой драйвер CSI либо отсутствие FCD в vCenter: копирование данных через Velero с Restic или Kopia.
Обязательно следует сменить политику reclaim у PV на Retain до удаления исходного PVC, проверить UUID диска FCD после любого Storage vMotion и никогда не допускать одновременного монтирования обоими кластерами. Состояние Helm нужно обрабатывать явно. Миграция пространств имён без фильтров исключения сохраняет на целевой стороне секреты релизов Helm (sh.helm.release.v1) и блокирует helm upgrade. Этап 6.5 методологии выполняет сверку или пересборку релиза с ключом --take-ownership.
Рекомендация: по умолчанию выбирать zero-copy. Копирование данных оставить для небольшого набора томов на стороннем хранилище. Рассчитывать стоит на SLA отката менее 10 минут, если что-то пойдёт не так.
Ситуация 2: инфраструктура уже на VKS, перенос между кластерами VKS
Внешне это похоже на первую ситуацию, но нюанс в том, где расположены Supervisor и vCenter.
Тот же vCenter и то же хранилище данных: zero-copy — объекты Supervisor сохраняются, создаётся новый PV в VKS, и всё завершается менее чем за 2 минуты на каждые 100 ГБ.
Разные vCenter: копирование данных, но силами vMotion, а не Velero и не pv-migrate. vMotion переносит блоки FCD нативно, через транспортную оболочку в виде выключенной вспомогательной виртуальной машины, после чего CnsRegisterVolume адаптирует диск на приёмной стороне. Закладывать следует 45–90 минут на каждые 100 ГБ.
Резервное копирование и восстановление томов средствами Velero здесь явно не выбрано как путь: промежуточное хранение в S3 добавляет задержку, которой vMotion избегает.
Два правила для сценария с разными vCenter важнее прочих. Первое: UUID диска FCD сохраняется при миграции, но его всегда необходимо заново обнаруживать после vMotion — нельзя предполагать, что он совпадает с исходным идентификатором, и нельзя передавать исходный UUID в CnsRegisterVolume. Второе: пространству имён на целевом Supervisor нужна политика хранения, назначенная этому FCD и открытая для данного пространства имён, а также трансляция реестра образов и ingress (например, AKO в Contour) через плагины ConfigMap в Velero.
Рекомендация: если оба кластера используют один vCenter и одно хранилище данных, zero-copy тривиален. Если нет — опираться следует на vMotion, а UUID диска FCD рассматривать как величину, которую всегда перепроверяют, а не принимают на веру. Откат ограничен длительностью vMotion, поэтому RTO стоит отрепетировать.
Ситуация 3: инфраструктура на vSphere, но хранение не на vSphere CSI (NFS, Ceph, внешние массивы)
Этот сценарий сбивает с толку чаще всего. Кластер Kubernetes работает на vSphere, поэтому легко предположить, что zero-copy-адаптация FCD доступна. Но постоянные тома обслуживает сторонний драйвер CSI: NFS, Ceph, внешний массив SAN или NAS либо любой другой сторонний плагин хранения. Адаптировать в vCenter нечего, FCD там просто нет, поэтому zero-copy отпадает. Документ формулирует это прямо: реализация хранения на стороне источника не имеет значения для метода переноса, пока исходный PVC является файловым томом, который задание миграции может смонтировать и прочитать.
Рекомендуемый путь — копирование данных через pv-migrate (rsync поверх SSH), тогда как манифесты Kubernetes переносит Velero. Поскольку перенос работает на уровне файловой системы по сети, источнику и приёмнику не нужно иметь общую платформу хранения, общий драйвер CSI и даже общий vCenter. Этот же документ покрывает и полностью не-vSphere источники: методология идентична, потому что абстракция хранения одна и та же.
Простой: растёт вместе с объёмом набора данных, количеством файлов и доступной полосой пропускания — 45–90 минут для тома 100 ГБ.
Риск потери данных: выше, чем при zero-copy, поскольку данные физически копируются, но исходный PVC не удаляется до тех пор, пока волна не принята, — граница отката сохраняется полностью.
Предварительные требования: исходный PVC является файловым томом; pv-migrate (rsync поверх SSH) для данных; Velero для манифестов; Helm для сверки; сетевая достижимость между источником и VKS по TCP 22 до балансировщика нагрузки VKS; класс хранения StorageClass на стороне VKS.
Ключевой принцип: исходный и целевой тома — независимые объекты хранения. Им не требуется общий vCenter, общий домен CNS, общий массив хранения, общий драйвер CSI или общий дистрибутив Kubernetes. Исходный PVC остаётся на месте и обеспечивает возможность отката до тех пор, пока волна миграции не будет принята.
Нюанс по сравнению с первой ситуацией стоит подчеркнуть: работать на vSphere — недостаточно. Решающим фактором является то, лежит ли постоянный том на диске FCD, которым управляет драйвер vSphere CSI. Если нет, то даже когда сам кластер работает на виртуальных машинах vSphere, сценарий относится к территории копирования данных.
Рекомендация: использовать pv-migrate для копирования данных и Velero для манифестов. Заложить окно по полосе пропускания, выполнить инкрементальную синхронизацию перед переключением, чтобы минимизировать финальную дельту, и сохранять исходный PVC до тех пор, пока нагрузка в VKS не пройдёт проверку. Откат чистый: достаточно удалить целевой PVC и создать его заново, источник остаётся нетронутым.
Ситуация 4: инфраструктура вне vSphere (облако, «голое железо», стороннее хранение)
Zero-copy здесь недоступен, потому что в vCenter нет FCD, который можно было бы адаптировать. Копирование данных остаётся единственным путём, а эталонная архитектура на Velero и S3 — проверенный способ его реализовать. Главная мысль этого документа в том, что источники вне vSphere заставляют встретиться с гравитацией данных лицом к лицу, поэтому работа уходит в классификацию и тонкую настройку, а не в изобретательные приёмы с хранилищем.
Каждый объект классифицируется до переключения по одной из трёх проекций: MIGRATE_AS_IS (переносимый, восстанавливается без изменений), REVIEW_REQUIRED (нужен трансформирующий оверлей — Route в Ingress, DeploymentConfig в Deployment, SCC в Pod Security Admission) или BLOCK_MIGRATION (на целевой стороне отсутствует CRD или оператор — сначала установить, либо исключить). Скрипты проверяются по записанным ожидаемым вердиктам, поэтому неверная классификация всплывает как дефект инструментария до переключения, а не как сломанное приложение после.
Предпочтительна установка под управлением оператора: на источнике это OADP в OpenShift. По результатам проверки она оказалась примерно в 4 раза быстрее нативного Velero для одного PVC на 450 ГиБ (24 минуты против примерно 90), потому что плагин CSI, Data Mover и агент узла остаются согласованными по версиям и обновляются как единое целое. На целевой стороне VKS всегда работает нативный Velero.
Ориентироваться следует на ресурсы DataUpload и DataDownload, а не на фазу Backup или Restore: именно ресурсы данных являются источником истины. PartiallyFailed — нормальное конечное состояние для восстановления, и только постпроверочное сканирование вместе с чек-листом приёмки решают, прошла ли партия.
Асимметрия ёмкости: файловые системы вне vSphere (например, CephFS) сообщают всю номинальную ёмкость как доступную, тогда как целевые тома на vSphere CSI с ext4 заранее выделяют таблицы inode (около 1,7%) и резервируют 5% для root. Исходные PVC следует заполнять не более чем на 90%, а целевые PVC для патологически заполненных томов делать больше.
Рекомендация: планировать копирование данных с самого начала. Заложить окно по полосе пропускания, классифицировать объекты заранее, предпочесть установку Velero под управлением оператора и выполнить дельта-партию непосредственно перед переключением, чтобы последние записи источника попали на целевую сторону. Откат обходится дёшево, поскольку источник не изменяется, поэтому фиксироваться следует только в момент переключения.
Сводим воедино: краткая таблица решений
Если источник…
А хранение…
Использовать путь
Простой (100 ГБ)
Основной инструментарий
Kubernetes на vSphere (TKG, OpenShift, Rancher, upstream)
vSphere CSI и FCD в vCenter
Zero-copy
Менее 2 минут
Velero (манифесты) и CnsRegisterVolume
VKS в VKS, разные vCenter
vSphere CSI
Копирование данных через vMotion
45–90 минут
vMotion и CnsRegisterVolume
Kubernetes на vSphere
Сторонний CSI, FCD отсутствует
Копирование данных
45–90 минут
Velero с Restic или Kopia либо pv-migrate
Kubernetes вне vSphere (облако, «голое железо»)
Любое хранение вне vSphere
Копирование данных
45–90 минут
Velero, CSI Data Mover и S3
Несколько правил, действующих для всех четырёх методов
Каким бы ни был выбранный путь, эти правила работают всегда:
Разделять конфигурацию без состояния и хранение с состоянием. Velero переносит манифесты, путь хранения переносит данные. Смешивать их не нужно.
Никогда не обслуживать трафик с обеих сторон одновременно. Перед финальной партией источник нужно остановить или масштабировать вниз, либо выполнить дельта-партию прямо перед переключением. Две расходящиеся живые копии — самый быстрый способ получить повреждение данных.
Сохранять метаданные PVC, принадлежащие приложению (метки и аннотации для Helm и операторов), но никогда не копировать метаданные привязки и выделения, сгенерированные самим Kubernetes: на восстановленной целевой стороне они не совпадут.
Явно обрабатывать состояние Helm. Не удалять вслепую секреты релизов Helm; до переключения извлечь значения и версию чарта из источника и выполнить сверку с ключом --take-ownership.
Проверять до продвижения. Шлюз продвижения контролирует, что PVC находится в состоянии Bound, реплики готовы, а конечная точка проверки состояния приложения отвечает healthy. До перевода волны в стабильное состояние должны пройти все четыре проверки.
Откат всегда репетируется. Zero-copy даёт RTO менее 10 минут, копирование данных даёт дешёвый откат, поскольку источник не тронут. В любом случае RTO нужно знать до переключения.
Итог
Правильная стратегия миграции — та, что соответствует месту, где данные уже находятся. Если тома уже являются дисками FCD в vSphere, zero-copy-адаптация превращает миграцию в операцию с метаданными, измеряемую минутами. Если нет, хорошо настроенный конвейер копирования данных на Velero и S3, с дисциплинированной классификацией объектов и отрепетированным откатом, приведёт к цели столь же безопасно, просто по графику, который упирается в полосу пропускания. А если инфраструктура уже работает на VKS, vMotion вместе с CnsRegisterVolume позволяет переезжать между кластерами вообще без копирования на уровне Kubernetes.
Обратная связь
Описанные пути миграции проверены, но не заморожены. По мере того как всё больше команд будет прогонять их на реальных производственных нагрузках, именно этот опыт отточит следующую редакцию плейбука. Обратная связь здесь по-настоящему важна. Связаться с Broadcom за подробностями можно, используя эту форму.
В стремительно меняющемся ИТ-ландшафте корпоративные ИТ-подразделения сталкиваются с фундаментальной операционной дилеммой. С одной стороны, администраторам VMware vSphere и инфраструктуры необходимы жёсткий контроль, соответствие требованиям, безопасность и мультиарендное управление ресурсами. С другой стороны, разработчикам и DevOps-инженерам нужны гибкость, быстрое самостоятельное выделение ресурсов и нативная инфраструктура, управляемая через API, чтобы ускорить выпуск приложений.
Когда эти два приоритета сталкиваются, операционные проблемы неизбежны. Инфраструктурные команды тонут в бесконечных очередях заявок на развёртывание кластеров и изменение сетевых настроек, а команды разработки, раздражённые задержками, уходят в теневые ИТ или разворачивают изолированные внешние управляющие кластеры. Такая фрагментация не только замедляет инновации, но и порождает серьёзные уязвимости в безопасности, дополнительные операционные издержки и неэффективные расходы.
В недавнем вебинаре Activating VKS Supervisor to Support Kubernetes было показано, как активация управляющего уровня, называемого vSphere Supervisor, в VMware Cloud Foundation (VCF) 9.1 напрямую решает эту дилемму современных приложений.
VMware vSphere Kubernetes Service (VKS) — это среда исполнения Kubernetes, встроенная непосредственно в VCF. Благодаря сертифицированному CNCF дистрибутиву Kubernetes служба VKS позволяет платформенным инженерам разворачивать кластеры Kubernetes, управлять ими и масштабировать их, задействуя при этом весь набор облачных сервисов VCF, а также любые совместимые сторонние сервисы.
Преодоление разрыва: что такое vSphere Supervisor
Корпоративные платформенные команды постоянно испытывают операционное напряжение: разработчикам нужны быстрые API Kubernetes в режиме самообслуживания, тогда как инфраструктурные команды обязаны обеспечивать централизованное управление, безопасность и соблюдение политик по ресурсам.
vSphere Supervisor снимает эти трения, предоставляя настоящее самообслуживание для разработчиков, подкреплённое административным контролем корпоративного уровня, — и всё это работает прямо на существующей инфраструктуре vSphere. Вместо того чтобы строить и обслуживать сложные изолированные управляющие кластеры поверх vSphere, Supervisor встраивает нативный управляющий уровень Kubernetes непосредственно в VMware ESXi и vSphere, превращая гипервизоры в нативные эндпоинты Kubernetes.
Такая архитектура создаёт общую мультиарендную платформу, на которой гармонично работают и инфраструктурные администраторы, и разработчики:
Для администраторов vSphere: контроль и соответствие требованиям сохраняются за счёт пространств имён vSphere Namespaces. Администраторы задают границы ресурсов (квоты на CPU, память и хранилище), назначают ролевую модель доступа (RBAC) и сохраняют полную операционную видимость через vSphere Client и VMware Cloud Foundation Operations.
Для DevOps-инженеров: платформа предоставляет стандартную конечную точку API Kubernetes. Инженеры могут применять декларативные YAML-манифесты через kubectl и Helm, чтобы разворачивать кластеры рабочих нагрузок (кластеры VKS), виртуальные машины (через VM Service) и контейнеризованные нагрузки прямо внутри выделенных им пространств имён vSphere.
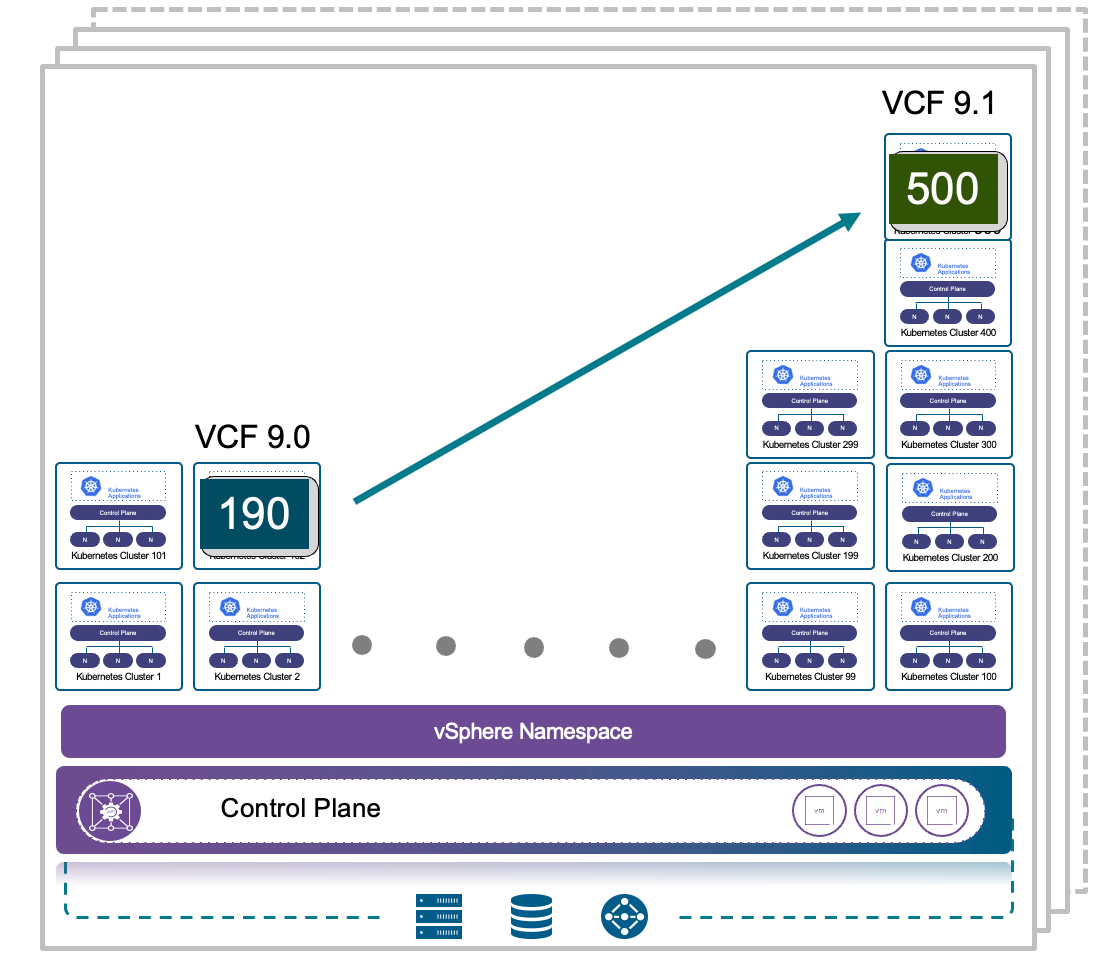
В VCF 9.1 развязанное управление жизненным циклом позволяет платформенным командам обновлять и патчить версии Kubernetes независимо от обновлений самой платформы. В сочетании с серьёзной оптимизацией движка VKS платформа обеспечивает развёртывание кластеров до 70% быстрее, обновления до 75% быстрее и масштабирование до 500 кластеров на один экземпляр управляющего уровня.
Архитектура vSphere Supervisor и высокая доступность
Архитектура vSphere Supervisor спроектирована так, чтобы обеспечивать отказоустойчивость корпоративного уровня за счёт встраивания нативного высокодоступного управляющего уровня Kubernetes непосредственно в слой гипервизора vSphere. Управляющий уровень vSphere Supervisor состоит из трёх активных виртуальных машин управляющего уровня Kubernetes, развёрнутых на хостах ESX или в мультизональных кластерах vSphere, что обеспечивает непрерывный кворум и отсутствие единых точек отказа. Эти виртуальные машины напрямую взаимодействуют с vCenter и ESX, управляя жизненным циклом рабочих нагрузок, распределением ресурсов и согласованием состояния во всей среде.
На низком уровне примитивы хранения и вычислений тесно связаны между собой, что помогает обеспечить высокую доступность. Алгоритм размещения управляющего уровня динамически распределяет виртуальные машины по доменам отказа, а временные данные обслуживаются через эфемерные диски (Ephemeral Disks), которые автоматически очищаются при завершении работы пода. Кроме того, диски с образами контейнеров кэшируются непосредственно на отдельных хостах ESX, что позволяет обойти задержки загрузки из реестра и обеспечить практически мгновенное создание подов и их восстановление при отказе хоста.
Топологии хранения и управление политиками
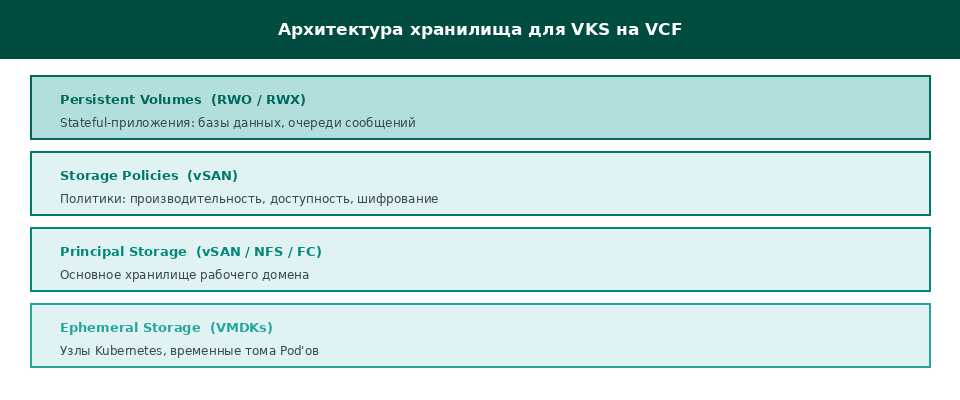
Приложениям с сохранением состояния, построенным по облачно-нативным принципам, требуется надёжная работа с постоянным хранилищем. vSphere Supervisor связывает запросы Kubernetes на постоянные тома с примитивами хранения vSphere через Cloud Native Storage (CNS) и нативный драйвер vSphere Container Storage Interface (CSI).
Когда разработчик отправляет запрос PersistentVolumeClaim (PVC), драйвер CNS-CSI напрямую обращается к vCenter и транслирует этот запрос в диск First Class Disk (FCD) на нижележащем хранилище. Администраторы обеспечивают управляемость, назначая политики хранения (например, Gold, Silver) и лимиты ёмкости непосредственно пространствам имён vSphere.
vSphere Supervisor поддерживает три различные топологии хранения, рассчитанные на конкретные требования рабочих нагрузок:
Хотя чаще всего в качестве примера приводится гиперконвергентный vSAN, традиционные внешние массивы хранения (Fibre Channel, iSCSI и NFS) отображаются на те же самые топологии. Стандартные внешние хранилища SAN/NAS, подключённые к одному кластеру vSphere, работают как зональные хранилища (Zonal Datastores). В мультизональных развёртываниях заказчики, использующие репликацию на уровне сторонних массивов — например, метрокластеры хранения на базе FC/iSCSI, — могут добиться доступности межзональных хранилищ (Cross-Zone Datastore) без применения нативного растянутого кластера vSAN.
Помимо постоянного хранилища vSphere Supervisor управляет дисками управляющего уровня, эфемерными дисками (автоматически уничтожаются при удалении пода) и кэшированием образов контейнеров непосредственно на хостах ESX, что обеспечивает практически мгновенный запуск подов.
Сеть и балансировка нагрузки в vSphere Supervisor
Сетевая подсистема и балансировка нагрузки в vSphere Supervisor построены вокруг развязанной, хорошо масштабируемой модели виртуального частного облака (VPC), реализованной через системные проекты VMware NSX и централизованные транзитные шлюзы. Каждое пространство имён vSphere работает внутри собственного выделенного NSX VPC с приватными подсетями и шлюзами VPC, которые изолируют нагрузки арендаторов и устраняют конфликты IP-адресов, даже если разные команды используют пересекающиеся блоки CIDR.
Маршрутизация трафика между пространствами имён, управляющими сетями и внешними сервисами обеспечивается транзитными шлюзами Tier-0 и Tier-1, что помогает организовать безопасную и высокопроизводительную транзитную передачу по сетевой фабрике. Для балансировки нагрузки и входящего трафика vSphere Supervisor интегрируется с VMware Avi Load Balancer. Эта интеграция автоматизирует выделение и управление жизненным циклом виртуальных IP-адресов (VIP), балансировщиков для конечной точки API Kubernetes и контроллеров ingress уровней L4/L7, обеспечивая точное управление трафиком, полностью автоматическую настройку сети и глубокую изоляцию по безопасности без ручного вмешательства в сетевую конфигурацию.
Современная сеть: NSX VPC и транзитные шлюзы
Организация сети в мультиарендных контейнерных платформах традиционно вызывала значительные трудности, нередко приводя к исчерпанию IP-адресов, усложнению маршрутизации на межсетевых экранах и рискам безопасности.
vSphere Supervisor решает эту задачу, сочетая виртуальные частные облака NSX (VPC) с гибкими схемами транзитных шлюзов в системных проектах NSX. Хотя в демонстрации на вебинаре был показан вариант с централизованным транзитным шлюзом, vSphere Supervisor в полной мере поддерживает и распределённые транзитные шлюзы, что позволяет выбрать модель подключения, наиболее подходящую конкретной среде.
Ключевые возможности этой сетевой архитектуры:
Изолированные VPC для каждого пространства имён: каждое пространство имён vSphere изолировано внутри собственного NSX VPC с приватными подсетями и выделенными шлюзами VPC.
Отсутствие конфликтов IP и развязанная маршрутизация: развязанная маршрутизация между VPC позволяет разным командам разработки использовать пересекающиеся диапазоны IP без сетевых коллизий.
Линейная масштабируемость: централизованные транзитные шлюзы безопасно обрабатывают высокоскоростную маршрутизацию между пространствами имён и во внешние сети через шлюзы Tier-0/Tier-1.
Встроенная балансировка нагрузки: Avi Load Balancer автоматизирует маршрутизацию трафика через контроллер ingress и балансировку API Kubernetes.
Пошаговая активация и сценарий демонстрации
В демонстрационной части вебинара был показан полный сквозной жизненный цикл развёртывания — как со стороны администратора, так и со стороны разработчика.
Наблюдаемость на этапе Day-2: вся телеметрия, метрики производительности и логи поступают напрямую в централизованный VCF Operations для проактивного мониторинга и операций жизненного цикла.
Предварительные требования и запуск активации: перед запуском активации Supervisor необходимо убедиться, что выполнены базовые требования: действующий домен рабочих нагрузок VCF с включёнными vSphere HA и DRS, сетевая конфигурация на базе NSX или распределённого коммутатора vSphere с назначенными пулами IP-адресов, поддерживаемый балансировщик нагрузки, выделенная политика хранения vSphere и подписная библиотека контента (Subscribed Content Library). После этого активацию можно инициировать при создании домена рабочих нагрузок в VCF Operations либо уже после развёртывания непосредственно в vCenter в разделе Supervisor Management -> Get Started, где мастер перед развёртыванием проверяет вычислительные зоны, политики хранения, библиотеки контента и настройки балансировки нагрузки.
Настройка пространства имён и RBAC: администратор виртуальной инфраструктуры создаёт пространство имён vSphere, назначает политики хранения и квоты ресурсов, а также выдаёт права доступа разработчикам.
Декларативное развёртывание: DevOps-инженер аутентифицируется на управляющем уровне vSphere Supervisor через kubectl и применяет YAML-манифест с запросом на новый кластер VKS. vSphere Supervisor автоматически разворачивает узлы управляющего уровня и рабочие узлы.
Двойная перспектива наблюдения: администратор виртуальной инфраструктуры отслеживает состояние инфраструктуры и объекты виртуальных машин в vSphere и VCF Operations, тогда как разработчик управляет подами, сервисами и развёртываниями через kubectl.
Развёртывание гибридного приложения: команды разворачивают многоуровневые приложения, объединяющие виртуальные машины (через API службы VM Service) и контейнеризованные нагрузки на базе Helm-чартов.
Заключение и что дальше
Активация vSphere Supervisor превращает традиционную корпоративную виртуализацию в мощную мультиарендную облачную платформу. Предоставляя разработчикам нативное самообслуживание Kubernetes и одновременно оставляя ИТ-администраторам полный контроль над ресурсами и политиками, VKS ускоряет выпуск современных приложений без роста операционных рисков.
Учебные курсы: войдите в Learning@Broadcom через портал поддержки Broadcom, раздел «Education Portal», чтобы получить доступ к следующим курсам по VKS:
Если по проектам VKS нужна помощь, обратитесь к своему аккаунт-менеджеру Broadcom, чтобы узнать, чем могут помочь профессиональные сервисы VCF и партнёры, такие как TeraSky.
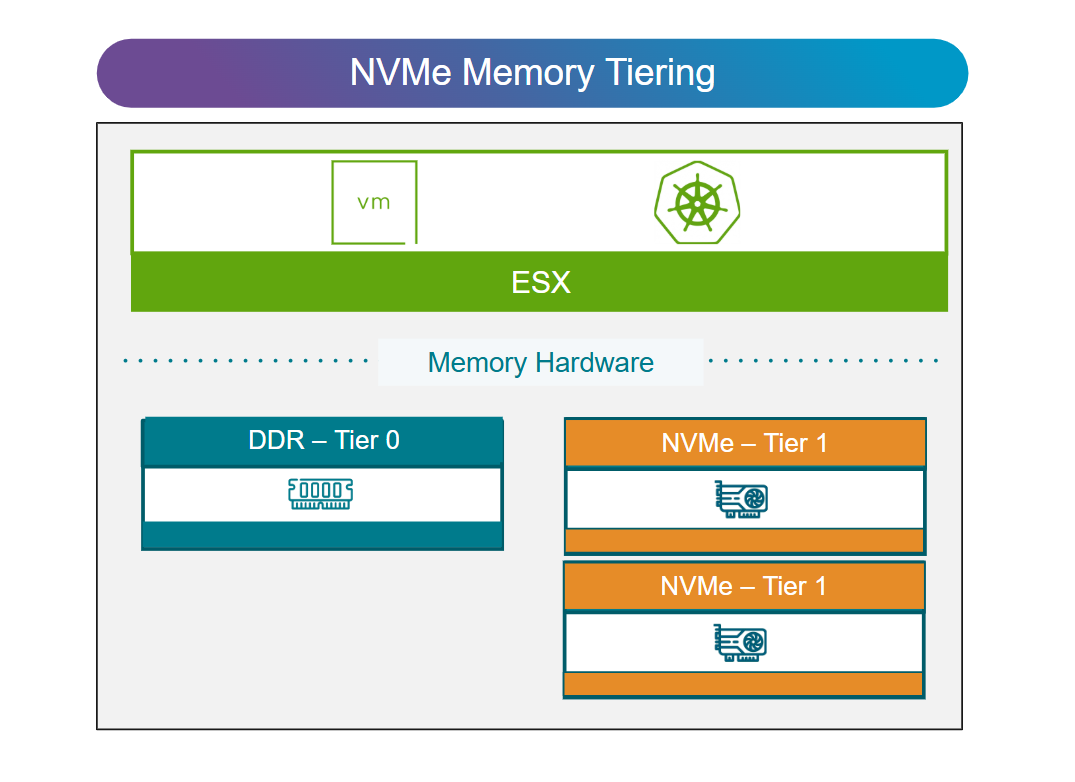
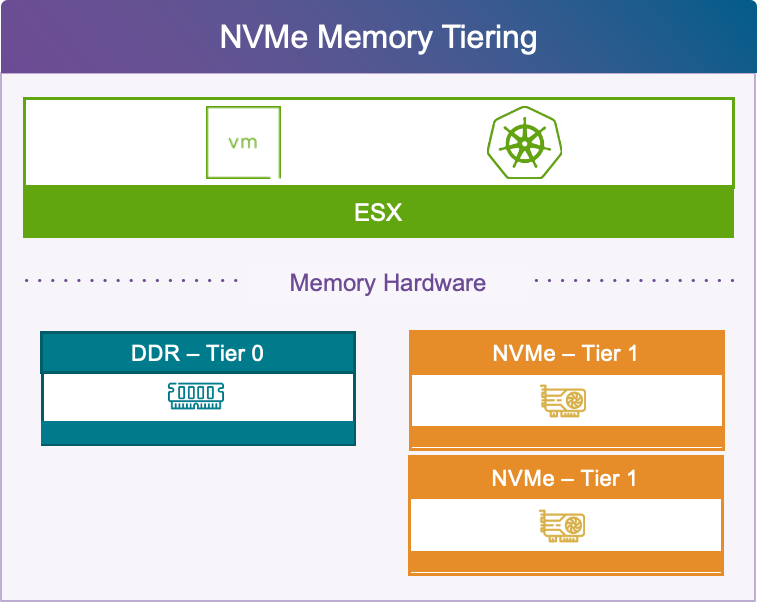
Механизм Memory Tiering в VMware Cloud Foundation 9 использует два типа устройств памяти, чтобы нарастить её объём при существенно меньшей стоимости. Технология незаметно для виртуальных машин отслеживает активность обращений к памяти и удерживает часто используемые данные в быстрой и дорогой DRAM, вытесняя редко запрашиваемые страницы на второй, более медленный и дешёвый уровень на NVMe-накопителе.
Память нередко оказывается самой дорогой составляющей в стоимости сервера, а современные приложения потребляют её всё больше: растут объёмы данных, усложняются вычисления, добавляются требования к работе в реальном времени. При этом в продуктивных средах администраторы обычно избегают переподписки памяти из-за непредсказуемой деградации при срабатывании механизмов её возврата — ballooning, сжатия или свопинга. Эти техники не обладают интеллектом Memory Tiering и не умеют грамотно распоряжаться активной памятью, поэтому виртуальным машинам выделяют полный требуемый объём. Решение рабочее, но неэффективное: одновременно используется далеко не вся выделенная память, и дорогой ресурс простаивает.
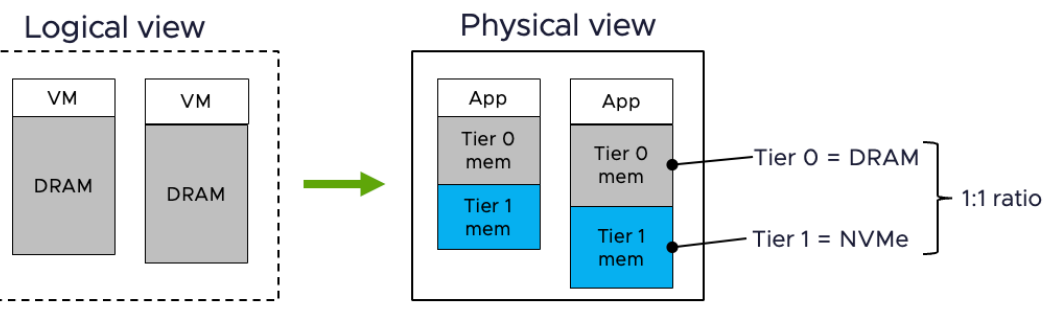
В VCF 9.0 Memory Tiering предоставляет виртуальным машинам единое логическое пространство памяти, а под капотом управляет двумя её типами в зависимости от активности обращений:
Tier 0 — высокоскоростная DRAM: дорогая и очень быстрая системная память, где остаётся активная, «горячая» память.
Tier 1 — устройства NVMe: производительные SSD, более медленные и заметно более дешёвые, куда переносится неактивная, «холодная» память.
После включения тиринга информация о нём доступна в интерфейсе VMware vCenter: вкладка Configure > Hardware > Overview > Memory. Там отображается суммарный объём памяти и его распределение по уровням — например, 1 022,93 ГБ всего, из которых 511,46 ГБ приходится на Tier 0 и столько же на Tier 1. Настройка описана в документации vSphere, а бизнес-обоснование технологии разобрано в блоге VMware Cloud Foundation.
Архитектура
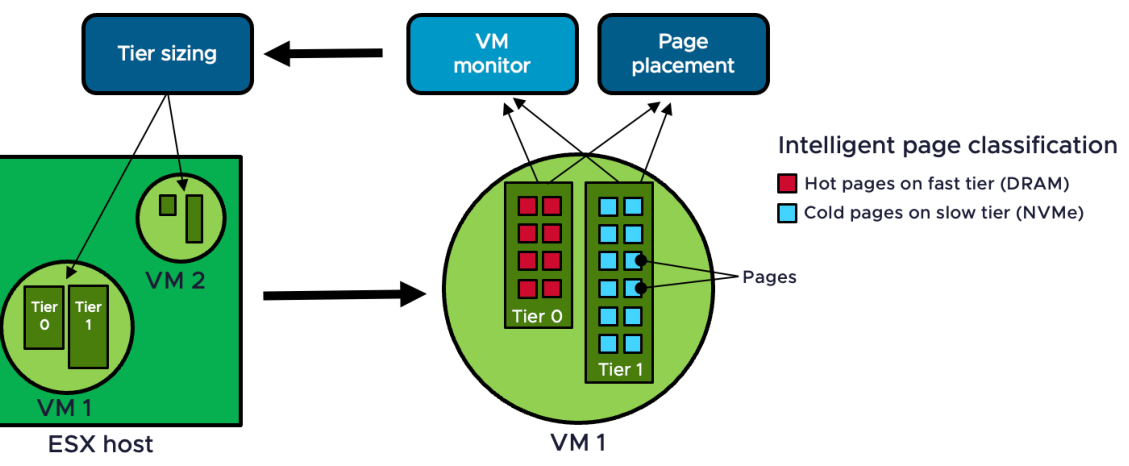
В систему добавлен модуль классификации и размещения страниц памяти. Он периодически обходит всю гостевую память, динамически вычисляя активность гостя, пропускную способность каждого уровня, квоты уровней для виртуальных машин и пороги активности страниц. Планировщик памяти опирается на эти показатели вместе с историей активности каждой гостевой страницы и размещает страницы на подходящем уровне.
Работа идёт в фоне. Механизм наблюдает за обращениями к памяти и определяет, какие страницы горячие, а какие холодные в заданном временном окне: например, горячими считаются те, к которым чаще всего обращались в течение последней минуты, — они остаются в DRAM, остальные уходят на NVMe. Классификация постоянно пересматривается: когда нагрузки проходят через смену фаз и активными становятся другие участки памяти, тиринг перераспределяет страницы, поддерживая эффективную загрузку DRAM.
Методика тестирования
Для оценки была смоделирована продуктивная среда на VCF 9.0 с включённым тирингом, на которой запускались популярные корпоративные бенчмарки, нагружающие процессор, память, хранилище и сеть.
Бенчмарк
Нагрузка
Результат
Login Enterprise
Приложения VDI
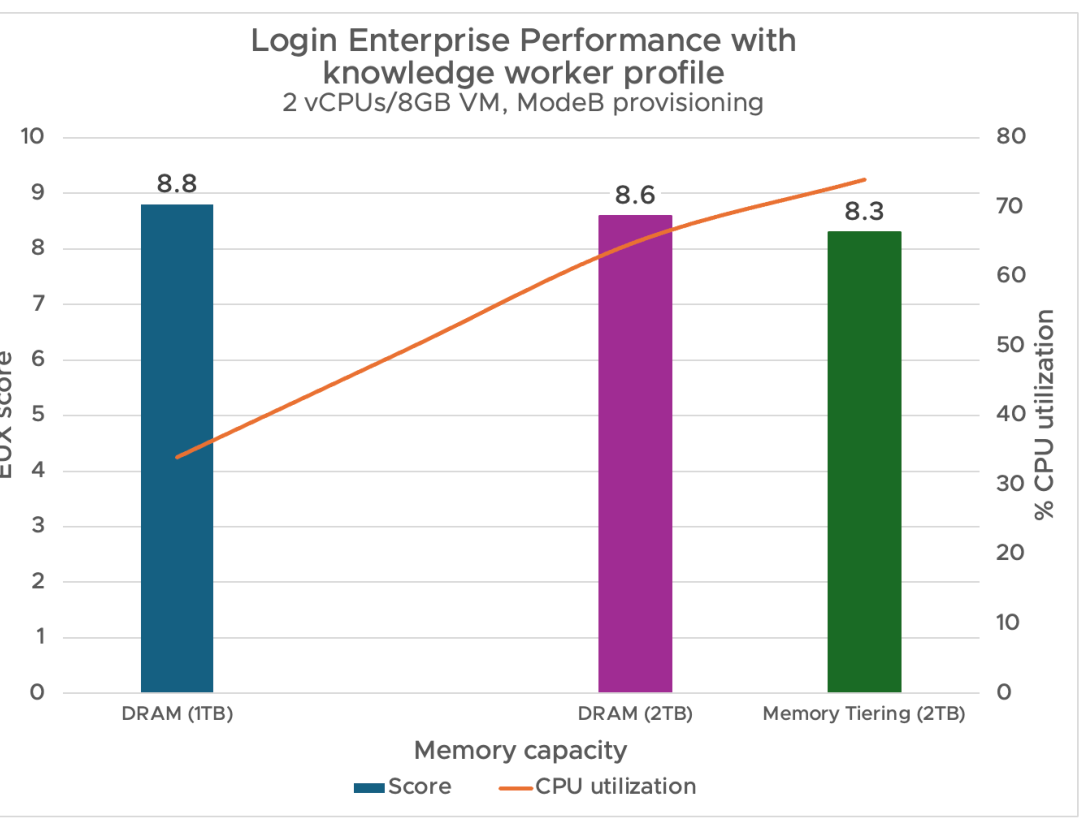
Двукратный рост плотности ВМ, потери 0–8%
VMmark
Корпоративные приложения
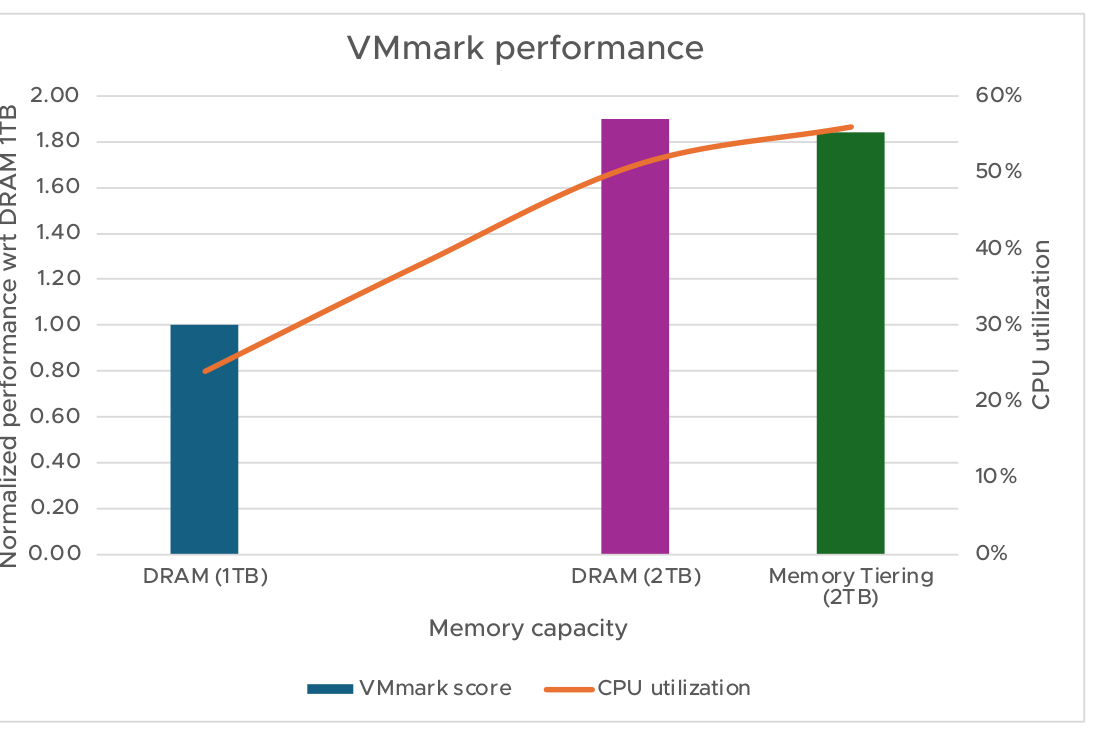
Двукратный рост плотности ВМ, потери 5%
DVD Store
Oracle Database
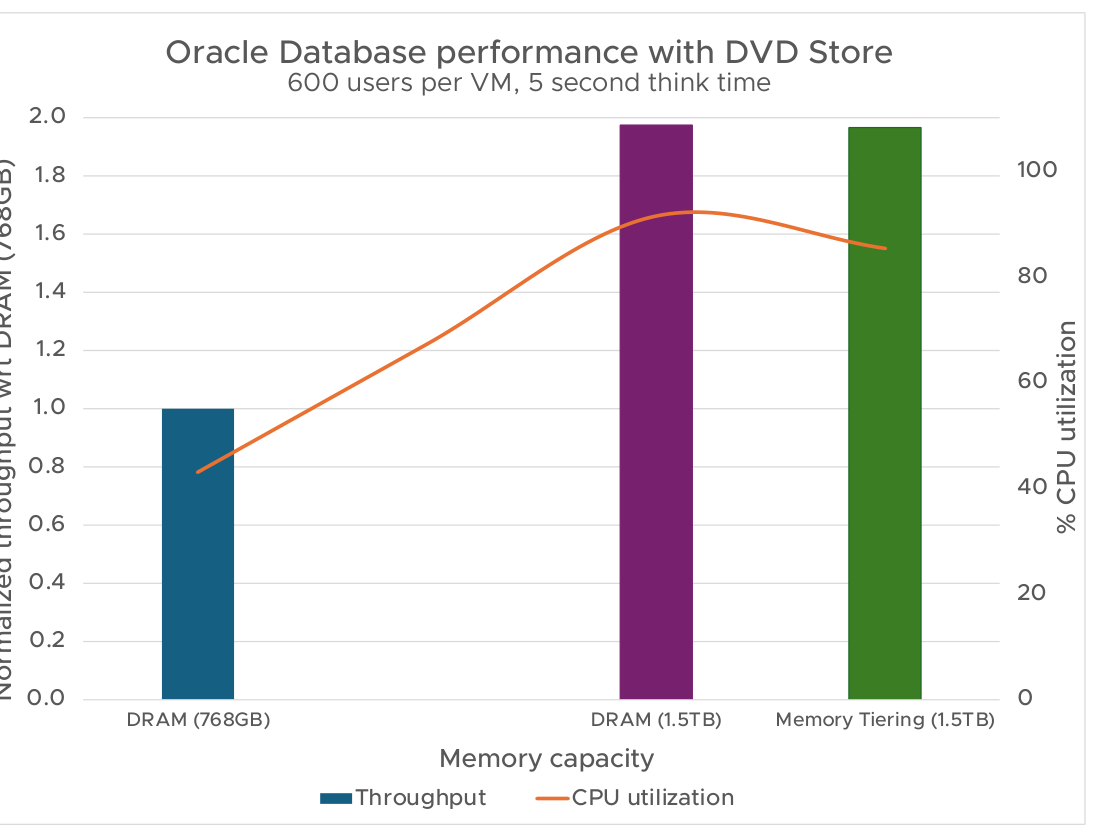
Двукратный рост плотности ВМ, потери менее 5%
HammerDB
SQL Server, MySQL
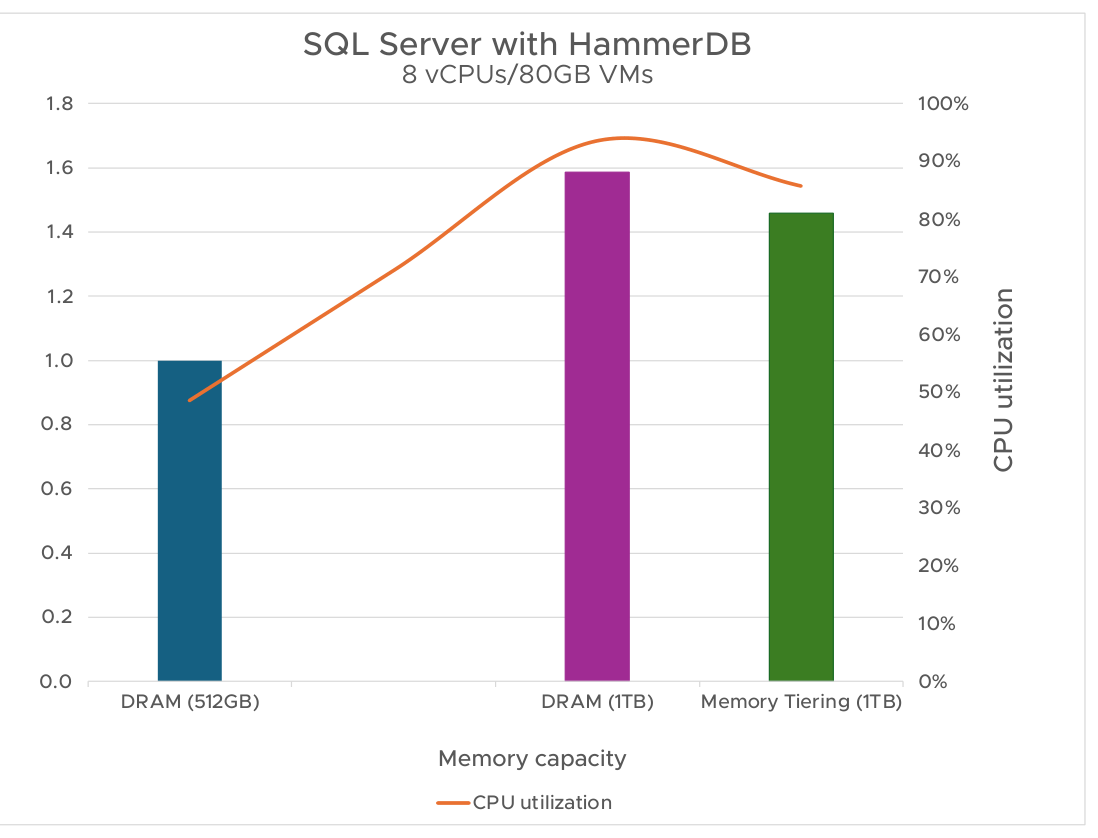
Двукратный рост плотности ВМ, потери 5–10%
Все цифры относятся к двукратной плотности виртуальных машин; при меньшей плотности влияние на производительность будет ниже или вовсе незаметным. Соотношение DRAM к NVMe по умолчанию в VCF 9.0 составляет 1:1 — при 1 ТБ DRAM можно получить ещё около 1 ТБ памяти на NVMe. Во всех тестах применялось именно оно.
Результаты представлены через три группы метрик: прирост плотности виртуальных машин, разница в производительности относительно системы только на DRAM и загрузка процессора — как в части дополнительно утилизируемых ресурсов, так и в части накладных расходов тиринга. Чтобы точнее отразить последние, большие страницы (large pages) на хосте везде оставались отключёнными — это настройка по умолчанию для ESX с тирингом.
Метрика активной памяти в разных инструментах называется по-разному: в esxtop это TCHD (touched memory), причём общехостового счётчика нет и значения всех машин приходится суммировать; в vCenter — счётчик Active в разделе Monitor > Performance > Overview > Memory; в VCF Operations — Metrics > Memory > Guest Active.
VDI: тестирование с Login Enterprise
Login Enterprise от Login VSI — отраслевой стандарт для оценки ёмкости и производительности VDI: виртуальные пользователи имитируют реальных сотрудников и замеряют время отклика на каждое взаимодействие. Инфраструктурой рабочих столов служила Omnissa Horizon. Из двух преднастроенных профилей выбран knowledge worker как самый тяжёлый и распространённый: он включает девять приложений, среди которых Word, PowerPoint, Excel, Outlook, браузер Edge и потоковое видео. Главная метрика — оценка пользовательского опыта EUX, складывающаяся из таймеров типичных действий: отзывчивости приложений, обработки клавиатурного ввода, ресурсоёмких вычислений и задержек дисковых операций.
Тесты шли в двух вариантах провижининга: с отключённым межмашинным Pshare (ModeB) и с включённым (ModeA). В ModeA мгновенные клоны при создании клонируются от родительской ВМ и разделяют её память; в ModeB — от выключенной ВМ-реплики, без разделения. Режимы различаются не только поведением разделения страниц, но и работой алгоритма тиринга, поэтому в исследование вошли оба. Одиночный узел — Dell PowerEdge R760 с двумя Intel Xeon 8480 (56 ядер на сокет) и 1 или 2 ТБ DRAM, устройство тиринга Dell Ent NVMe P5620 MU на 1,6 ТБ, рабочие столы Windows 11 на 2 vCPU.
В режиме ModeB машинам выделялось 8 ГБ RAM: при 1 ТБ DRAM это давало около 120 VDI-сессий, а добавление 1 ТБ на NVMe позволило довести их число до 240. Потери составили менее 6% относительно варианта только на DRAM (1 ТБ). Оценка EUX снизилась с 8,6 до 8,3 при сравнении дорогой системы с 2 ТБ DRAM и заметно более дешёвой с 1 ТБ DRAM плюс 1 ТБ тиринга — падение всего около 3,5%. Загрузка процессора выросла с 63,5% до 74%: перемещение данных между уровнями имеет свою цену.
Время отклика приложений изменилось незначительно: Outlook открывался за 1,10 секунды против 0,94 на чистой DRAM, запуск Excel и PowerPoint замедлился примерно на 0,002 секунды. Активная память хоста держалась в диапазоне 420–450 ГБ — около 50% от ёмкости DRAM. Динамика EUX по мере роста числа сессий тесно коррелирует с показателями NVMe: когда задержка поднималась выше 200 микросекунд, метрики CPU score и Generic application score проседали, а при стабилизации около 200 микросекунд снова росли вместе с общей оценкой.
В режиме ModeA машинам выделялось 6 ГБ: выигрыш от разделения страниц оставляет алгоритму больше пространства для масштабирования. Число сессий выросло с 160 до 320. Оценка EUX снизилась с 8,7 до 7,9, но причина не в тиринге: в первом случае процессор работал с турбо-ускорением в 1,5 раза, а при 320 машинах из-за высокой загрузки его частота была близка к номинальной. С включёнными большими страницами EUX составила 8,3 при загрузке CPU 84,5%, с отключёнными — 7,9 при загрузке 90%. Сравнение 8,3 и 7,8 даёт потерю 6%, а если брать только малые страницы, падение с 7,9 до 7,8 — порядка 1%. Столь низкие потери согласуются с задержкой NVMe всего в 100 микросекунд при пропускной способности чтения заметно ниже 100 МБ/с.
Многоузловые тесты шли на трёхузловом кластере vSAN архитектуры ESA с RAID 5 на серверах Dell PowerEdge R660 с двумя Intel Xeon 6430 (32 ядра на сокет) и 512 ГБ DRAM: четыре NVMe в каждом хосте отданы под vSAN, пятое — под тиринг. В режиме ModeB тиринг позволил удвоить плотность машин за счёт добавления 512 ГБ NVMe, при этом оценка EUX относительно 1 ТБ DRAM снизилась лишь на 8%. Пропускная способность чтения NVMe составляла около 200 МБ/с, задержки стартовали со 100 микросекунд, поднимались до 400 по мере добавления сессий и опускались до 200 в установившемся режиме.
Во втором наборе тестов число рабочих столов увеличили до 200 на хост, то есть до 600 на кластер, с мгновенными клонами по 5 ГБ и провижинингом ModeA. Оценки EUX для DRAM (1 ТБ) и Memory Tiering (1 ТБ) составили 6,9 и 7,0 при загрузке процессора выше 90% в обоих случаях — то есть удвоение плотности прошло вовсе без потерь производительности. Задержки устройства тиринга достигали 150 микросекунд, пропускная способность держалась около 200 МБ/с, активная память доходила до 320 ГБ — 62,5% от доступной DRAM.
Корпоративные приложения: VMmark
VMmark оценивает производительность и масштабируемость виртуализованных ЦОД. Бенчмарк объединяет типовые приложения (standby, DVD Store и Weathervane) в блоки-«тайлы»; один тайл состоит из 19 Linux-машин с нагрузками от 1 до 8 vCPU и от 4 до 250 ГБ памяти. Использовалась конфигурация с большим объёмом памяти: размер ВМ с базой увеличен с 32 до 250 ГБ, размер базы — со 100 до 300 ГБ, время раздумий — с 1 до 1,5 секунды, чтобы сделать тест в большей степени memory-intensive, чем compute-intensive. Тестовая система — два Intel Xeon 8592 по 64 ядра с 1 или 2 ТБ DRAM, устройство тиринга Samsung PM9A3 на 3,84 ТБ, на тайл приходилось 376 ГБ памяти и 31 vCPU.
Итоговая оценка агрегирует метрики пропускной способности приложений с нормализацией по весу каждого, а тайлы добавлялись до появления сбоев качества обслуживания. Конфигурация только на DRAM (1 ТБ) выдержала 57 виртуальных машин в трёх тайлах, конфигурация с тирингом (2 ТБ) — 114 машин в шести тайлах.
Сравнение трёх конфигураций показывает накладные расходы технологии по производительности и по процессору. В базовом варианте загрузка CPU была ограничена нехваткой памяти, тогда как при большем её объёме сервер утилизировался значительно плотнее. Производительность тиринговой конфигурации оказалась менее чем на 5% ниже варианта с 2 ТБ DRAM — притом что хост располагал лишь 1 ТБ реальной DRAM. Пропускная способность чтения NVMe была чуть выше рекомендованной, но задержка оставалась около 100 микросекунд, и производительность не пострадала.
Базы данных: SQL Server, Oracle и MySQL
Нагрузки баз данных требовательны к процессору, дискам и памяти одновременно, что делает их хорошим полигоном для проверки тиринга. Тестировались СУБД, типичные для развёртываний VCF: Microsoft SQL Server 2022, Oracle Database 21c и MySQL 8.0.
SQL Server измерялся с помощью HammerDB 5.0 (профиль TPC-C, 1000 складов, 125 виртуальных пользователей) на Dell PowerEdge R760 с 512 ГБ или 1 ТБ DRAM и виртуальными машинами на 8 vCPU и 80 ГБ. На хосте с 512 ГБ DRAM удавалось запустить не более 6 машин — при попытке добавить больше транзакции завершались по таймауту. Расширение памяти до 1 ТБ с помощью тиринга позволило удвоить их число. Прирост производительности при переходе от 512 ГБ к 1 ТБ DRAM составил 1,6 раза (нелинейность объясняется факторами, не связанными с тирингом), а падение при сравнении DRAM (1 ТБ) и тиринга (1 ТБ) не превысило 10%.
Активная память в установившемся режиме составляла около 256 ГБ, а процессорная нагрузка снизилась, поскольку машины ожидали обслуживания промахов DRAM накопителем. Задержка чтения NVMe на фазе разогрева держалась в районе 300–400 микросекунд и стабилизировалась примерно на 200 в измерительной фазе. Показательна корреляция: пока активная память на разогреве превышала 50% от DRAM, число транзакций в минуту проседало; когда она устоялась на уровне около 50%, показатель TPM вырос и стабилизировался.
Oracle Database 21c тестировалась на Oracle Enterprise Linux 8.8 с нагрузкой DVD Store 3.5: 600 пользователей на машину, время раздумий 5 секунд, база около 200 ГБ. Система — односокетный AMD EPYC 9755 на 128 ядер с 768 ГБ DRAM, виртуальные машины на 16 vCPU и 192 ГБ. Проверялись три сценария: 768 ГБ DRAM, 1,5 ТБ DRAM и тиринговый вариант из 768 ГБ DRAM плюс 768 ГБ NVMe. Число машин подбиралось так, чтобы полностью законтрактовать память: 4 машины на 768 ГБ и 8 машин на 1,5 ТБ. Результат — рост с 4 до 8 машин при потере менее 5% относительно 1,5 ТБ чистой DRAM.
Особенно показательна динамика процессора: в базовом сценарии его загрузка была ограничена 43%, а с тирингом достигла 85%. Это наглядно демонстрирует способность технологии раскрывать ёмкость хоста там, где система упирается в память, а процессорные циклы простаивают. Активная память по счётчику touched memory в esxtop в среднем составляла около 400 ГБ — чуть больше 50% от DRAM, а средняя задержка чтения NVMe — 86 микросекунд при пропускной способности около 35 МБ/с.
MySQL 8.0 на RHEL 9.4 тестировался тем же HammerDB на машинах с 14 vCPU и 60 ГБ; плотность также удалось удвоить при потере менее 5%. Параметром keyingandthinktime здесь регулировались нагрузка на процессор и объём активной памяти. При времени раздумий 10 миллисекунд загрузка CPU в базовом сценарии на 512 ГБ была высокой — 70%, активная память достигала 286 ГБ (около 55% ёмкости DRAM); при удвоении числа машин в работу вовлекались 224 vCPU и процессор доходил почти до насыщения, что объясняет нелинейное масштабирование. Когда время раздумий подняли до 45 миллисекунд, активная память выросла до 410 ГБ (около 80% DRAM), а загрузка CPU снизилась до 45% — благодаря запасу по процессору удвоение плотности дало двукратный рост пропускной способности. Примечательно, что даже при активной памяти на уровне 80% потери оказались минимальными: вероятно, большое время раздумий поглощало задержки NVMe.
Влияние на vMotion
Производительность виртуальных машин при миграции vMotion в среде с тирингом не страдает, но сама миграция может занимать больше времени: фаза предварительного копирования читает данные с медленных уровней. Внутренний механизм vMotion разобран в отдельном документе.
Тестировался Dell PowerEdge R750 с двумя Intel Xeon 8380 и адаптерами Mellanox 100GbE. Четыре машины на 12 vCPU и 48 ГБ работали под RHEL 8.1 с Oracle 21c и SGA 43 ГБ, нагрузка создавалась HammerDB; чтобы активировать тиринг, память хоста искусственно уменьшили до 164 ГБ. В сценарии эвакуации хоста с одновременной миграцией всех четырёх машин пропускная способность Oracle оставалась практически неизменной: наблюдался единственный провал в фазе переключения, но простой не превышал секунды.
Сценарий
Среднее время миграции
Простой ВМ
Штраф для гостя
4 ВМ, базовый вариант (только DRAM)
23,5 секунды
менее 1 секунды
менее 5%
4 ВМ, Memory Tiering
82 секунды
менее 1 секунды
менее 5%
Тиринг увеличивает длительность vMotion, но на производительности машин это не сказывается: замедление приходится на фазу предварительного копирования, когда холодные страницы читаются с более медленного NVMe.
Эксплуатация и мониторинг
Чтобы Memory Tiering обеспечивал хорошую производительность, важны три вещи: следить за активной памятью, следить за задержкой чтения NVMe и правильно выбрать сам накопитель.
Активную память рекомендуется удерживать не выше 50% от ёмкости DRAM хоста; для некоторых нагрузок она может быть выше без каких-либо проблем. В диапазоне от 50% до 75% необходимы тестирование и наблюдение за конкретной нагрузкой. Выше 75% в большинстве случаев следует ожидать существенных потерь.
Пока задержка чтения накопителя остаётся ниже 200 микросекунд, производительность тиринга ожидаемо хорошая. В диапазоне 200–400 микросекунд возможны проблемы, а выше 400 влияние на нагрузки становится заметным.
При выборе накопителя стоит ориентироваться на высокий класс износостойкости D и высокий класс производительности — более 100 000 операций записи в секунду при DWPD = 3 — а также на больший объём.
Нужные метрики доступны в vCenter на странице Advanced Performance через Chart Options. Пропускная способность записи показывает перенос холодных страниц на NVMe, чтения — извлечение страницы, которая снова стала активной, но отсутствует в DRAM; если чтение превышает 200 МБ/с, стоит присмотреться к задержкам. На качественном накопителе они остаются заметно ниже 200 микросекунд даже при 400 МБ/с, тогда как некоторые другие модели на схожем трафике показывают около 300. Чтобы понять, почему конкретная машина работает медленно, стоит посмотреть пропускную способность чтения в её разрезе: всплывающее окно графика позволяет вывести несколько машин сразу. Активная память хоста доступна там же, а также в VCF Operations.
Дополнительно рекомендуется обеспечить достаточный запас по процессору под накладные расходы тиринга; следить, чтобы загрузка CPU на нетиринговых хостах кластера не превышала 75%, иначе эффективность технологии может снизиться; и не использовать с Memory Tiering «монструозные» виртуальные машины — крупнее 32 vCPU и 512 ГБ DRAM.
Выводы
Memory Tiering — важное усовершенствование VCF 9, позволяющее за счёт добавления NVMe SSD получить значительно больший объём памяти при существенно меньшей стоимости по сравнению с использованием только DRAM. Технология решает проблему растущей стоимости памяти в ЦОД, оптимизируя совокупную стоимость владения серверами и нагрузками, ограниченными объёмом памяти.
Измерения на нескольких бенчмарках дали стабильно хорошие результаты: двукратный рост плотности виртуальных машин и экономия TCO до 40%. Тиринг также высвобождает процессорные ресурсы хоста, которые при дефиците памяти иначе остались бы неиспользованными, а простой машин при vMotion неизменно остаётся ниже одной секунды. Оптимальную производительность обеспечивает мониторинг двух показателей: активную память в идеале следует удерживать ниже 50% от объёма DRAM, а задержку устройства нижнего уровня — ниже 200 микросекунд.
После установки плоскости управления, кластерного компонента и Knative Serving стек готов принимать нагрузки. Приведённые ниже тесты сквозным образом проверяют три типа нагрузок (инференс, рабочая среда, обучение) с помощью CLI runai версии 2 и подтверждают, что планирование GPU, автомасштабирование Knative и внешняя связность работают. Каждый тест содержит явные шаги проверки, чтобы оператор понимал, что тест пройден. Все три теста самодостаточны и после проверки могут быть свёрнуты.
Предприятиям, которые запускают AI в собственных дата-центрах, нужно частное облако, где под единой панелью управления живут и традиционные приложения, и нагрузки с GPU-ускорением. Таким частным облаком выступает VMware Cloud Foundation (VCF), а в связке с VMware vSphere Kubernetes Service (VKS) как штатной средой исполнения Kubernetes и с VMware Private AI Foundation with NVIDIA он превращается в готовую к работе с GPU платформу для AI. Поверх этого фундамента располагается NVIDIA Run:ai — слой оркестрации..
Таги: VMware, NVIDIA, VCF, Enterprise, AI, Private AI
Решение VMware Cloud Foundation Operations HCX 9.1 включено в состав платформы VCF 9.1 и развивает линейку инструментов мобильности рабочих нагрузок. В новой версии переработана архитектура транспортных устройств, управление жизненным циклом полностью переведено в VCF Operations, усилены механизмы безопасности и соответствия требованиям, а также расширены возможности миграции и поддержка гостевых операционных систем. Ниже разобраны основные нововведения. Полное описание доступно в официальной документации по мобильности рабочих нагрузок.
Оптимизированная архитектура устройств IX и NE
Ключевое нововведение версии — новая оптимизированная (enhanced) архитектура устройств HCX Interconnect (IX) и Network Extension (NE), обеспечивающая более высокую производительность передачи данных между площадками.
Начиная с версии 9.1, все вновь создаваемые сервисные сети (Service Mesh) автоматически разворачиваются на базе оптимизированной архитектуры. Устройства, развёрнутые в предыдущих версиях, продолжают работать на прежней (legacy) архитектуре до тех пор, пока не будут переведены на новую через процедуру миграции расширений сети (Migrating Network Extensions).
Дополнительно версия отказывается от самоуправляемых устройств на базе PhotonOS в пользу стека NSX Edge, который обеспечивает более высокую производительность и устраняет избыточность поддержки двух функционально эквивалентных сетевых стеков. Для перевода устройств PhotonOS на архитектуру NSX Edge в HCX 9.1 предусмотрен автоматизированный сценарий миграции. Поддержка PhotonOS-устройств объявлена устаревшей, полное удаление запланировано на VCF 10.0.0.
Развёртывание и управление жизненным циклом через VCF Operations
HCX 9.1 становится неотъемлемой частью платформы VCF: развёртывание, управление и обновление HCX Manager теперь выполняются непосредственно из VCF Operations. Установочные дистрибутивы загружаются в экземпляр VCF, после чего устройство разворачивается через централизованный интерфейс без ручных операций с OVA на целевой стороне.
Загрузка дистрибутивов VMware Cloud Foundation Operations HCX из консоли VCF Operations:
Установка HCX Manager как дополнительного компонента домена прямо из интерфейса VCF Operations:
Экземпляры HCX Manager, развёрнутые вручную (например, в устаревшей исходной среде за пределами VCF), можно подключить (onboard) и в дальнейшем управлять ими из VCF Operations. Основные возможности блока управления жизненным циклом:
Управление жизненным циклом (LCM): развёртывание, обслуживание и обновление HCX Manager выполняются через VCF Operations.
Пакет управления VCF Operations HCX Management Pack: новый пакет для установки в VCF Operations, обеспечивающий критически важные сервисы — ротацию паролей локальных пользователей, ротацию сертификатов и сбор диагностических журналов. Пакет несовместим с прежним пакетом управления HCX для vRealize Operations.
Идентификация и доступ: поддержка единого входа VCF Single Sign-On (SSO) и ролей VCF для унифицированной аутентификации и авторизации в веб-интерфейсе и API HCX Manager.
Завершение мастера развёртывания HCX Manager, запускающего автоматизированную установку:
Безопасность и соответствие требованиям
Сертификация FIPS 140-3: HCX теперь сертифицирован по стандарту FIPS 140-3, что соответствует строгим требованиям к безопасности.
Неразрывное управление сертификатами (NDC): новые REST API HCX Manager позволяют управлять сертификатами HCX без нарушения доверия со стороны клиентов.
Сетевая безопасность: порты HCX добавлены в список исключений распределённого межсетевого экрана (DFW); между оптимизированными устройствами IX и NE используется стандартный трафик IPsec.
Улучшения миграции и Interconnect
Оптимизация WAN: возвращена функция эффективной оптимизации WAN, встроенная непосредственно в конфигурацию сервисной сети HCX Interconnect. Возможность доступна исключительно для оптимизированных сервисных сетей и не поддерживается для миграций OSAM и HAV.
Локальные миграции в пределах площадки: поддержка миграций без развёртывания устройств внутри одного экземпляра vCenter с помощью HCX Assisted vMotion (HAV) — источник и приёмник могут быть одним и тем же экземпляром.
Расширенная поддержка хранилищ и правил: поддержка нестандартных политик хранения при «холодных» (Cold) миграциях, а также возможность выбирать несколько целевых хранилищ данных для одной виртуальной машины (кроме OSAM).
Расширения VLAN-сетей: поддержка расширения VLAN-сетей на нативные распределённые группы портов (DVPG) на целевой площадке.
Обновлённый веб-интерфейс: переработанный и дополненный пользовательский интерфейс.
Расширенная поддержка гостевых ОС
Список поддерживаемых операционных систем для кастомизации гостевой ОС и миграции с помощью агента (OS Assisted Migration, OSAM) расширен:
Кастомизация гостевой ОС и массовая (Bulk) миграция теперь поддерживают Windows Server 2022.
Миграция OSAM теперь поддерживает Windows Server 2022 и Windows Server 2025.
Устаревшие функции
В рамках упрощения продукта в версии 9.1 объявлен отказ от ряда возможностей:
Устройства на базе PhotonOS: поддержка самоуправляемых устройств PhotonOS объявлена устаревшей с версии 9.1.0, полное удаление намечено на VCF 10.0.0. Предусмотрен автоматизированный переход на архитектуру NSX Edge.
VMware Cloud Director (VCD): поддержка VCD в VCF Operations HCX объявлена устаревшей с версии 9.1.0. Поскольку VCD не поддерживается в VCF 9, для переноса рабочих нагрузок в VCF Automation 9 внедряется новый инструмент импорта. Полное удаление запланировано на VCF 9.2.0.
Совокупность нововведений делает VCF Operations HCX 9.1 более производительным, безопасным и глубоко интегрированным в платформу VCF решением для мобильности рабочих нагрузок. Подробности приведены в официальных заметках о выпуске VCF 9.1.
p>Это пошаговое руководство описывает, как развернуть HCX Manager в среде VCF 9.1, а также в устаревшей (legacy) инфраструктуре. Материал содержит полное описание всех этапов процесса и сопровождается видеозаписью, охватывающей каждый шаг. Для администратора эффективная и безопасная миграция рабочих нагрузок внутри центров обработки данных и между ними является фундаментальной частью стратегии частного облака. Таги: VMware, VCF, HCX, Update, Enterprise, VMachines
Если вы управляете Kubernetes вместе с традиционными виртуальными машинами, vSphere Supervisor в vSphere 9.0 и VMware Cloud Foundation (VCF) 9.0 служит единой плоскостью управления. Но когда дело доходит до настройки инфраструктуры, у команд, проектирующих такие среды, всегда возникает один и тот же вопрос:
«Какие балансировщики нагрузки поддерживаются и как выбрать правильный для моего vSphere Supervisor?»
Ответ полностью зависит от вашей существующей сетевой архитектуры, лицензирования и того, какой объём контроля над управлением трафиком вы хотите передать платформе, а какой — командам разработки. Разберём поддерживаемые платформенные балансировщики нагрузки в vSphere 9 и VCF 9, посмотрим, как они соотносятся с топологией сети, и выясним, где остаётся гибкость на уровне приложений.
Основные варианты организации платформенного балансировщика нагрузки
vSphere Supervisor поддерживает несколько вариантов платформенного балансировщика нагрузки. Ваш выбор определяет, как ключевые инфраструктурные сервисы — включая виртуальные машины VM Service, нативные vSphere Pods и управляющие плоскости кластеров VMware vSphere Kubernetes Service (VKS) — получают связность на уровне L4. Каждый вариант рассчитан на свою сетевую архитектуру и операционную модель.
1. Foundation Load Balancer и NSX Load Balancer: связность L4 из коробки
Если вам нужна интегрированная балансировка нагрузки на уровне Layer 4 (IP:порт) сразу после установки, основными вариантами платформенного балансировщика являются Foundation Load Balancer (FLB) и NSX Load Balancer (NSX-LB). Оба обеспечивают нативную связность L4 для рабочих нагрузок, управляемых Supervisor.
Какой из них использовать — зависит от вашего окружения:
FLB: включён из коробки и доступен как с лицензией VMware vSphere Foundation (VVF), так и с VCF.
NSX-LB: включён в состав VCF для сред, использующих сети NSX.
Оба платформенных балансировщика обеспечивают связность L4 для рабочих нагрузок под управлением Supervisor, включая:
Виртуальные машины VM Service: ВМ, развёрнутые через VM Service в пространство имён vSphere Namespace.
vSphere Pods: контейнерные нагрузки, работающие непосредственно на гипервизоре ESX.
Кластеры vSphere Kubernetes Service (VKS): CNCF-совместимые кластеры Kubernetes и приложения, работающие внутри них.
А что насчёт маршрутизации Layer 7 (уровень приложений)?
FLB и NSX-LB предоставляют сервисы L4 на уровне платформы, но команды приложений по-прежнему могут использовать Kubernetes-нативные решения для ingress и управления трафиком, такие как Contour, Istio и Gateway API, внутри кластеров VKS. Это открывает возможности Layer 7, включая маршрутизацию HTTP, маршрутизацию по путям и терминацию TLS с помощью привычных инструментов Kubernetes.
2. Avi Load Balancer: продвинутое управление трафиком корпоративного класса
Для организаций, которым нужны развитые контроллеры доставки приложений (ADC) во всей облачной инфраструктуре, Avi Load Balancer (Enterprise Edition) расширяет платформу возможностями управления трафиком на уровне L7, безопасности и аналитики.
Когда Avi Enterprise выбран в качестве платформенного балансировщика для vSphere Supervisor, он добавляет продвинутые сервисы доставки приложений на уровне платформы, включая:
Управление трафиком Layer 7: продвинутая маршрутизация HTTP/HTTPS, переключение контента и управление трафиком на основе политик.
Web Application Firewall (WAF): интеллектуальная распределённая защита от уязвимостей и веб-эксплойтов на границе.
Расширенный мониторинг и аналитика: видимость производительности приложений, сквозных задержек и паттернов пользовательского трафика в реальном времени.
Интегрированный DNS и Global Server Load Balancing (GSLB): доступность на нескольких площадках и распределение трафика между географически разнесёнными локациями.
Если ваша операционная модель требует централизованного управления безопасностью, глубокой аналитики или единообразия между облаками, Avi предоставляет продвинутые сервисы доставки приложений, безопасности и управления трафиком сразу в нескольких средах.
Выбор платформенного балансировщика по типу сети рабочих нагрузок
Архитектура сети рабочих нагрузок определяет, какие варианты платформенного балансировщика доступны при развёртывании vSphere Supervisor. Сетевые модели соотносятся с поддерживаемыми балансировщиками следующим образом:
vSphere Distributed Switch (VDS): поддерживает Foundation Load Balancer (FLB) или Avi Load Balancer — для сред с традиционными сетями vSphere.
Сегмент NSX: поддерживает NSX Load Balancer или Avi Load Balancer — для сред с сетями NSX.
NSX Virtual Private Cloud (VPC): поддерживает Avi Load Balancer и предназначен для cloud-native сред, использующих сети NSX VPC.
Гибкость на уровне кластеров VKS
Одна из сильных сторон VKS заключается в том, что выбор платформенного балансировщика для Supervisor не ограничивает варианты балансировки, доступные рабочим нагрузкам внутри кластеров VKS.
Поскольку кластеры VKS — это upstream-совместимые кластеры Kubernetes, они поддерживают стандартные ingress-контроллеры Kubernetes, реализации балансировщиков и другие Kubernetes-нативные решения доставки приложений.
Это позволяет инфраструктурным командам стандартизироваться на FLB, NSX-LB или Avi на уровне платформы, оставляя командам приложений свободу выбирать решение доставки приложений, которое лучше всего подходит их нагрузкам.
Краткое сравнение платформенных балансировщиков
В таблице ниже сведены ключевые различия между поддерживаемыми платформенными балансировщиками:
Функция / возможность
Foundation Load Balancer (FLB)
NSX Load Balancer (NSX-LB)
Avi Load Balancer (Enterprise)
Поддерживаемые типы сетей
VDS
Сегмент NSX или NSX VPC
VDS, сегмент NSX или NSX VPC
Основной уровень маршрутизации
Layer 4 (IP:порт)
Layer 4 (IP:порт)
Layer 4 и Layer 7
Требуемая лицензия
VVF или VCF
VCF
Лицензия Avi Enterprise
Ingress / WAF из коробки
Нет (используется VKS Ingress)
Нет (используется VKS Ingress)
Да (нативные функции платформы)
Расширенная аналитика и GSLB
Нет
Нет
Да
Переопределение на уровне VKS
Да
Да
Да
Заключение
Выбор правильного платформенного балансировщика в конечном счёте сводится к архитектуре сети рабочих нагрузок и операционным требованиям. Нужна ли вам интегрированная связность L4 с FLB или NSX-LB, либо продвинутая доставка приложений на уровне L7 с Avi — vSphere Supervisor предлагает поддерживаемый путь для каждой модели развёртывания.
Дерево решений ниже служит быстрой памяткой, помогающей выбрать платформенный балансировщик, который лучше всего подходит вашему окружению.
Риски безопасности, которые создают передовые AI-модели, делают оперативное реагирование на новые угрозы крайне важным. Broadcom предпринимает шаги, чтобы обеспечить готовность VMware Cloud Foundation (VCF) к немедленному патчингу, позволяя организациям быстро реагировать на возникающие угрозы. Это означает, что для VCF 9.1 будут выпускаться более частые ежемесячные Express Patches. В этой статье описывается, как выглядит процесс их накатывания, и показано, как убедиться, что установлены самые последние патчи.
Прежде чем начать, необходимо обновиться до VCF 9.1, поскольку Express-патчи выпускаются именно для этой версии.
Шаг 1: Проверка наличия и загрузка патчей
Первый шаг — проверить наличие новых доступных патчей. Это можно сделать, перейдя в раздел Build > Lifecycle в VMware Cloud Foundation Operations.
При переходе в разделы Patch Binaries или Install Binaries отображаются патчи для всех продуктов, в которых были устранены уязвимости безопасности. В приведённом примере это патч от 4 июня версии 9.1.0.0100.
Первая задача — загрузить патчи для развёртываемого релиза. Это может занять некоторое время в зависимости от количества выпущенных патчей, но после завершения загрузки они становятся доступны для развёртывания.
Шаг 2: Обновление управляющих компонентов VCF
После загрузки патчей их можно развернуть сначала для управляющих компонентов VCF, начиная с Fleet Lifecycle. Перейдите в VCF Operations и выберите Build > Lifecycle > VCF Management > Upgrade — на этой странице можно выбрать целевую версию для обновления.
Затем нужно нажать кнопку Upgrade, что запустит обновление этого компонента. Процесс обновления займёт некоторое время, но можно открыть подробности хода выполнения.
После завершения появится возможность задать целевую версию для каждого из компонентов, входящих в состав управляющих сервисов VCF, для которых доступно обновление.
После выбора версии можно применить патчи. Рекомендуется сначала запустить предварительную проверку (precheck) для всех компонентов, нажав Run Prechecks. Обычно проверка запускается сразу для всех компонентов, после чего исправляются найденные проблемы. Когда все предварительные проверки пройдены успешно, можно нажать Upgrade для обновления компонентов. Обычно выбираются все компоненты сразу, чтобы обновление завершилось максимально быстро.
Этот процесс также может занять некоторое время в зависимости от обновляемых компонентов. После завершения обновления управляющих компонентов можно переходить к основным компонентам VCF.
Шаг 3: Обновление основных компонентов VCF
Как и в предыдущих релизах, обновление VMware SDDC Manager, VMware vSphere и VMware NSX происходит по схожему с прошлыми версиями сценарию. В VCF для ускорения развёртывания патчей безопасности используются Live Patching для хостов VMware ESX и Quick Patching для VMware vCenter.
Чтобы применить патчи 9.1.0.0100, снова перейдите в VCF Operations и выберите Build > Lifecycle Management > VCF Instance > Upgrades. Здесь можно нажать кнопку Plan Component Upgrade, чтобы выбрать целевую версию патча и сформировать план обновления.
После того как план создан, можно приступать к обновлению каждого из компонентов.
В зависимости от обновляемых компонентов план может включать один или несколько шагов выполнения. Пройдите все этапы обновления. По завершении патчи 9.1.0.0100 будут успешно применены.
Компания Broadcom не так давно объявила о выпуске VMware Cloud Foundation (VCF) 9.1 — очередном этапе развития самой широко применяемой в отрасли платформы частного облака. Этот релиз имеет ясную и сфокусированную цель: стать наиболее экономичным и защищённым фундаментом для продуктивного искусственного интеллекта, современных приложений и традиционных нагрузок, управляемых из единой плоскости управления, на инфраструктуре, которой предприятие владеет и которую само контролирует.
Одно из главных преимуществ VMware Cloud Foundation (VCF) 9.1 — гибкость и широкая поддержка уже существующих клиентских сред, что позволяет встретить заказчиков ровно на той точке, где они находятся на пути к частному облаку. Это охватывает самые разные сценарии: от отдельных развёртываний vSphere с VCF Operations до сред с различными комбинациями vSAN, NSX и Aria Automation, вплоть до полнофункционального развёртывания всего стека VCF.
Благодаря возросшей гибкости VCF 9.1 заказчикам, в зависимости от того, какие компоненты и функции развёрнуты в их среде, может потребоваться учитывать конкретную последовательность обновления компонентов, дополнительные операционные процедуры и требования к ресурсам. Всё это способно превратить понимание общего хода обновления в непростую задачу. Раньше для уверенного планирования и проведения обновления приходилось собирать сведения по частям — из продуктовой документации, статей базы знаний и матриц совместимости.
Чтобы упростить процесс обновления, был предложен иной подход: почему бы не начать с того, где заказчик находится сейчас, опираясь на уже развёрнутые продукты и функции, вместо того чтобы требовать от него разбираться во всём множестве вариантов развёртывания и сценариев обновления? Используя эти данные как исходные, можно затем предложить подходящие целевые сценарии, до которых возможно обновиться, и, что особенно важно, сформировать индивидуальный план обновления именно для его среды.
Объявлено о выпуске инструмента планирования обновлений VCF 9.1, который обеспечивает индивидуально подобранный сценарий планирования и помогает заказчикам уверенно пройти путь обновления VCF.
После указания текущего развёртывания — это может быть среда на базе vSphere или VCF — вместе с конкретными версиями, которые используются, пользователю предлагается набор применимых целевых вариантов на выбор.
Как только целевой вариант выбран, инструмент планирования обновления VCF формирует исчерпывающий план обновления, который включает:
Общий ход обновления, разбитый на отдельные этапы, что помогает спланировать окна технического обслуживания
Требования к ресурсам и сети
Ключевые соображения и потенциальные подводные камни, которых следует избегать
Соответствующие ссылки на продуктовую документацию VCF
Инструмент планирования обновления VCF можно использовать в интерактивном режиме, а также экспортировать весь ход обновления и (или) отдельные его этапы в PDF для работы офлайн.
Ожидается, что этот инструмент сделает процесс обновления VCF более удобным. При наличии отзывов, замечаний или предложений по улучшению можно создать Issue на GitHub или даже внести собственный вклад в проект.
VMware VCF — платформа частного облака, которая сочетает масштаб и гибкость публичного облака с безопасностью и производительностью локальной инфраструктуры, повышая продуктивность и снижая совокупную стоимость владения (TCO).
Полнофункциональная платформа Infrastructure as a Service (IaaS), предоставляющая программно-определяемые вычисления, хранение, сеть, Kubernetes, безопасность и средства управления.
Встроенная автоматизация формирует платформу самообслуживания для быстрого развёртывания виртуальных машин и контейнеров и повышения скорости разработки.
Закалённая платформа со встроенной отказоустойчивостью, масштабированием и кластеризацией для непрерывной работы.
Облачная гибкость позволяет наращивать инфраструктуру без увеличения штата, перенося облачную модель потребления в локальную среду.
Автоматизация и оркестрация упрощают задачи нулевого, первого и второго дня.
Поставляется единым SKU, что упрощает развёртывание всего стека.
VMware vSphere Foundation — рабочая платформа корпоративного уровня для современной инфраструктуры. Она даёт преимущества виртуализации, упрощённое управление, экономичность и масштабируемость и служит ядром, на котором строится VMware Cloud Foundation.
Единая платформа для совместного запуска виртуальных машин и контейнеров с нативной средой выполнения Kubernetes.
Интеллектуальное управление эксплуатацией обеспечивает расширенную видимость и оптимизацию инфраструктуры.
Гиперконвергентная инфраструктура объединяет виртуализацию вычислений и хранения для эффективного управления ресурсами.
Упрощённое развёртывание и масштабируемость с единым SKU ускоряют доставку приложений и готовят инфраструктуру к будущему.
На рисунке ниже показан упрощённый портфель VMware by Broadcom и три варианта поставки.
Детальное сравнение функций
В сравнении участвуют три варианта поставки.
VMware Cloud Foundation — ПО частного облака с интегрированными компонентами: vSphere, vSphere Kubernetes Service, VCF Operations, VCF Operations for Networks, VCF Operations fleet management, VCF Automation, vSAN и NSX.
VMware vSphere Foundation — ПО, предоставляющее часть возможностей VCF или их ограниченные версии: vSphere, vSphere Kubernetes Service, VCF Operations и vSAN.
VMware Cloud Foundation Edge — оптимизированная конфигурация VMware Cloud Foundation для периферийных сценариев.
В таблицах ниже символ • означает, что функция включена в соответствующее издание, прочерк — что функция недоступна. Числа в квадратных скобках отсылают к примечаниям в конце статьи.
Вычисления (Compute)
Включённые сервисы:
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
vSphere Kubernetes Service (VKS)
•
•
•
VM Service
•
•
•
Storage Service
•[2]
•
•
Network Service
•[2]
•
•
Container Registry Service
•
•
•
Harbor Image Registry Service
•
•
•
vSphere Pod Service
•
•
•
VKS Load Balancing
•
•
•
Service Mesh
•
•
•
External DNS
•
•
•
ArgoCD Operator
—
•
•
Secret Store Service
—
•
•
IaaS Policy Service
—
•
•
Data Services
•
•
•
Workload Availability Zones
•
•
•
Упрощённое управление жизненным циклом кластеров VKS
—
•
•
Build Your Own Image (BYOI)
•
•
•
Supervisor Independent Updates
•
•
•
Custom Zone Optimization
•
•
•
Управление эксплуатацией:
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
vSphere Lifecycle Manager
•
•
•
Live Patching for ESX
•
•
•
vCenter Quick Patching
•
•
•
vCenter Server Profiles
•
•
•
vCenter Update Planner
•
•
•
Content Library
•
•
•
vSphere Configuration Profiles
•
•
•
Host Profiles
•
[3]
[3]
Auto Deploy
•
[3]
[3]
Эластичное предоставление vSphere (ZTP)
•
•
•
Green Metrics
•
•
•
Встроенная безопасность:
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
Identity Federation
•
•
•
Аппаратный TPM 2.0
•
•
•
Virtual TPM 2.0
•
•
•
Сертификация FIPS 140-2 и Common Criteria
•
•
•
TLS 1.2
•
•
•
TLS 1.3
•[4]
•[4]
•[4]
Шифрование виртуальных машин
•
•
•
Standard Key Provider (внешний KMS)
•
•
•
Native Key Provider
•
•
•
File Integrity Monitoring
•
•
•
Confidential Computing
[15]
•
•
Интеграция EDR для ESX
•
•
•
Производительность приложений:
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
Per-VM Enhanced vMotion Compatibility (EVC)
•
•
•
Instant Clone
•
•
•
Distributed Resource Scheduler (DRS)
•
•
•
Storage DRS
•
•
•
Distributed Power Management (DPM)
•
•
•
Storage Policy-Based Management
•
•
•
I/O Controls (хранилище)
•
•
•
SR-IOV
•
•
•
vSphere Persistent Memory
•
•
•
Memory Tiering
•
•
•
NVIDIA GRID vGPU
•
•
•
Accelerated Graphics for VMs
•
•
•
Dynamic DirectPath IO
•
•
•
Enhanced DirectPath I/O
•
•
•
Vendor Device Group
•
•
•
Разные профили vGPU на одном GPU
•
•
•
Автоматизация DRS для vGPU-нагрузок
•
•
•
Поддержка DPU и Dual DPU
—
•
•
Непрерывность бизнеса:
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
vMotion
•
•
•
Cross-vCenter vMotion
•
•
•
Encrypted vMotion
•
•
•
vCenter Enhanced Linked Mode
•
•
•
vSMP
•
•
•
vSphere High Availability (HA)
•
•
•
Proactive HA
•
•
•
Storage vMotion
•
•
•
Fault Tolerance
•
•
•
vSphere Replication
•
•
•
Поддержка 4k Native Storage
•
•
•
vSphere Quick Boot
•
•
•
Файловое резервное копирование и восстановление vCenter
•
•
•
Cross vCenter Mixed Version Provisioning
•
•
•
Горячая и холодная миграция в облако
•
•
•
Управление на основе политик (Policy-based Governance)
•
•
•
Kubernetes Automation
•
•
•
Workload Lifecycle Management
•
•
•
vCenter Orchestration & Extensibility
•
•
•
Хранение (Storage)
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
vSAN Express Storage Architecture (ESA)
•
•
•
vSAN Original Storage Architecture (OSA)
•
•
•
All-Flash оборудование
•
•
•
Базовые компрессия и дедупликация
• (только OSA)
• (только OSA)
• (только OSA)
Продвинутое сжатие и глобальная дедупликация
• (только ESA)
• (только ESA)
• (только ESA)
Шифрование данных «в покое»
•
•
•
Шифрование данных «в движении»
•
•[3]
•[3]
Storage Policy-Based Management
•
•
•
Программная контрольная сумма
•
•
•
vSAN over RDMA
•
•[3]
•[3]
QoS — ограничение IOPS
•
•
•
Auto-Managed RAID
•
•
•
Кластеры хранения vSAN
•
•
•
Кластеры кибервосстановления vSAN
—
•[15]
•[15]
Удалённые хранилища (Remote Datastores)
•
•
•
Растянутый кластер (Stretched Cluster)
•
•
•
Двухузловой кластер (2-Node Cluster)
•
•[3]
•[3]
File Services
•
•
•
Object Storage
—
•[17]
•[17]
iSCSI Target Service
•
•[3]
•[3]
Cloud Native Storage (CNS) Control Plane
•
•
•
vSphere Container Storage Interface (CSI) Driver
•
•
•
Rack Awareness (Fault Domains)
•
•[3]
•[3]
Snapshot Manager с гибким расписанием
•
•
•
Неизменяемые снимки (Immutable Snapshots)
•
•
•
Репликация Any-to-vSAN
•[14]
•[14]
•[14]
Внешние хранилища:
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
VMFS — Fibre Channel
•
• (Principal, Supplemental)
• (Principal, Supplemental)
VMFS — iSCSI
•
• (Supplemental)
• (Supplemental)
VMFS — FCoE
•
• (Supplemental)
• (Supplemental)
VMFS — NVMe/FC
•
• (Supplemental)
• (Supplemental)
VMFS — NVMe/TCP
•
• (Supplemental)
• (Supplemental)
VMFS — NVMe/RDMA
•
• (Supplemental)
• (Supplemental)
NFS — v3
•
• (Principal, Supplemental)
• (Principal, Supplemental)
NFS — v4.1
•
• (Supplemental)
• (Supplemental)
Storage I/O QoS Controls (SIOC)
•
•
•
VAAI для блочного хранилища
•
•
•
VAAI для NFS-хранилища
•
•
•
Кластеризация нагрузок (VMDK Clustering)
•
•
•
Автонастройка с NFS
•
•
•
Сторонние плагины хранения
•
•
•
Ввод хостов и управление кластером
•
•
•
Сеть (Networking)
Функция
vSphere Foundation
VCF Edge
VMware Cloud Foundation
vSphere Distributed Switch
•
•
•
Link Aggregation Control Protocol (LACP)
•
•[3]
•[3]
Load-Based Teaming
•
•
•
Network I/O QoS Control (NIOC)
•
•
•
Private VLAN
•
•
•
MAC Learning
•
•
•
BPDU Guard
•
•
•
Guest VLAN Tagging
•
•
•
VLAN Backed Networking
•
•
•
Virtual Networking
—
•
•
Spoofguard
—
•
•
L2 Multicast
•
•
•
L3 Multicast
—
•
•
Enhanced Datapath
—
•
•
Enhanced Datapath для DPU
—
•
•
Маршрутизация IPv4 и IPv6
—
•
•
Динамическая маршрутизация (OSPFv2/BGP/BFD)
—
•
•
VRF
—
•
•
EVPN
—
•
•
NAT
—
•
•
L2 и L3 VPN
—
•
•
Quality of Service (QoS)
• (NIOC)
• (NIOC и NSX)
• (NIOC и NSX)
NSX Edge Bridge для сети
—
•
•
DNS, DHCP и IPAM
—
•
•
Container Networking с NCP
—
•[16]
•[16]
Container Networking с Antrea
•[16]
•[16]
•[16]
Политики, теги и группировка
—
•
•
Мультиарендность через проекты
—
•
•
Virtual Private Cloud (VPC)
—
•
•
Балансировка для компонентов VCF [12]
—
•
•
Балансировка L4 для vSphere Supervisor [11],[12]
•
•
•
Кластеризация менеджеров / контроллеров
—
•
•
Federation
—
•
•
NSX Edge в форм-факторе ВМ и bare-metal
—
•
•
Автоматическое и ручное развёртывание менеджера и Edge
—
•
•
Автоматическая подготовка хостов
—
•
•
Port Mirroring
•
•
•
Netflow/IPFIX
•
•
•
Traceflow
—
•
•
Live Traffic Analysis
—
•
•
Packet Capture
•
•
•
vSphere Kubernetes Services (VKS) и облачные сервисы VCF
Клиентам, которым нужна универсальная или продвинутая балансировка, рекомендуется приобрести Avi Load Balancer. Тем, кому требуется время на миграцию с существующей балансировки VCF на Avi, разрешено продолжать пользоваться полной балансировкой VCF до 30 мая 2027 года при наличии необходимых лицензий Avi. Подробности об лицензировании и вариантах миграции — в статье базы знаний № 439411.
Дополнительные сервисы приобретаются отдельно и не входят в базовые поставки VMware Cloud Foundation и VMware vSphere Foundation.
Требует лицензию VMware Site Recovery Manager (SRM).
Требует VCF Advanced Cyber Compliance (надстройка Advanced Services).
Поддержка Antrea предоставляется только для VMware VKS. Поддержка NCP — только для VMware vSphere Supervisor и Tanzu Elastic Runtime.
Tech Preview.
Функция доступна начиная с VKS 3.5+.
Пути обновления (Upgrade Paths)
Графики ниже показывают маршруты перехода с прежних продуктов на новые предложения.
Пути для вычислений (Compute). Прежние издания vSphere Foundation, vSphere Enterprise Plus, vSphere Enterprise, vSphere for Desktop, vSphere Scale-Out и vSphere Standard рекомендуется переводить на vSphere Foundation.
Пути для хранения (Storage). Связка vSphere + vSAN + NSX + Aria и vSphere + vSAN + Aria ведут к VMware Cloud Foundation; vSphere + vSAN и vSphere + vSAN + NSX — к vSphere Foundation вместе с надстройкой vSAN.
Пути для сети и безопасности (Networking/Security). Конфигурации vSphere + vSAN + NSX + Aria и vSphere + NSX + Aria переходят на VMware Cloud Foundation с межсетевым экраном Firewall; vSphere + vSAN + NSX и vSphere + NSX — также на VCF с Firewall.
Путь управления (Management). vSphere с Aria Suite Enterprise или vRCU Enterprise переходит на VMware Cloud Foundation; vSphere с vROPs + vRA, Aria Suite Advanced или vRCU Advanced — на vSphere Foundation; vSphere с vROPs, Aria Suite Standard или vRCU Standard — также на vSphere Foundation.
Пути vCloud Suite. vCloud Suite Enterprise консолидируется в VMware Cloud Foundation с Aria Suite Enterprise и vSphere Enterprise Plus; vCloud Suite Advanced — в vSphere Foundation с Aria Suite Advanced и vSphere Enterprise Plus; vCloud Suite Standard — в Aria Suite Standard с vSphere Enterprise Plus.
Пути VCF. VCF Enterprise, VCF Advanced, VCF Standard и VCF Starter переходят на VMware Cloud Foundation с межсетевым экраном Firewall.
За дополнительными деталями Broadcom предлагает обращаться к сотрудникам VMware и официальным партнерам.
Современные центры обработки данных сталкиваются с беспрецедентными вызовами в области хранения данных: ИТ-командам необходимо обеспечивать производительность, отказоустойчивость и эффективность для постоянно растущих объёмов данных, при этом бюджеты растут значительно медленнее. В прошлом стоимость хранения и памяти со временем снижалась, сглаживая влияние роста данных на бюджет, однако текущий суперцикл памяти ломает эту тенденцию. Методы снижения избыточности данных, уменьшение требований к процессору и памяти, а также новые типы носителей позволяют ИТ-командам нейтрализовать влияние растущих цен на всю инфраструктуру хранения.
Кроме того, ИТ-подразделения испытывают стремительный рост как масштаба приложений, так и их количества в датацентре. Рабочие нагрузки AI требуют огромных объёмов данных, и их распространение вынуждает ИТ осваивать новые интерфейсы хранения — объектное хранилище и высокопроизводительные файловые сервисы. Кроме этого, ИТ необходим более простой способ предоставления командам разработчиков доступа к инфраструктуре хранения. Сегодня администраторы нередко вынуждены работать с тикетными системами для выделения ресурсов: процессы часто выполняются вручную, отнимают много времени и чреваты ошибками. Администраторы хотят предоставлять доступ к ключевым сервисам хранения, не теряя при этом контроля и соответствия требованиям, — чтобы разработчики могли двигаться с темпом, которого требует бизнес.
Но давление на ИТ этим не ограничивается. Угрозы безопасности эволюционируют быстрее, чем когда-либо, а атаки вымогателей вынуждают ИТ-команды переосмыслить фундаментальную устойчивость инфраструктуры хранения. Время восстановления критически важных приложений приобретает всё больший приоритет. Данные должны быть защищены с помощью неизменяемых снимков, зашифрованы при хранении и передаче, а также восстанавливаемы в случае кибератак.
Наконец, ИТ-команды нуждаются в помощи с управлением растущей сложностью датацентра. По мере стремительного увеличения масштабов инфраструктуры ИТ нуждается в том, чтобы поставщики инфраструктуры автоматизировали и упрощали процессы, позволяя администраторам управлять большей инфраструктурой меньшими силами. Инфраструктура хранения должна самоуправляться, самодиагностироваться и предоставлять критическую диагностическую информацию для быстрого устранения проблем.
Именно поэтому всё больше клиентов отказываются от устаревших трёхуровневых архитектур в пользу полностью интегрированного частного облака. vSAN является критически важным, встроенным компонентом VMware Cloud Foundation (VCF), обеспечивающим развитие новых и существующих возможностей VCF. В vSAN в составе VCF 9.1 реализованы функции, которые упрощают снижение затрат на инфраструктуру хранения, ускоряют разработку современных приложений, обеспечивают запуск и защиту рабочих нагрузок в частном облаке на базе VCF, а также упрощают операции с хранилищем VCF.
Гибкая и эффективная платформа хранения
Экономическая эффективность всегда была сильной стороной vSAN, а vSAN в VCF 9.1 делает ещё один шаг вперёд благодаря более интеллектуальному сжатию и доступным по цене аппаратным конфигурациям.
Глобальная дедупликация
В VCF 9.1 глобальная дедупликация vSAN переходит в статус общедоступной. Глобальная дедупликация vSAN позволяет сократить используемую ёмкость до 8 раз — это критически важная возможность в условиях быстро растущей стоимости хранения и увеличивающихся сроков поставок оборудования. Дедупликация в vSAN спроектирована с минимальным влиянием на процессор и может применяться ко всем данным в кластере. Это дедупликация с постобработкой: она выполняется в фоновом режиме при низкой нагрузке на процессор. В отличие от традиционных систем хранения, где дедупликация ограничена хранилищем за парой I/O-контроллеров, домен дедупликации vSAN масштабируется вместе с кластером, потенциально обеспечивая более высокую эффективность.
Улучшенное сжатие
В vSAN в составе VCF 9.1 введены новые методы сжатия, обеспечивающие значительно более высокие коэффициенты компрессии. Новый алгоритм одновременно быстр и эффективен: инженерная команда оптимизировала его для баланса между снижением избыточности данных и потреблением ресурсов. VCF 9.1 теперь обеспечивает более высокую степень сжатия при минимальном влиянии на производительность.
Что делает это особенно ценным? Новое сжатие применяется только к новым записям, поэтому оно может внедряться в среду без прерываний и включено по умолчанию.
В сочетании с глобальной дедупликацией это улучшение обеспечивает снижение совокупной стоимости владения на 39% по сравнению с традиционными внешними массивами.
Узлы ReadyNode для киберрезервного копирования с устройствами QLC
Сценарии резервного копирования — аварийное, операционное и киберрезервное — предъявляют к инфраструктуре иные требования, чем основное хранилище: меньше ресурсов процессора и памяти, но более высокая ёмкость. Хотя исторически ИТ при инвестициях в инфраструктуру резервного копирования ориентировались прежде всего на стоимость, изменившийся характер бизнеса потребовал повышенного внимания к производительности и времени восстановления. VCF 9.1 представляет узлы ReadyNode, оптимизированные для киберрезервного копирования с устройствами QLC (Quad-Level Cell), обеспечивающими оптимальный баланс плотности, производительности, выносливости и стоимости для данного сценария.
Эти сертифицированные конфигурации обеспечивают более высокую плотность хранения и консолидацию серверов, снижая стоимость гигабайта для полностью флэш-хранилища при одновременном сокращении потребления электроэнергии, охлаждения и площади стойки по сравнению с решениями на основе HDD. Это практичный ответ на задачу расширения инфраструктуры киберрезервного копирования без увеличения бюджетов.
Расширенная гибкость для кластеров хранения vSAN
Многие пользователи vSAN последовательно развивают свою инфраструктуру хранения, поэтому нередко используют сочетание vSAN Express Storage Architecture (ESA) и Original Storage Architecture (OSA). Клиенты хотят иметь возможность инвестировать в новую инфраструктуру, одновременно эксплуатируя старые кластеры vSAN до конца срока их службы. VCF 9.1 снимает прежние ограничения, позволяя монтировать новые хранилища ESA к кластерам OSA и давая вычислительным кластерам без хранения возможность монтировать как OSA, так и ESA. Клиенты могут расширять инфраструктуру для приложений на кластерах OSA без необходимости инвестировать в технологии предыдущих поколений.
Ещё более значимо следующее: кластеры хранения vSAN теперь могут совместно использоваться через границы vCenter — так же, как традиционные внешние массивы. Это позволяет максимизировать использование ёмкости, консолидировать развёртывания и увеличивать плотность при сохранении низкой совокупной стоимости владения.
Ускорение разработки современных приложений
Современные ИТ-команды поддерживают всё — от традиционных баз данных до контейнерных приложений и современных практик DevOps, — строго соблюдая соглашения об уровне обслуживания. vSAN в VCF 9.1 расширяет гибкость для удовлетворения этих разнообразных требований.
Нативное объектное хранилище S3 в vSAN (Technical Preview)
Впервые vSAN предоставляет нативное объектное хранилище, совместимое с S3, добавляя третий тип хранения — наряду с блочным и файловым — непосредственно в VCF. Данная версия Technical Preview ориентирована на сценарии использования в DevOps и конвейерах CI/CD, где разработчикам необходим быстрый самостоятельный доступ к масштабируемому объектному хранилищу.
Реализация включает мультитенантность, S3-бакеты как услугу и базовые функции безопасности и соответствия требованиям — всё это доступно через VCF Automation. В результате разработчики получают необходимую гибкость, а ИТ сохраняет управление и контроль. При этом решение включено в лицензии VCF, обеспечивая снижение совокупной стоимости владения на 34% по сравнению с автономными локальными продуктами объектного хранения.
Новые возможности самообслуживания разработчиков для работы с хранилищем
Значительное увеличение масштаба для постоянных томов
vSAN в VCF 9.1 существенно увеличивает масштаб контейнерных томов для сред VCF. Максимальное количество постоянных томов Read Write Once (RWO) на Supervisor возрастает с 7 500 до 25 000 — рост на 233%. На уровне vCenter лимит увеличивается с 30 000 до 50 000 постоянных томов, что составляет рост на 66%. Расширенные лимиты устраняют ограничения масштабирования для крупных развёртываний Kubernetes и мультитенантных сред.
Эффективное выделение ресурсов с помощью связанных клонов
Полные клоны слишком интенсивно используют хранилище и неэффективны для большинства сценариев. VCF 9.1 вводит поддержку связанных клонов для постоянных томов с First Class Disks, что существенно сокращает время выделения ресурсов и повышает операционную гибкость. Связанные клоны совместно используют общие базовые данные, что делает их идеальными для сред разработки, тестирования и сценариев, где необходимо быстро запустить несколько аналогичных рабочих нагрузок без затрат хранилища на полные клоны.
Поддержка Read Write Many (RWX) для виртуальных машин VM Service
Хотя файловые тома RWX могли использоваться в отдельных сценариях, они были недоступны для рабочих нагрузок — например, vSphere Pods и VM Service VMs — в пространстве имён Supervisor. VCF 9.1 устраняет этот пробел, позволяя виртуальным машинам VM Service монтировать и использовать тома RWX. Это открывает новые возможности для рабочих нагрузок, которым требуется совместный доступ к хранилищу сразу нескольких подов или виртуальных машин.
Единый подход к снимкам и операциям восстановления
Виртуальные машины VM Service теперь могут использовать простые операции восстановления по снимку VM, что приводит их в соответствие с традиционными виртуальными машинами. Такая согласованность упрощает рабочие процессы резервного копирования и восстановления вне зависимости от того, используются ли стандартные ВМ или машины VM Service — единый подход для всех рабочих нагрузок.
Соответствующие требованиям Kubernetes имена политик хранения
VCF 9.1 позволяет администраторам задавать настраиваемые имена политик хранения, совместимые с Kubernetes, при их создании. Это устраняет прежние ограничения именования, усложнявшие сопоставление политик хранения со StorageClass, упрощает согласование политик vSAN с соглашениями Kubernetes и улучшает опыт разработчиков.
Мультитенантное аварийное восстановление для машин VM Service
Облачные среды нередко обслуживают несколько команд или клиентов, каждый из которых требует независимых возможностей защиты и восстановления. VCF 9.1 вводит базовое мультитенантное аварийное восстановление (MTDR) для машин VM Service, предоставляя администраторам провайдеров и арендаторов возможность защищать виртуальные машины на базе Supervisor для сценариев защиты VCF-to-VCF.
Безопасность и киберустойчивость для современных угроз
Программы-вымогатели и утечки данных требуют хранилища, которое не только работает — но и защищает. vSAN в VCF 9.1 расширяет возможности защиты данных для долгосрочного хранения и комплексных сценариев восстановления.
Гибкое расписание снимков
В одном из предыдущих релизов нативные снапшоты vSAN получили возможность неизменяемости, а их производительность при масштабных и глубоких цепочках снапшотов — до 200 на ВМ — всегда оставалась высокой. vSAN в VCF 9.1 вводит гибкое расписание — широко известное как «дед–отец–сын» (GFS), — позволяющее расширить историю снимков для долгосрочного хранения в сценариях киберрезервного копирования.
Вместо того чтобы хранить каждый последовательный снимок, можно удерживать конкретные снимки с течением времени — например, почасовые снимки с сохранением одного за каждые 24 часа. Такой подход эффективно управляет ёмкостью, обеспечивая расширенную временную шкалу защиты, которую требуют нормативные и восстановительные требования.
Репликация из нескольких источников
Ранее репликация в VCF поддерживала только виртуальные машины, работающие с хранилища vSAN, на другое хранилище vSAN. В VCF 9.1 это ограничение снято: теперь можно реплицировать любую ВМ на базе VCF — включая те, что размещены на внешних массивах или других программно-определяемых хранилищах — в хранилище vSAN.
Эта возможность обеспечивает репликацию на основе политик по всей среде VCF, упрощая рабочие процессы восстановления и гарантируя согласованную защиту вне зависимости от текущего расположения ВМ. Репликацию можно совмещать с кластером киберрезервного копирования на базе vSAN для ускорения киберзащиты и восстановления.
Шифрование для глобальной дедупликации vSAN
Безопасность данных теперь распространяется на глобальную дедупликацию vSAN, гарантируя, что данные получают выгоду от экономии места без ущерба для защиты. Независимо от того, хранятся данные или передаются, они защищены шифрованием, валидированным по стандарту FIPS 140-3, от несанкционированного доступа.
Расширенные возможности растянутых кластеров
Растянутые кластеры уже давно обеспечивают устойчивость на уровне площадки для развёртываний vSAN. VCF 9.1 вводит два критически важных улучшения, повышающих операционную гибкость.
Во-первых, теперь можно перевести целый сайт в режим обслуживания с помощью управляемого процесса с расширенными предварительными проверками, обеспечивающими плавный вход и выход без прерывания сервиса. Во-вторых, в сценариях множественных отказов — когда один сайт находится в режиме обслуживания и одновременно происходит отказ второго сайта и свидетеля — теперь можно самостоятельно восстановить работоспособный сайт без обращения в глобальную службу поддержки. Встроенные предварительные проверки направляют процесс восстановления, сокращая время простоя и возвращая контроль в руки администраторов.
Упрощённые операции, масштабируемые с ростом инфраструктуры
Лучшая инфраструктура — та, о которой не нужно думать. VCF 9.1 реализует автоматизацию и интеллект, снижающие операционную нагрузку на ИТ-команды.
Проактивный мониторинг производительности vSAN
Диагностика проблем производительности в программно-определяемой инфраструктуре может быть непростой задачей. Где узкое место — в хранилище, вычислительных ресурсах или сети? VCF 9.1 применяет проактивный подход: постоянный мониторинг шаблонов производительности хранилища, установка базовых линий и оповещение об отклонениях.
При отклонении производительности от базовой линии VCF Operations использует расширенную аналитику для выявления корневых причин и предоставляет конкретные шаги по устранению — всё это доступно прямо в интерфейсе Performance Service. Алгоритмический подход к диагностике коррелирует точки данных, выявляет закономерности и предоставляет инсайты, поиск которых вручную занял бы часы.
Автоматизированное управление политиками хранения
vSAN в VCF 9.1 автоматически применяет наивысший уровень отказоустойчивости и оптимальный erasure coding с учётом размера кластера. Это устраняет неопределённость при настройке политик хранения и гарантирует максимальную устойчивость и эффективность без ручной настройки. В сочетании с улучшенными отчётами об эффективной ёмкости обеспечивается более чёткая видимость реальной используемой ёмкости, что делает планирование ёмкости более точным и понятным.
Расширенная диагностика хранилища vSAN
В одном из предыдущих выпусков в VCF Operations была представлена панель хранилища с важными метриками: оценками состояния, использованной ёмкостью и другими показателями. В vSAN в составе VCF 9.1 VCF Operations предоставит значительно расширенный набор информации и возможность принимать меры по диагностическим проблемам vSAN непосредственно из консоли VCF. Администраторам больше не придётся вручную перемещаться по интерфейсу для выявления корневых причин низких оценок состояния или определения способов устранения проблем — количество необходимых кликов сокращается до 60%.
vSAN в VCF 9.1 представляет собой значительный шаг вперёд в направлении более эффективного, гибкого, безопасного и интеллектуального хранилища для частного облака. Независимо от того, оптимизируете ли вы совокупную стоимость владения, поддерживаете разнообразные рабочие нагрузки, укрепляете устойчивость или упрощаете операции, этот релиз предоставляет практические возможности, решающие реальные ИТ-задачи.
Рабочие AI-нагрузки меняют экономику инфраструктуры. Из-за резкого роста спроса стоимость процессоров и памяти существенно возросла, что делает серверы дороже. Дополнительные расходы на оборудование затрудняют для ИТ-руководителей решение проблем производительности и ограничений ёмкости за счёт простого наращивания инфраструктуры. Успешные организации будут применять программно-определяемые стратегии, позволяющие извлечь максимальную ценность из уже имеющейся инфраструктуры. В новой реальности ИТ-специалисты, способные оптимизировать развёртывание инфраструктуры и операции второго дня, станут незаменимыми для обеспечения экономичной работы бизнеса.
С выходом VMware Cloud Foundation (VCF) 9.1 компания Broadcom обеспечивает организациям эффективное управление крупномасштабными средами частного облака. VCF Operations поможет снизить корпоративные риски за счёт упрощения процессов усиления защиты — благодаря более простым рабочим процессам исправлений. Предоставляя данные о состоянии и диагностике с централизованной видимостью VMware Security Advisories (VMSAs) и Common Vulnerabilities and Exposures (CVEs), VCF 9.1 обеспечит оперативное устранение уязвимостей, упростит управление жизненным циклом и предоставит ИТ-командам возможность проактивно укреплять общий уровень безопасности.
VCF Operations предоставит панели мониторинга с расширенной аналитикой ёмкости и конкретными рекомендациями по распределению памяти NVMe для оптимизации производительности. Кроме того, платформа предложит комплексный учёт затрат для VMware vSphere Kubernetes Service (VKS) и проактивное управление флотом для бесперебойной работы. VCF обеспечит единое представление, которое превратит реактивное управление инфраструктурой в высокооптимизированное и экономически эффективное преимущество.
VCF Operations создаёт бизнес-ценность, трансформируя управление инфраструктурой из реактивной нагрузки в стратегическое преимущество — для построения, управления, эксплуатации и защиты инфраструктуры частного облака. Операционные процессы второго дня будут улучшены: исправление, обновление, определение стоимости инфраструктуры, диагностика и многое другое.
Опираясь на унифицированное управление флотом для контроля в масштабе, упрощённые Day-2 операции для наблюдения и диагностики проблем в режиме реального времени, а также на расширенный уровень безопасности для непрерывного соответствия требованиям, организации превратят инфраструктуру из центра затрат в отказоустойчивый высокопроизводительный механизм. Расширенный уровень безопасности потребует дополнения VMware Advanced Cyber Compliance.
Рисунок 1 - Новое в VCF 9.1 для VCF Operations. VCF Operations обеспечивает эффективную инфраструктуру и операции в масштабе.
Данные опроса клиентов
Опрос Broadcom среди клиентов VCF 9 (n=44), проведённый в марте 2026 года, показывает, что модернизация частного облака связана с возвращением наиболее ценного ресурса команды — времени. Данные опроса свидетельствуют о том, что клиенты могут достичь следующих результатов в среднем:
Рисунок 2 - Средние результаты по данным опроса Broadcom среди клиентов VCF 9 (n=44) в марте 2026 года.
Опрос показал, что клиенты достигают в среднем 51% сокращения времени на управление инфраструктурой при использовании VCF 9, что позволяет командам переключиться с ручного обслуживания на эффективные операции. Объединив метрики, журналы и потоки в единой консоли, платформа сокращает среднее время мониторинга на 46%. Расширенная видимость обеспечивает среднее сокращение требуемой ёмкости на 47% по сравнению с предыдущими прогнозами. Даже при возникновении инцидентов VCF 9 ускоряет их устранение на 39% по показателям MTTR/MTTI благодаря интегрированным диагностическим панелям и возможностям анализа первопричин.
Быстрое развёртывание и масштабирование
С помощью VCF Installer клиенты смогут объединить существующую среду vCenter/ESX vSphere 8.0 Update 3 и выше с доменом управления VCF. С помощью VCF Operations клиенты смогут импортировать среды VMware vCenter 8.0 Update 3a (и выше) или VMware ESX 8.0 Update 3 (и выше) в рабочий домен VCF (VI). Оба подхода позволяют использовать существующую инфраструктуру и не требуют простоя или миграции приложений и данных.
Используя VCF Operations, организации с vSphere 8.0 Update 3 или выше смогут легко интегрировать существующий vCenter в качестве рабочего домена в VCF 9.1, обеспечивая непрерывность бизнеса и получая возможности корпоративного управления. Среда VCF будет работать под управлением VCF 9.1, а VCF Operations сможет управлять более старой средой vSphere 8.0 Update 3 или выше для управления жизненным циклом, обеспечивая бесперебойную работу бизнес-приложений.
Расширенный масштаб управления позволит одному экземпляру поддерживать до 5 000 хостов ESX, что в 2 раза больше по сравнению с предыдущим релизом.
VCF 9.1 предложит 4-кратное увеличение параллельной ёмкости обновлений с поддержкой до 256 кластеров одновременно. Это существенно сократит время простоя и позволит операторам выполнять задачи обслуживания значительно быстрее в рамках запланированных окон.
VCF Operations объединит исправление и обновление всех компонентов в единый интерфейс управления жизненным циклом. С этой централизованной панели можно будет комплексно планировать устранение критических CVE, планировать и выполнять обновления как для глобальных компонентов флота VCF, так и для рабочих доменов. VCF Operations предоставит планы обновлений с указанием количества шагов и точной последовательности их выполнения, устраняя необходимость угадывать при планировании окон обслуживания. Поскольку VCF полностью интегрирует последние инновации в области исправлений vSphere и ESX, эти комплексные рабочие процессы можно выполнять с полной уверенностью в минимальном или нулевом операционном воздействии на работающие нагрузки.
В VCF 9.1 модуль диагностики работоспособности VCF Operations введёт публичные API, позволяющие настраивать данные из результатов проверок. Это обеспечит бесшовную интеграцию диагностических данных в режиме реального времени с существующими процессами, например, с системами управления заявками и платформами управления рисками.
В данном выпуске представлены сервисы управления VCF — централизованный набор инфраструктурных компонентов, размещённых в выделенной среде выполнения сервисов. Это обеспечит унифицированное управление жизненным циклом, идентификацией и операциями для VCF. Каждый экземпляр VCF будет включать сервисы управления: управление жизненным циклом, программное хранилище, управление журналами и данные в режиме реального времени. Вместо работы в виде отдельных устройств эти сервисы будут распределены на общей среде выполнения. Среда выполнения сервисов VCF служит общей архитектурной основой для сервисов управления и развёртываний VCF Automation.
VCF 9.1 представит унифицированный сервис программного хранилища, использующий токены OAuth для безопасного управления обновлениями как в подключённых, так и в изолированных средах.
Управление флотом в масштабе
Рисунок 4 - Панель VCF Operations в VCF 9.1 обеспечивает глобальный обзор.
VCF 9.1 представит ряд ключевых улучшений для упрощения внедрения. Управление распределённой инфраструктурой не будет умножать рабочую нагрузку. VCF 9.1 централизует контроль над всем флотом частного облака, превращая десятки отдельных задач в единые операции.
Для лицензирования VCF 9.1 в режиме подключения не потребуется ручных действий. В подключённом режиме администраторы VCF 9.0 ранее должны были вручную подтверждать обновлённые файлы лицензий каждые 180 дней или менее. VCF 9.1 реализует автоматическую загрузку файлов лицензий каждые 24 часа в подключённом режиме. После выбора подключённого режима автоматизация становится поведением по умолчанию. Данные об использовании лицензий передаются в Broadcom, а обновлённый файл лицензии загружается и применяется автоматически — без вмешательства администратора.
Оптимизированное управление идентификацией и доступом предоставит назначение ролей на уровне VCF с интегрированными конфигурациями SSO и поставщика удостоверений. Управлять доступом ко всему флоту можно будет из единой точки контроля.
Управление жизненным циклом и конфигурацией обеспечит применение политик на уровне всего флота с детальной видимостью изменений конфигурации и отклонений в экземплярах VCF, vCenter и отдельных кластерах. Для проверки готовности среды к обновлению будут выполняться предварительные проверки. VCF запустит их для выявления проблем, которые могут привести к сбою обновления. Комплексные проверки оценивают общее состояние системы, достаточность ресурсов и другие параметры.
Для сред VxRail ключевые возможности Days 0, 1 и 2, ранее обрабатывавшиеся Dell VxRail Manager, теперь можно будет управлять с помощью VCF Operations на узлах vSAN ReadyNodes.
Массовые операции устранят повторяющуюся ручную работу. Операции с сертификатами, импорт и продление выполняются одновременно для всех компонентов VCF. То, что раньше занимало часы, теперь займёт минуты.
Интеграция с хранилищем паролей обеспечит управление паролями на основе политик через стандартные публичные API, а также новую интеграцию с хранилищем паролей CyberArk, гарантируя согласованность политики паролей в VCF и остальной инфраструктуре. Это упростит ротацию паролей и обслуживание в среде VCF.
Рисунок 5 - VCF 9.1 предоставит детализацию затрат VMware vSphere Kubernetes Service (VKS), что улучшит возможности анализа, выставления счетов, учёта расходов и распределения затрат для современных рабочих нагрузок.
Интеллектуальная оптимизация ёмкости и затрат предоставит практические рекомендации. Рекомендации по распределению памяти на кластерах NVMe позволят количественно оценить экономию и повышение плотности виртуальных машин. В этом выпуске также появится поддержка анализа What-If для распределения памяти NVMe. Расширенное управление затратами VKS предоставит учёт расходов, распределение затрат и оценку цен в режиме реального времени — финансовую видимость, которую требует современная ИТ-служба. VCF следует операционной методологии FinOps Open Cost and Usage Specification (FOCUS) для частного облака, обеспечивающей стандартизированный формат данных о счетах для улучшенного распределения затрат и ускоренного анализа.
Упрощение операций второго дня
Глубокая наблюдаемость станет основой надёжных операций. VCF 9.1 обеспечит ИТ-команды видимостью в режиме реального времени и интеграциями, готовыми к использованию с AI, необходимыми для более быстрого устранения неполадок и поддержания работоспособности критически важных приложений.
Наблюдаемость в реальном времени теперь будет собирать метрики в секундах с настраиваемым интервалом сбора до 2 секунд для хостов ESX. Для критических рабочих нагрузок своевременные данные позволят проактивно улучшить работу бизнес-приложений.
Централизованное управление журналами объединит агрегацию журналов с расширенными панелями и бесшовной пересылкой в сторонние решения. Интерфейс журналов будет полностью интегрирован в VCF Operations. Поиск проблем в разных интерфейсах станет ненужным — всё будет доступно в одном месте для всех компонентов VCF.
Проактивная диагностика поможет предупреждать проблемы вместо реагирования на сбои. VCF 9.1 позволит использовать улучшенные панели работоспособности VCF и расширенную диагностику vSAN для выявления потенциальных проблем производительности. Диагностика будет выделять ключевые проблемы для vCenter, хостов ESX, vSAN и VCF Networking в NSX Manager и узлах Edge: проблемы с подключением, работоспособностью сервисов, использованием ресурсов и другие.
Management Pack Builder позволит создавать интеграции со сторонними системами без написания кода для расширения видимости инфраструктуры. VCF 9.1 также обеспечит прямую интеграцию с Prometheus Server Management Pack для расширения набора метрик и данных, доступных для мониторинга.
В VCF 9.1 Operations представляет собой платформу, готовую к интеграции с AI, через API для подключения к пайплайнам Retrieval-Augmented Generation (RAG) и фреймворкам Model Context Protocol (MCP). Это позволит клиентам экспортировать аналитику из дата-лейка инфраструктуры в другие AI-системы, например, в AIOps-движки для прогностического анализа. Встроенный мониторинг и управление журналами для кластеров VMware vSphere Kubernetes Service (VKS) обеспечат операционную видимость современных Kubernetes-рабочих нагрузок на том же уровне, что и существующие виртуальные машины.
Безопасные операции
Управление уровнем безопасности выполнит комплексные оценки соответствия по всему флоту VCF с простыми средствами устранения несоответствий для приведения инфраструктуры к требуемым эталонным показателям. Поддерживается соответствие стандартам Payment Card Industry (PCI) и Security Baseline. Управление уровнем безопасности потребует дополнительной услуги Advanced Service надстройки VMware Advanced Cyber Compliance.
Распределённые рабочие нагрузки и расширение ИИ-инициатив создают растущую поверхность атаки. VCF 9.1 интегрирует расширенную услугу надстройки VMware Advanced Cyber Compliance в пользовательский интерфейс VCF Operations. С её помощью автоматическое отслеживание соответствия требованиям станет частью операционных рабочих процессов.
VCF обеспечит аудиторские следы для ускорения расследования инцидентов на основе стандартизированных архитектур журналов и централизованных исторических данных. При возникновении событий безопасности будут доступны криминалистические данные для понимания произошедшего. Аудиторскую запись можно развернуть по временным интервалам и экспортировать в виде CSV-файла.
Расширенная панель SecOps предоставит обзор проблем безопасности: предупреждения, статус шифрования рабочих нагрузок, состояние функций конфиденциальных вычислений на подходящих хостах и другие параметры.
От реактивных задач к проактивным операциям
VCF 9.1 выходит за рамки инкрементальных обновлений. Через VCF 9.1 Broadcom предоставляет консолидированное управление, глубокую наблюдаемость и простое устранение несоответствий требованиям — чтобы ИТ-команда тратила меньше времени на обслуживание и больше на то, что действительно важно.
Управление облачными расходами исторически представляло собой фрагментированный процесс: каждый провайдер использует собственный формат, схему и терминологию. Это создаёт своеобразный «налог на перевод» — организации тратят значительную часть времени на очистку и нормализацию данных вместо их анализа и оптимизации. FinOps-командам приходится вручную согласовывать данные из публичных облаков, SaaS-сервисов и внутренних систем, прежде чем возможен какой-либо полноценный анализ. Для решения этой проблемы был разработан стандарт FOCUS — единая спецификация учёта затрат и потребления.
В Broadcom убеждены, что финансовая прозрачность должна быть стратегическим преимуществом, а не источником ручной работы. Именно поэтому VCF 9.1 реализует поддержку FinOps Open Cost & Usage Specification (FOCUS) — глобального стандарта, позволяющего привести разрозненные данные о затратах к единому виду для сопоставимого анализа.
Что такое FOCUS?
FOCUS можно сравнить с универсальным обменником валют для управления облачными расходами. Подобно тому как обменные курсы позволяют сравнивать цены в разных странах, FOCUS даёт возможность сопоставлять затраты у всех облачных провайдеров в едином формате. Разработанный FinOps Foundation, этот открытый стандарт устраняет необходимость в многонедельном ручном переводе данных, позволяя командам видеть все облачные расходы в единой сопоставимой форме.
Как работает FOCUS
FOCUS нормализует биллинговые данные из различных источников, сокращая объём работы, необходимой для начала FinOps-анализа, и позволяя переключить усилия на более стратегические задачи. Стандарт упрощает FinOps-цикл, приводя разрозненные данные о выставлении счетов из облачных, SaaS- и внутренних источников к согласованному, удобному для работы формату — как для генераторов данных, так и для их потребителей. Упрощение процесса получения данных позволяет организациям перейти от ручной обработки к стратегическим результатам: оптимизации затрат и оценке бизнес-ценности.
Кто использует FOCUS
FOCUS формирует общий словарь, устраняющий разрыв между генераторами биллинговых данных (облачными и SaaS-провайдерами) и их потребителями (FinOps-специалистами).
Этот общий язык позволяет командам эффективно обрабатывать и анализировать сложные наборы биллинговых данных, обеспечивая прозрачность коммуникации и более результативную оптимизацию технологических расходов.
Преимущества FOCUS
FOCUS повышает эффективность всей FinOps-экосистемы за счёт стандартизации биллинговых данных, позволяя специалистам и поставщикам инструментов переключиться с ручной нормализации на стратегические задачи.
Организации получают возможность принимать комплексные решения на основе данных при меньших операционных затратах, а технологические провайдеры — ускорить внедрение продуктов благодаря общей прозрачной терминологии.
Актуальность в 2026 году
Финансовая прозрачность перестала быть опцией — наступила точка перелома. По данным исследования The Linux Foundation, конкурентная среда к 2026 году кардинально изменилась:
98% команд теперь управляют расходами на AI - резкий рост по сравнению с 31% в 2024 году.
78% FinOps-специалистов подчиняются напрямую CTO или CIO, что свидетельствует о стратегическом повышении роли управления затратами.
Более $83 млрд облачных расходов отслеживается с использованием стандартизированных практик.
Бизнес-ценность FOCUS
FOCUS создаёт значительную бизнес-ценность, обеспечивая отслеживание затрат на AI и GPU-нагрузки в реальном времени, автоматизированное устранение избыточных расходов и формирование стратегических дашбордов для руководства в рамках VMware Cloud Foundation.
Консолидация финансовых функций и управления мощностями позволяет даже небольшим командам масштабировать операции и устранять неожиданные расходы посредством упреждающего анализа. Этот подход обеспечивает основанную на данных базу для достижения полной видимости и контроля над гибридными облачными инвестициями.
VCF + FOCUS = 100% покрытие сценариев использования
VCF Operations обеспечивает 100-процентное покрытие стандартных FinOps-сценариев, определённых спецификацией FOCUS. Восемь возможностей доступны «из коробки», ещё четыре легко настраиваются — таким образом, инфраструктура частного облака на базе VCF Operations полностью соответствует глобальным стандартам.
Заключение: финансовая ясность как конкурентное преимущество
VMware Cloud Foundation в связке с глобальным стандартом FOCUS устраняет разрыв в видимости между частным и публичным облаком. Нормализация телеметрии VCF в соответствии со схемой FOCUS позволяет организациям впервые проводить прямое, сопоставимое сравнение затрат по всему гибридному ландшафту. VCF выступает прозрачным движком данных, позволяя сравнивать стоимость локальных рабочих нагрузок с альтернативами у гиперскейлеров с высокой точностью. При стопроцентном покрытии сценариев использования и отслеживании в реальном времени организации получают финансовую ясность, необходимую для стратегического выбора наиболее экономичного размещения каждой рабочей нагрузки и уверенного управления корпоративными инвестициями.
Платформа VMware Cloud Foundation (VCF) заметно прогрессирует от выпуска к выпуску. Версия 9.1 продолжит развитие возможностей, заложенных в VCF 9.0, и предложит более совершенный опыт потребления в рамках модели самообслуживания (self-service) частного облака.
По данным опроса заказчиков Broadcom, проведённого в марте 2026 года и посвящённого оценке VCF 9, компании, применяющие VCF Automation, добились двух существенных результатов. Во-первых, промежуток времени от запроса до готовой к использованию прикладной среды сократился на 49%. Во-вторых, ручные усилия по сопровождению жизненного цикла приложений — от разворачивания и обновления до установки патчей и изменения конфигурации — уменьшились ещё на 49%.
В VCF 9.1 этот фундамент будет расширен новыми возможностями автоматизации, призванными ещё сильнее ускорить выпуск приложений, снизить затраты и масштабировать управляемость и соответствие требованиям в рамках всего предприятия. Далее рассматриваются три ключевых направления, по которым VCF 9.1 преобразит подходы к предоставлению и потреблению сервисов частного облака.
1. Ускоренное развёртывание благодаря расширенным сервисам
Container as a Service
В VCF 9.1 ускорение развёртывания контейнеров достигается за счёт чёткого разделения трёх вариантов исполнения — VM Service, Container Service и VMware vSphere Kubernetes Service (VKS). Такое разграничение позволяет подобрать подходящий runtime под конкретную нагрузку без излишних сложностей.
VCF Automation обеспечит доступ к Container Service с полным управлением жизненным циклом. Разворачивать, настраивать, отслеживать, обновлять и удалять контейнеры можно будет прямо через интерфейс — без команд kubectl, без YAML-файлов и без необходимости разбираться в Kubernetes API. Контейнеры станут полноценными runtime-сущностями наряду с виртуальными машинами и кластерами VKS.
Такой упрощённый контейнерный runtime обеспечит высокую гибкость без операционных издержек, связанных с инфраструктурой Kubernetes. Он будет работать непосредственно на ESX без накладных расходов на кластер, предоставляя изоляцию нагрузок и эффективное использование ресурсов в управляемом, по сути serverless-режиме. Платформа VCF полностью автоматизирует планирование, изоляцию, оптимизацию производительности и обновления. Когда архитектура приложения будет развиваться, интерфейс сформирует согласованный YAML, обеспечивающий плавный переход к кластерам VKS — мягкий путь от простых развёртываний контейнеров к полноценным возможностям Kubernetes.
VCF Automation: интерфейс развёртывания Container Service
Fast Deploy для VKS и виртуальных машин
В VCF 9.1 появится механизм Fast Deploy, существенно ускоряющий выделение виртуальных машин и кластеров VKS. После обновления функция автоматически активируется для каждой ВМ, разворачиваемой из blueprint, и не требует настройки в интерфейсе. Работая прозрачно через YAML, она ускорит все жизненные операции на базе виртуальных машин, в том числе развёртывания VM Service и инициализацию кластеров VKS.
Fast Deploy получит два режима под разные сценарии. Linked-Mode использует цепочку связанных клонов с delta-disk и обеспечит мгновенное включение виртуальной машины, при этом полный диск формируется асинхронно в фоне — это сокращает и время развёртывания, и расход хранилища. Direct-Mode ускоряет выделение в зависимости от размера образа ВМ и числа параллельных операций, давая более быстрое развёртывание в масштабе с сохранением полной целостности диска с самого начала.
Развёртывание кластеров VKS заметно ускорится — с 37 минут до 11 минут, то есть на 69%. Обновления кластеров будут выполняться на 75% быстрее: 1,7 часа вместо 6,9 часа, что экономит более 5 часов на каждый цикл обновления. Команды разработки приложений смогут применять Fast Deploy, чтобы по запросу поднимать среды разработки, динамически масштабировать нагрузки, оперативно создавать тестовые окружения, повторяющие промышленные среды, а также быстро разворачивать многоуровневые приложения.
VCF Automation: рабочий процесс Fast Deploy
Централизованное управление сервисами и новые встроенные сервисы
Работа с расширяемыми сервисами в частном облаке станет централизованной и более простой. В VCF 9.1 появится усовершенствованное управление сервисами, опирающееся на региональный экземпляр Harbor для упрощения развёртывания и сопровождения сервисов по всей платформе. Service Manager будет получать и отображать содержимое сервисов непосредственно из этого реестра, благодаря чему расширится круг сервисов, подключаемых и публикуемых для арендаторов.
Вместе с релизом будут поставляться десять предустановленных сервисов, автоматически синхронизируемых в составе базовой конфигурации платформы. Они отображаются в интерфейсе в виде отдельных плиток: Harbor, VMware Data Services Manager, Secret Store Service, сервис автоподключения для управления кластерами VKS (Auto-Attach Service), Encryption Management (BYOK) и другие.
Такой централизованный подход обеспечит более быстрый доступ к возможностям платформы: сервисы доступны по умолчанию и сразу пригодны к использованию через интерфейс. Это позволит ускорить внедрение во всех регионах и упростить эксплуатацию за счёт централизованных обновлений и сокращения ручной административной работы, что приведёт к согласованности окружений.
VCF Automation: интерфейс управления сервисами
Расширенный Day-2 жизненный цикл виртуальных машин
В VCF 9.1 потребители смогут самостоятельно изменять конфигурацию CPU, памяти, хранилища и сети уже после развёртывания. Среди расширенных возможностей — изменяемость сети, снапшоты и VM Groups. Это устранит административные узкие места и сократит циклы обслуживания заявок с дней до минут.
Сетевые улучшения
Расширенное управление IP для провайдеров и арендаторов
Арендаторы смогут самостоятельно резервировать IP-адреса и управлять ими с поддержкой нескольких CIDR и интеграцией с Infoblox. Это позволит реализовывать сложные сетевые конфигурации, например NAT «один к одному», без зависимости от рабочих нагрузок.
Гибкие Transit Gateway для сложных топологий маршрутизации
VCF 9.1 даст возможность создавать множественные внешние подключения и несколько Transit Gateway на одного арендатора с изолированными VPN, статическими маршрутами и пользовательскими настройками NAT. Это позволит гибко выстраивать межсайтовую маршрутизацию и точно управлять трафиком без внешнего маршрутизирующего оборудования.
Самообслуживание по сети и безопасности для арендаторов
В VCF 9.1 будет доступно сетевое самообслуживание, предоставляющее прямой доступ к ЦОД, выведение частных сетей, развертывание VPN и Gateway Firewall. Это расширит возможности арендаторов и позволит им самостоятельно управлять сетевой безопасностью.
Общие подсети и VLAN-расширения
В VCF 9.1 появятся подсети уровня организации и расширения VLAN с прямым подключением на уровне L2. Это откроет путь к сложным сетевым архитектурам, включая виртуальные машины с несколькими сетевыми адаптерами и прямое подключение к физической фабрике на уровне нагрузок арендатора.
Подключение к существующим VLAN через распределённые Transit Gateway
VCF 9.1 представит распределённые Transit Gateway, которые подключают VPC напрямую с хостов ESX с использованием только идентификатора VLAN, без Edge-кластеров и динамической маршрутизации. Это упростит эксплуатацию для унаследованных VLAN-окружений и обеспечит прямую коммуникацию между виртуальными машинами VCF и не-NSX ВМ.
Упрощённые межсетевые экраны и автоматизированная безопасность между VPC
VCF 9.1 позволит реализовать модель Zero Trust с автоматизированной микросегментацией, правилами межсетевого экрана и метками соответствия с использованием vDefend. Это даст автоматизированную безопасность с первого дня, исключая ручную настройку и обеспечивая единообразное применение политик.
2. Улучшенное управление жизненным циклом приложений и нагрузок
App Stack Formation
В VCF 9.1 будет реализован сценарий формирования прикладного стека (App Stack Formation) — принципиально новый подход к созданию blueprint. Он позволит пользователям зафиксировать работающую топологию — группу ВМ, их сетевую конфигурацию и диски — в виде единого blueprint. Эта возможность превратит живые среды приложений в переиспользуемые шаблоны, обеспечивая мгновенную, идентичную и масштабируемую доставку сервисов.
Вместо повторной сборки среды с нуля платформенные инженеры смогут фиксировать работающие ВМ вместе с их сетевыми настройками (VPC, подсети), дисками хранения (PVC), параметрами гостевой ОС и зависимостями между ВМ. Также можно будет задать последовательности запуска и остановки виртуальных машин внутри стека, чтобы многоуровневые приложения запускались в правильном порядке. Многоуровневые приложения будут собираться в единый переносимый пакет OVF/OVA, что устранит расхождения между средами Dev, Test и Prod. Управление всем прикладным стеком как одним объектом упростит операции старта/остановки и снапшотов с поддержкой заданного порядка включения. Провайдеры смогут предлагать готовые прикладные стеки через каталоги, развивая самообслуживание для арендаторов и сокращая время вывода новых сервисов на рынок.
VCF Automation: рабочий процесс App Stack Formation
В VCF 9.1 появится встроенная интеграция с библиотеками контента Canonical, обеспечивающая поставку оптимизированных под VCF образов Ubuntu LTS. В эти образы включены пакеты — драйверы ВМ и инструменты, необходимые для успешного развёртывания и работы поверх VCF; они входят в базовую лицензию VCF для клиентов с активной подпиской.
Интерфейс обеспечит удобный поиск и выбор образов Ubuntu непосредственно в VCF Automation, избавляя пользователей от необходимости переходить на внешние сайты для поиска и импорта этих образов. Корпоративные ИТ-администраторы смогут подписаться на сопровождаемые Canonical библиотеки контента и автоматически синхронизировать официальные образы Ubuntu (например, 24.04 LTS) прямо в окружение, пополняя VM Images без ручных загрузок. Это обеспечит стабильность развёртываний, повышенный уровень безопасности и операционную эффективность за счёт эффективного управления патчами для критических уязвимостей и уязвимостей высокого уровня. Broadcom будет включать актуальные патчи в полные образы и размещать их в каталоге решений, гарантируя автоматическую поставку официального и проверенного контента. Клиенты получат упрощённый доступ к доверенным образам Ubuntu через защищённое нативное подключение.
VCF Automation: библиотека контента Canonical
Библиотеки контента на уровне проектов для автономии команд
В VCF 9.1 будут реализованы Project-level Content Libraries: администраторы организации смогут создавать отдельные библиотеки контента и явно привязывать их к одному или нескольким выбранным проектам внутри организации. После создания система предоставит право записи администраторам проектов и продвинутым пользователям проектов, позволяя им непосредственно публиковать, писать и управлять образами (например, ISO и OVA) в рамках выделенной библиотеки.
Это обеспечит автономию, снизив зависимость команд проектов от администраторов организации в части курирования и сопровождения библиотек контента, специфичных для проектов и приложений. Также появится возможность расширения: можно будет применять процессы Packer, в которых участники проектов публикуют собственные образы ВМ. Дополнительно VI-администраторы смогут использовать существующие шаблоны ВМ для построения библиотек контента VCF Automation без необходимости создавать новые образы. Это устранит операционное узкое место, при котором команды проектов прежде не могли управлять собственными библиотеками или напрямую загружать необходимые файлы вроде ISO и OVA, что в итоге шло вразрез с идеей потребительского самообслуживания и тормозило гибкую разработку.
VCF Automation: управление библиотекой контента проекта
Дополнительные возможности
Делегирование пространств имён и управление
VCF 9.1 позволит администраторам организации делегировать создание пространств имён администраторам проектов и платформенным инженерам с заранее определёнными ограничениями. Это устранит заторы, давая прикладным командам возможность самостоятельно управлять пространствами имён при сохранении управляющего контроля.
Расширения Terraform Provider для арендаторов в политике и управлении контентом
В VCF 9.1 будет расширен Terraform Provider с поддержкой полного развёртывания окружений, управления жизненным циклом образов ВМ и реализацией политик как кода, Day-2-операций и IaaS. Это позволит программно применять политики и реализовывать сценарий App Stack Formation через подход infrastructure-as-code.
3. Усиленное управление, безопасность и прозрачность затрат
Новые политики размещения инфраструктуры для лучшего контроля над нагрузками
В VCF 9.1 появятся политики размещения инфраструктуры, позволяющие администраторам задавать критерии размещения виртуальных машин с учётом их атрибутов и нацеливаться на конкретные подмножества ВМ. Система поддержит обязательный режим политики, который автоматически применяется при назначении организации и помогает гарантировать исполнение заданных правил размещения без участия арендатора.
Новые политики размещения инфраструктуры позволят оптимизировать лицензирование за счёт размещения по типу ОС и упростят соблюдение требований, давая инструменты для точного контроля того, где именно располагаются нагрузки, что облегчит соответствие нормативным или внутренним стандартам. Дополнительно это поможет облачным администраторам обеспечивать оптимальное размещение нагрузок для соответствия требованиям без ограничения возможностей самообслуживания.
Политики размещения обеспечат автоматическое распределение нагрузок по конкретным хостам на основе атрибутов вроде гостевой ОС или меток, гарантируя, что определённые типы ВМ последовательно попадают на наиболее подходящую или предназначенную для них инфраструктуру. Обязательный режим политики обеспечит строгое исполнение размещения ВМ согласно требованиям рабочих нагрузок в мультиарендных средах при сохранении управляемости через политическое регулирование.
VCF 9.1 будет выводить данные о затратах прямо в панелях управления Org и Project, позволяя администраторам видеть совокупные затраты на этих уровнях и переходить к детализации по конкретным затратам и инвентарю для отдельных проектов и пространств имён. VCF Automation предложит предварительную тарификацию (оценку стоимости по rate card VCF Operations) в рамках процесса развёртывания, давая администраторам возможность назначать цены сервисам частного облака, таким как VM Service и VKS Service. VCF Automation поддержит оповещения и отчёты по электронной почте. Администраторы смогут указывать конкретные адреса для получения уведомлений по биллингу, отчётам о затратах и критическим оповещениям — в частности, по квотам или доступности сервисов — с возможностью формирования и прямой загрузки отчётов и счетов.
Расширенная прозрачность с подробной детализацией затрат по проектам и пространствам имён поможет организациям управлять потреблением и снижать неэффективные капитальные расходы. Платформа будет формировать культуру осознанного отношения к затратам и финансовую подотчётность, позволяя потребителям и арендаторам видеть стоимость развёрнутых ими ресурсов, а администраторы получат проактивные уведомления по электронной почте без необходимости вручную следить за системой.
VCF Automation: панель прозрачности затрат
Полностью выделенные региональные квоты для организаций-арендаторов
В VCF 9.1 появится механизм полностью выделенной региональной квоты, позволяющий корпоративным ИТ-администраторам выделять всю ёмкость региона (квоту 100%) одной организации-арендатору без привязки к конкретным зонам. Администраторы смогут применять одинаковые лимиты и резервации CPU и памяти ко всем доступным зонам, отвязывая регион от единственного Supervisor и допуская наличие нескольких Supervisor и vCenter в рамках одной региональной квоты. Эти возможности упростят выделение ресурсов и облегчат управление инфраструктурой для предприятий, которым не требуется строгое исполнение квот.
В режиме Day 2 администраторы смогут изменять выделения, добавляя резервации или уменьшая квоту с полного региона до конкретных лимитов. Это превратит регион в единый пул ресурсов, позволяя организациям потреблять инфраструктуру в нескольких Supervisor вместо ограничения одним. Организации получат совместный доступ к инфраструктурной ёмкости по принципу первой очереди, что повысит гибкость и эффективность использования ресурсов в рамках окружения.
VCF Automation: распределение региональных квот
Единый API управления кластерами VKS
VCF 9.1 стандартизирует API управления кластерами VKS, приведя его к шаблону VCF API и объединив управление ВМ, контейнерами и VKS. Это обеспечит согласованное взаимодействие со всеми сервисами и упростит управление ресурсами через VCF CLI, Terraform или kubectl.
VCF 9.1 переопределит возможности инфраструктуры частного облака. Благодаря VCF Automation, VMware Cloud Foundation поможет запустить и масштабировать мультиарендное частное облако, в котором прикладные команды смогут собирать рабочие нагрузки быстрее, безопаснее и с меньшими затратами. Будь то воспроизведение масштабируемости и гибкости публичного облака в собственном ЦОД, внедрение единого интерфейса потребления для виртуальных машин и контейнеров либо повышение гибкости бизнеса и ИТ за счёт самообслуживания — VCF 9.1 предоставит необходимые инновации.
Будущее корпоративных ИТ уже здесь: настоящий облачный опыт в сочетании с безопасностью, производительностью и контролем частного облака. VCF 9.1 предоставит платформу, возможности и автоматизацию для превращения ЦОД в современное самообслуживаемое частное облако, расширяющее возможности прикладных команд при сохранении управления и соответствия требованиям, необходимых корпоративному ИТ.
Вышла новая версия VMware Cloud Foundation 9.1, об этом вы уже знаете. В этой статье рассматриваются многие новые возможности и улучшения платформы vSphere в составе пакета VCF 9.1. Также рекомендуем ознакомиться с примечаниями к выпуску и уведомлениями о поддержке продуктов для получения важной информации.
Быстрое развёртывание патчей безопасности vCenter
Функция быстрого патчинга vCenter (vCenter Quick Patch) обеспечивает оперативное применение обновлений с минимальным, а в ряде случаев — нулевым временем простоя. Уровень простоя зависит от того, какие именно сервисы подвергаются обновлению. Механизм Quick Patch ориентирован на быстрое устранение критических уязвимостей безопасности в vCenter.
Традиционный in-place патчинг обновляет все RPM-пакеты на vCenter вне зависимости от того, изменился ли соответствующий сервис или компонент. Quick Patch затрагивает только те RPM или бинарные файлы, которые действительно изменились в составе патча. Такой подход кардинально сокращает общее окно обслуживания и снижает время простоя vCenter до менее чем 1 минуты, а в ряде случаев сводит его к нулю.
Благодаря vCenter Quick Patch критически важные обновления безопасности можно применять без прерывания рабочих процессов: развёртывание виртуальных машин и кластеров Kubernetes продолжается в штатном режиме, автоматизированные сценарии и API-вызовы не прерываются. Меньше времени уходит на планирование окон обслуживания — больше на поддержание актуальности патчей.
Помимо Quick Patch, в версии 9.1 улучшены и другие аспекты обслуживания vCenter.
Обновление vCenter с сокращённым временем простоя (Reduced Downtime Upgrade, RDU) теперь поддерживает работу с онлайн-репозиторием. Это упрощает использование метода RDU для подключённых к интернету экземпляров vCenter. Автономный метод с использованием примонтированного ISO по-прежнему доступен. Последующие патчи, обновления и апгрейды vCenter 9.1.x и более поздних версий также можно применять через RDU с онлайн-репозиторием, что значительно упрощает эксплуатацию для подключённых инсталляций.
В vCenter появился новый API, с помощью которого сторонние компоненты могут получать уведомления о планируемом или текущем техническом обслуживании. Обратный прокси Envoy будет отдавать заголовок 503 с информацией о том, что vCenter находится на обслуживании, и указанием ожидаемого времени завершения.
При выполнении мажорных апгрейдов (с 8.x до 9.1.0) или минорных обновлений (с 9.0.x до 9.1.0) методом RDU версия аппаратного обеспечения виртуальной машины vCenter автоматически повышается с версии 10 до версии 17, поскольку создаётся новая ВМ vCenter. При выполнении in-place обновления (с 9.0.x до 9.1.0) версию аппаратного обеспечения ВМ vCenter потребуется обновить вручную — эта процедура требует выключения ВМ vCenter.
Изменение ресурсов vCenter через единый API
В VCF 9.1 появился новый API, упрощающий масштабирование ресурсов vCenter. Для увеличения объёма вычислительных ресурсов и дискового пространства vCenter достаточно одного вызова API и перезагрузки.
Вызов API можно инициировать из Developer Center API Explorer в интерфейсе vCenter. API называется deployment/size и использует метод PATCH.
Упрощение обслуживания хостов ESX
Образы, создаваемые и управляемые через vSphere Lifecycle Manager, теперь включают контрольную сумму SHA256. Она позволяет проверять целостность образов при экспорте и импорте в другие экземпляры vCenter: администратор может сравнить контрольные суммы на источнике и целевом сервере. Речь идёт о контрольной сумме именно определения образа, а не VIB-файлов ESX.
В предыдущих версиях vSphere Lifecycle Manager проверял актуальность прошивок и драйверов устройств по HCL только при наличии стороннего Hardware Support Manager (HSM). Начиная с версии 9.1 вывод информации о текущих драйверах и прошивках устройств, а также их валидация по HCL выполняются для кластеров vSAN даже в отсутствие HSM. Некоторые устройства могут не сообщать данные о прошивке без соответствующего HSM. Это обеспечивает базовый уровень проверки устройств в кластере vSAN.
Подготовка кластеров vSphere с образом и конфигурацией
Zero Touch Provisioning (ZTP) строится на базе существующей инфраструктуры vSphere Auto-Deploy. Механизм задействует современные протоколы загрузки — UEFI HTTP/S Boot — и поддерживает актуальные серверные конфигурации, включая Secure Boot и TPM. ZTP не требует внешнего TFTP-сервера: достаточно настроить URL загрузки UEFI, указывающий на vCenter, и загрузить хост по сети. Если UEFI не поддерживает настройку статического IP для загрузки, потребуется DHCP-сервер.
Образ ESX и конфигурация определяются расположением кластера, выбранным при настройке правила развёртывания. Если для целевого кластера не настроен профиль конфигурации vSphere (VCP), хост загрузится и присоединится к кластеру с конфигурацией по умолчанию.
Быстрое и менее затратное обновление кластеров vSphere
ESX Live Patch включён по умолчанию для всех кластеров и автоматически применяется, если устанавливаемый патч поддерживает этот режим. Если патч несовместим с Live Patch, по умолчанию используется стандартный метод с переходом в режим обслуживания и перезагрузкой хоста.
Параметр можно изменить, включив принудительное применение Live Patch. В этом режиме исправление будет выполняться только через Live Patch, а для хостов, требующих режима обслуживания, процесс патчинга будет заблокирован. Настройки можно задать как на уровне кластера, так и на уровне vCenter — параметры vCenter применяются ко всем кластерам, если они не переопределены на уровне кластера.
ESX Live Patch теперь поддерживает серверы с включённым TPM. Пользователям не нужно отключать TPM или отказываться от Live Patch при использовании ESX 9.1 и более поздних версий.
Поддержка Live Patch расширена: охватывает больше компонентов vmkernel и обеспечивает более высокую производительность при патчинге ядра. Теперь механизм поддерживает дополнительные пользовательские демоны и сервисы, включая демоны vSAN, базовые демоны хранилища и соответствующие библиотеки.
Расширение интеграции с механизмом Desired State Configuration
Профили конфигурации vSphere (vSphere Configuration Profiles) обеспечивают соответствие изменений конфигурации и операций по устранению отклонений требованиям vSAN. Политики режима обслуживания vSAN и политики доступности объектов соблюдаются при исправлении кластеров vSAN. Расширенная конфигурация vSAN может применяться на уровне всего кластера.
Профили конфигурации vSphere используются для настройки memory tiering на хостах кластера. Устройства NVMe могут быть выделены для memory tiering; дополнительное устройство NVMe опционально может быть задействовано в качестве зеркального устройства для программного зеркалирования.
Профили конфигурации vSphere обеспечивают конфигурацию хостов при установке через Zero Touch Provisioning, а также поддерживают начальную настройку vSphere Distributed Switch в процессе развёртывания хоста.
Оптимизация Desired State Configuration
При добавлении новых хостов в кластеры с включёнными профилями конфигурации vSphere желаемая конфигурация автоматически применяется к входящему хосту. Специфичные для хоста атрибуты (например, IP-адреса) извлекаются из него автоматически и добавляются в соответствующий раздел профиля кластера.
Сертификат TLS для vCenter теперь обновляется автоматически за 5 дней до истечения срока действия. Сертификат ESX обновляется за 30 дней до истечения. Порог для ESX настраивается через расширенные параметры vCenter Server с помощью параметра vpxd.certmgmt.certs.autoRenewThreshold.
В обоих случаях автоматическое обновление выполняется для сертификатов, управляемых VMCA. Сертификаты, выданные внешними центрами сертификации, не обновляются автоматически — ответственность за их управление лежит на администраторе.
Если до истечения срока действия корневого сертификата VMCA остаётся менее 1 года, в процессе обновления vCenter автоматически обновляются корневой сертификат VMCA, а также дочерние сертификаты решений. Сертификаты TLS для vCenter и ESX в рамках этой операции не обновляются.
Масштабируемость, стабильность и производительность
В крупных и сверхкрупных развёртываниях vCenter ожидается увеличение числа операций в минуту до 25%. Это касается множества операций с виртуальными машинами и хостами, а также изменений конфигурации. Масштаб одновременных операций резервного копирования ВМ увеличен до 500–1000 в зависимости от размера vCenter. Операции резервного копирования ВМ теперь защищены от бесконтрольного потребления всех ресурсов vCenter. Передача файлов использует выделенные потоки, что исключает влияние на другие операции vCenter. Расширенные параметры vCenter для операций резервного копирования позволяют настраивать масштабируемость под конкретную среду.
Новый API мониторинга утилизации vCenter позволяет отслеживать активные подключения и сравнивать их с максимально допустимыми лимитами. Появилась возможность отслеживать количество запросов ко всем сервисам vCenter и контролировать, чтобы их интенсивность не превышала допустимых порогов.
Введены два новых оповещения — High Session Count и Increased Request Load — для сигнализации о нагрузке на один или несколько сервисов vCenter. Оповещение High Session Count срабатывает, когда число сессий приближается к лимиту (по умолчанию 3000); в сообщении указываются IP-адреса и имена пяти пользователей, создавших наибольшую нагрузку с более чем 100 сессиями каждый. При изменении состава топ-5 пользователей генерируется новое событие. В список могут попасть любые пользователи, включая сервисные аккаунты. Оповещение Increased Request Load срабатывает при достижении лимита активных запросов к конечной точке сервиса (по умолчанию 1024 для большинства конечных точек) и содержит информацию о затронутых сервисах и конечных точках.
Гибкая настройка виртуальных машин
Для поддержки миграции с VMware Cloud Director (vCD) на VMware Cloud Foundation Automation (VCFA) гостевой API настройки ОС (Guest OS Customization, GOSC) дополнен следующими возможностями, обеспечивающими паритет с функциями vCD:
Установка пароля учётной записи root в Linux
Сброс пароля учётной записи root в Linux
Сброс паролей учётных записей группы администраторов в Windows
Выполнение скриптов настройки в Windows
Теперь администраторы могут явно отключить IPv4 и настроить сеть только для IPv6 в гостевой настройке — как через интерфейс, так и через API. Это устраняет прежнее требование сохранять параллельную конфигурацию IPv4.
Появилась возможность выполнять настройку только сетевых параметров виртуальной машины — для выключенных и для работающих ВМ, что позволяет применять изменения сетевой конфигурации в реальном времени.
Сохранение производительности рабочих нагрузок во время обслуживания хоста
DRS-оптимизированная эвакуация через vMotion (DRS Optimized vMotion Evacuation) гарантирует, что виртуальные машины будут мигрированы с хоста только при наличии достаточной вычислительной ёмкости для их размещения без конкуренции за ресурсы. DRS может предварительно перебалансировать оставшиеся хосты, чтобы создать свободную ёмкость для эвакуируемых ВМ.
При переводе хоста в режим обслуживания для кластеров с включённым DRS доступны два варианта:
Стандартная эвакуация через vMotion: виртуальные машины переносятся на другие хосты в том же кластере при условии совместимости целевых хостов и соответствия требованиям по ресурсам.
Нон-деструктивная эвакуация через vMotion: виртуальные машины переносятся только в том случае, если их текущие вычислительные потребности могут быть удовлетворены целевыми хостами.
Примечание: термин «нон-деструктивная» применительно к новому режиму эвакуации не означает, что стандартная эвакуация как-либо вредит рабочим нагрузкам. Он лишь указывает на то, что при этом режиме эвакуация выполняется только без создания конкуренции за ресурсы на целевых хостах.
Улучшение утилизации ресурсов vMotion и снижение конкуренции
Максимальное количество одновременных задач vMotion по умолчанию равно 8. В предыдущих версиях, если 8 задач vMotion выполнялись одновременно в рамках пакетной операции, новые задачи не начинались до завершения всех предыдущих. Начиная с vSphere 9.1, как только одна задача vMotion завершается и освобождается слот, следующая задача может немедленно стартовать.
Усовершенствованная обработка задач vMotion обеспечивает более равномерное распределение нагрузки по хостам кластера. Число хостов, испытывающих пиковую одновременную нагрузку vMotion, сокращается, а сетевые ресурсы и ресурсы хранилища используются эффективнее.
Более высокая пропускная способность vMotion и сокращение времени миграции
В VCF 9.1 появилась возможность разгрузки операций зашифрованного vMotion на Intel QAT (QuickAssist Technology). Это освобождает ценные ресурсы CPU и возвращает их рабочим нагрузкам.
Для максимально эффективного использования ресурсов в VCF задействована технология Intel QAT (QuickAssist Technology) для ускорения инфраструктурных операций. Перенос «тяжёлой» части задач vMotion на выделенное аппаратное обеспечение позволяет вернуть ценные ядра CPU реальным рабочим нагрузкам. Intel QAT берёт на себя шифрование данных при выполнении операций vMotion.
Оптимизированная масштабируемость и производительность для современных CPU
Планировщик Topology Aware Scheduler перешёл на событийно-ориентированный механизм встроенного обновления, что обеспечивает более согласованное и сбалансированное размещение по NUMA-узлам.
Архитектура NUMA (Non-Uniform Memory Access) используется для повышения масштабируемости и производительности серверов с несколькими процессорными сокетами. Планировщик — компонент ядра ESX, отвечающий за управление размещением виртуальных машин и балансировкой нагрузки по NUMA-узлам с целью минимизации задержек доступа к памяти и оптимального использования ресурсов CPU и памяти рабочими нагрузками.
Topology Aware Scheduler оптимизирован для нового поколения высокоплотных процессоров: улучшена модель оценки эффективности использования CPU и памяти. Существующий планировщик при принятии решений о размещении в основном учитывал конкуренцию за CPU (ready time). Topology Aware Scheduler учитывает не только конкуренцию за CPU, но и конкуренцию за кэш и пропускную способность памяти.
Для систем с асимметричной топологией NUMA, где расстояние между некоторыми парами узлов существенно больше, чем между другими, Topology Aware Scheduler может размещать смежные NUMA-клиенты одной ВМ на подмножестве узлов, расположенных ближе друг к другу.
Готовность к работе с AI-платформами различных производителей
В VCF 9.1 расширена поддержка Enhanced DirectPath I/O.
Речь идёт не просто о «проброске» оборудования, а о его виртуализации — это обеспечивает лучшую утилизацию ресурсов и возможность выполнения операций обслуживания и масштабирования без остановки AI-рабочих нагрузок. Поддержка новых аппаратных устройств в VCF 9.1 открывает доступ ко многим преимуществам виртуализации, включая stun-based операции и быстрое приостановление и возобновление работы. Среди этих преимуществ:
Storage vMotion
Снапшоты (включая снапшоты памяти)
Операции реконфигурации дисков
Горячее добавление и удаление виртуальных устройств
ESX Live Patch
ESX 9.1 расширяет свои возможности, внедряя поддержку виртуализации IOMMU для CPU AMD. Теперь администраторы могут задействовать устройства PCI passthrough на системах на базе AMD, повышая производительность и обеспечивая прямой доступ к оборудованию для виртуальных машин.
AMD vIOMMU (Virtual I/O Memory Management Unit) — аппаратно-ускоренная технология, обеспечивающая безопасный высокопроизводительный прямой доступ к памяти (DMA) для виртуальных машин за счёт прямого доступа гостевых систем к регистрам MMIO.
Flow Processing Offload (FPO) и аппаратное направление трафика (hardware steering) повышают эффективность центра обработки данных, перенося обработку сложных сетевых правил с CPU на выделенное аппаратное обеспечение. Это обеспечивает производительность на уровне линейной скорости и быструю масштабируемость виртуализированных сред, освобождая ресурсы CPU для бизнес-приложений.
Enhanced DirectPath I/O поддерживает прямую связь GPU-to-GPU через RDMA over Converged Ethernet (RoCE). Решение предназначено для организаций, выполняющих массивные AI-рабочие нагрузки или высокоскоростную обработку данных: оно обеспечивает производительность, близкую к нативной (необходимую для AI), без отказа от инструментов управления, которые упрощают эксплуатацию виртуализованных ЦОД.
GPU NVIDIA, используемые для vGPU, теперь можно настроить одновременно для тайм-слайсинга и режима MIG, что обеспечивает ещё более эффективное совместное использование ресурсов и повышение плотности.
Классическая инфраструктура изначально не проектировалась для периферийных масштабов. Управление сотнями и тысячами распределённых площадок с использованием разрозненных стеков, изолированных инструментов и ручных процедур порождает операционные риски, неоднородность защиты и высокую стоимость обслуживания каждой точки в отдельности.
Для многих организаций это означает необходимость заходить на сотни площадок для установки обновлений, разбираться с несовпадающими конфигурациями и зависеть от локальных ИТ-специалистов, что замедляет развёртывание и увеличивает риски. По мере того как AI-нагрузки и приложения реального времени смещаются ближе к местам формирования данных, эти проблемы становятся ещё острее.
VMware Cloud Foundation Edge (VCF Edge) меняет эту модель. Продукт представляет собой унифицированную распределённую частную облачную платформу, на которой одновременно работают виртуальные машины, приложения на базе Kubernetes и AI-нагрузки с единой моделью эксплуатации во всех локациях, что устраняет необходимость в отдельной периферийной инфраструктуре.
VCF Edge 9.1 развивает эту концепцию за счёт автономных периферийных операций — автоматизации развёртывания, управления жизненным циклом в масштабе и политик безопасности, в том числе в окружениях без подключения и в полностью изолированных (air-gapped) средах.
Автономные периферийные операции
На больших масштабах задача состоит не в развёртывании отдельной площадки, а в согласованной эксплуатации сотен или тысяч таких площадок.
VCF Edge заменяет фрагментированную периферийную инфраструктуру единой платформой для виртуальных машин, контейнеров и AI, стандартизируя операции в распределённых средах и поддерживая разные топологии — от одноузловых конфигураций до мультикластерных схем. Каждая площадка работает локально, обеспечивая отказоустойчивость, а централизованное управление применяет политики, регламент жизненного цикла и правила governance ко всему парку.
Итогом становятся снижение операционных издержек, ускорение развёртывания и возможность масштабировать периферийную инфраструктуру без роста сложности и рисков.
Рисунок: гибкие топологии развёртывания VCF Edge для распределённых сред.
Ускорение развёртывания с помощью Zero-Touch Provisioning
Классические сценарии развёртывания периферии подразумевают ручную настройку, присутствие ИТ-специалистов на площадке и недели координации, из-за чего крупные внедрения идут медленно и дорого. VCF Edge снимает эти барьеры с помощью технологии Zero-Touch Provisioning (ZTP). После включения сервер безопасно загружается, подключается к централизованному управлению и получает полное целевое состояние — образ ОС, конфигурацию кластера и сетевые параметры, — что автоматизирует развёртывание от начала до конца. Скрипт активации Day 0 Activation Script гарантирует готовность каждой площадки к продуктивной работе вместе с платформенными сервисами и интеграцией GitOps.
Результат — ускоренное развёртывание, единообразные конфигурации и возможность вводить периферийную инфраструктуру в строй за часы, без ручной настройки и присутствия ИТ-сотрудников на месте, что заметно сокращает операционные расходы.
Оптимизация производительности и стоимости через Advanced NVMe Memory Tiering
На периферии масштабирование инфраструктуры часто означает добавление новых серверов, что ведёт к росту стоимости, занимаемого пространства и энергопотребления. В VCF Edge добавлены улучшения в технологии NVMe Memory Tiering, которая расширяет системную память за счёт высокопроизводительных NVMe-устройств без дополнительной установки модулей DRAM. В результате повышается плотность размещения нагрузок, лучше используется имеющееся оборудование и появляется возможность отложить или вовсе отказаться от дорогостоящих обновлений инфраструктуры.
Рисунок: NVMe Memory Tiering для периферийной инфраструктуры (расширение памяти без добавления DRAM).
Единая платформа, готовая к AI-нагрузкам периферии
Управление инфраструктурой, Kubernetes и AI-сервисами в распределённых средах становится крайне сложной задачей. VCF Edge упрощает её за счёт единой платформы для виртуальных машин, Kubernetes и AI, что избавляет от необходимости развёртывать и обслуживать раздельные стеки.
Готовый к производственной среде Kubernetes на периферии
VCF Edge предоставляет Kubernetes-платформу промышленного уровня с расширенной поддержкой жизненного цикла, гибким выбором операционной системы и продвинутыми сетевыми возможностями. Результат — упрощённая эксплуатация, ускоренное развёртывание приложений и согласованные окружения на каждой из площадок.
Рисунок: расширенная поддержка, гибкость ОС и продвинутые сетевые функции для периферийных развёртываний.
Простота без сложности Kubernetes
Не каждой нагрузке требуется полноценный Kubernetes. VCF Edge позволяет запускать контейнеры рядом с виртуальными машинами через механизм vSphere Pods. Это даёт более быстрое развёртывание, меньшие операционные затраты и упрощённый переход к контейнерам без необходимости в экспертизе по Kubernetes.
Рисунок: запуск контейнеров через vSphere Pods (CaaS без сложности Kubernetes).
AI на периферии без инфраструктурных компромиссов
Доступность GPU, их стоимость и ограничения по энергоснабжению нередко лимитируют список мест, где можно развернуть AI. VCF Edge позволяет запускать инференс AI-моделей вместе с уже работающими нагрузками с использованием GPU либо вычислений на CPU (через llama.cpp). Организации получают возможность размещать AI-сервисы ближе к источникам данных, не разворачивая отдельные инфраструктурные стеки. Итог — снижение стоимости инфраструктуры под AI, более быстрое внедрение сценариев применения AI и возможность охватить большее число периферийных площадок без обязательной установки GPU на каждой из них.
Ускорение AI-нагрузок с поддержкой GPU и других ускорителей
Платформа поддерживает высокопроизводительные ускорители для запуска требовательных AI-инференс-задач на периферии, обеспечивая при этом максимальное использование GPU между площадками.
Рисунок: поддержка GPU и ускорителей для AI-нагрузок на периферии.
Распространение AI через инференс на CPU
VCF Edge даёт возможность выполнять инференс AI-моделей на стандартной CPU-инфраструктуре с использованием llama.cpp, что снижает зависимость от GPU и открывает применение AI в ограниченных или удалённых периферийных средах, где развёртывание GPU нецелесообразно.
Рисунок: CPU-инференс для периферийных сред (llama.cpp).
Непрерывная поставка через распределённые периферийные площадки
Поддержание согласованности на периферии — это не разовая задача развёртывания, а постоянный операционный вызов.
VCF Edge обеспечивает непрерывность работы благодаря централизованной дистрибуции образов по pull-модели, использующей Content Library для синхронизации образов в рамках всего парка. Эта архитектура целенаправленно спроектирована под надёжную эксплуатацию в средах с низкой связностью, без подключения или полностью изолированных, поскольку позволяет каждой площадке хранить и управлять своим состоянием локально. Благодаря отказу от постоянного канала к управлению уменьшается потребление трафика, и каждая периферийная площадка остаётся отказоустойчивой автономной единицей, способной поддерживать согласованные развёртывания вне зависимости от внешней связи.
Рисунок: централизованная дистрибуция образов в распределённых периферийных средах (pull-модель).
Автоматизация на основе GitOps для непрерывной поставки
После развёртывания инфраструктуры поддержание согласованности между распределёнными периферийными площадками требует непрерывной поставки и автоматизированного управления конфигурацией.
VCF Edge поддерживает автоматизацию по подходу GitOps через интеграцию с инструментами вроде Argo CD, что позволяет описывать конфигурации инфраструктуры и приложений в Git и автоматически выкатывать обновления на все периферийные площадки. Вместо точечного управления изменениями на каждой площадке конфигурации задаются один раз и применяются ко всему парку.
Итог — ускоренная поставка приложений, автоматические обновления, постоянное выявление и устранение расхождений (drift), а также единообразные окружения во всех периферийных локациях.
Рисунок: управление желаемым состоянием по GitOps в распределённых периферийных средах (Argo CD).
Наблюдаемость парка в реальном времени
Без централизованной видимости диагностика периферийных сред идёт медленно и реактивно. VCF Edge обеспечивает наблюдаемость всего парка в реальном времени, открывая возможность для проактивного мониторинга и более быстрого устранения проблем. Это сокращает простои и повышает надёжность эксплуатации.
Рисунок: наблюдаемость и мониторинг распределённых периферийных сред в реальном времени.
Защищённая и устойчивая периферия
Обеспечение безопасности на периферии сопряжено с трудностями: локальные ИТ-ресурсы ограничены, а риски распределены.
Live-патчинг без прерывания работы
VCF Edge поддерживает ESX Live Patching для хостов с TPM, что позволяет устанавливать до 80% патчей безопасности без перезагрузки. Обновления выполняются удалённо, без окон обслуживания, благодаря чему нагрузки остаются доступными непрерывно, а защита поддерживается в нужном масштабе.
Рисунок: ESX Live Patching без прерывания работы для периферийной инфраструктуры (хосты с TPM).
Оптимизировано под масштаб периферии. Создано для реальной эксплуатации.
VCF Edge заменяет фрагментированные периферийные архитектуры единой платформой, рассчитанной на распределённый масштаб. Лицензирование, развёртывание и эксплуатация выстраиваются с учётом особенностей периферийных сред: продукт оптимизирован под ограниченные по ресурсам конфигурации и одновременно избавляет от ручного управления на уровне каждой из площадок.
За счёт стандартизации инфраструктуры, приложений и AI на единой операционной модели VCF Edge обеспечивает эффективные и повторяемые операции в каждой локации. Получается автономная, масштабируемая и подготовленная к ИИ платформа, которая позволяет предприятиям управлять тысячами периферийных площадок с простотой, характерной для одной платформы.
Современные кибератаки перестали быть точечными ударами по приложениям — теперь они нацелены на саму инфраструктуру. Целенаправленные постоянные угрозы, программы-вымогатели и атаки supply chain бьют именно по тем фундаментальным слоям, на которых работают рабочие нагрузки. Защита фундамента — это уже не опция, а обязательное условие для эксплуатации безопасной и устойчивой инфраструктуры частного облака в эпоху, когда кибератаки, ранее опиравшиеся на ручной хакинг, превратились в управляемые AI-кампании, способные к самоэволюции.
По мере масштабирования корпоративных развёртываний AI архитектура безопасности становится стратегическим приоритетом. Чтобы обеспечить доверенное взаимодействие между людьми, данными и системами AI, требуется продуманный подход к защите инфраструктуры; единая платформа частного облака даёт здесь существенное преимущество с точки зрения архитектурного контроля, суверенитета данных и соответствия регуляторным требованиям.
VMware Cloud Foundation (VCF) предоставляет валидированный и проверенный на целостность фундамент инфраструктуры, на который можно опереться при защите чувствительных данных и обеспечении непрерывности бизнеса в условиях изощрённых угроз. Вместо неявного доверия VCF реализует непрерывную верификацию системы, обеспечивая глубокую видимость платформы и мониторинг целостности в реальном времени. Усиленная программно-определяемая инфраструктура VCF со встроенными средствами контроля безопасности даёт предприятиям необходимый запас устойчивости, чтобы опережать угрозы, которые благодаря ИИ движутся быстрее и постоянно адаптируются.
Безопасность платформы в VCF 9.1
Каждый новый выпуск VCF приносит улучшения и расширения возможностей безопасности платформы. В VCF 9.1 представлены свежие функции платформенной безопасности, необходимые для поддержки промышленных развёртываний AI. Новый релиз защищает AI-нагрузки, проприетарные модели и чувствительные данные за счёт интеграции механизмов безопасности на всём стеке инфраструктуры — от гипервизора до уровня приложений.
Ключевые платформенные функции безопасности VCF 9.1 распределены по пяти категориям:
Обнаружение и предотвращение угроз усиливает защиту гипервизора и ускоряет установку патчей без простоев.
Устойчивость рабочих нагрузок обеспечивает непрерывную работу и восстановимость приложений за счёт аппаратной изоляции и кроссплатформенной репликации.
Шифрование данных защищает данные в процессе обработки, при передаче и в покое на всём стеке.
Аудит и мониторинг предоставляют единое управление журналами и централизованный аудиторский след для быстрого форензик-анализа.
Идентификация и доступ обеспечивают принцип Zero Trust за счёт SSO уровня фабрики, политик паролей и управления сертификатами.
В совокупности эти пять направлений формируют эшелонированную оборону, необходимую частному облаку и промышленным AI-нагрузкам в противостоянии всё более способным, адаптивным и автоматизированным противникам.
Обнаружение и предотвращение угроз
VCF 9.1 продолжает добавлять новые возможности в направлении проактивных оповещений и интеллектуального анализа, а также верификации целостности и конфигурации инфраструктуры — всё это улучшает обнаружение и предотвращение угроз. В этом релизе значительно расширены возможности патчинга VCF.
Live Patching для хостов с включённым TPM
В VCF 9.1 функция live patching в vSphere продолжает развиваться: обновления безопасности можно применять к кластерам без миграции рабочих нагрузок с целевых хостов и без перевода хостов в полный режим обслуживания. Релиз также закрывает пробел, который ранее не позволял хостам с включённым TPM на ESX участвовать в рабочем процессе live patching. Установка патчей без простоев особенно выгодна для бизнес-критичных приложений — таких как сервисы AI-инференса и агентные AI-приложения, для которых требуется непрерывная доступность ради соблюдения SLA.
Quick Patching для vCenter
Функция Quick Patch позволяет VMware vCenter получать патчи безопасности, оставаясь в работающем состоянии. Применение обновления vCenter теперь занимает приблизительно 5 минут без прерывания рабочих нагрузок — против примерно 20 минут простоя и до 40 минут общего времени операции в случае обычного патча. Снижение операционной стоимости патчинга vCenter устраняет одну из частых точек трения, из-за которой обновления одного из самых критичных управленческих компонентов инфраструктуры регулярно откладываются.
С возможностями Live Patching и Quick Patching VCF 9.1 расширяет способность применять исправления безопасности в большем масштабе и с большей скоростью — без обновлений всего стека и без прерывания работы нагрузок.
Интеграция EDR для ESX
Хосты ESX теперь могут запускать EDR-агенты от партнёров по безопасности непосредственно на гипервизоре. EDR-агент работает в изолированном контейнере на хосте, отделённом от ядра системы, чтобы не вмешиваться в нормальную работу. Он отслеживает события — например, запуск и завершение процессов, установление сетевых соединений — и передаёт их на платформу управления вендора средств защиты. Поддержка EDR доступна в ESX 9.1 и требует, чтобы вендоры EDR предоставили совместимых агентов. Организациям, заинтересованным в использовании этих возможностей, следует уточнить у своего EDR-вендора, готовы ли его агенты.
Мониторинг целостности файлов
В VCF 9.1 появилась функция мониторинга целостности файлов (File Integrity Monitoring, FIM), соответствующая требованиям NIST и PCI DSS. Она выявляет изменения, внесённые вредоносным ПО или злоумышленниками, в статические файлы и бинарники, установленные vCenter. FIM включён по умолчанию и запускается каждые четыре часа, фиксируя злонамеренные, непреднамеренные изменения или повреждения установленных файлов. Администраторы VCF могут получить FIM-отчёт через API или передавать FIM-логи в VCF Operations for Logs через службу syslog.
User-Level Monitor
User-Level Monitor (ULM) поставляется в VCF 9.1 как монитор по умолчанию для всех виртуальных машин. ULM полностью переписывает виртуальный монитор машин (Virtual Machine Monitor, VMM) ESX — компонент, который управлял исполнением виртуальных машин на физическом железе с 1998 года. Ранее VMM работал с максимальными привилегиями ОС, а значит, любая уязвимость могла скомпрометировать весь хост и все ВМ на нём. ULM переносит монитор в пользовательский режим с пониженными привилегиями, ограничивая потенциальный ущерб от эксплойтов. Переработанный интерфейс ядра трактует все входные данные как недоверенные; адресное пространство исключает секреты хоста и память других ВМ; упрощённая архитектура значительно сокращает поверхность атаки и сложность гипервизора.
Устойчивость рабочих нагрузок
Усовершенствование vSphere Pod
Один из способов, которыми VCF обеспечивает изоляцию контейнерных нагрузок, — это vSphere Pods: контейнеры запускаются напрямую внутри управляемых ESX виртуальных машин, что сочетает скорость и плотность контейнеров с аппаратной изоляцией гипервизора. PodVM (vSphere Pods) используются для запуска одного или нескольких контейнерных инстансов без необходимости разворачивать кластер Kubernetes. На vSphere Pods построены сервисы Supervisor, и теперь они доступны через новый UI Container Service.
vSphere Pods используют Container Runtime Executive (CRX), обеспечивающий лёгкую и высокопроизводительную среду, которая загружается за секунды. Это делает их идеальным выбором для нагрузок с повышенными требованиями к безопасности, где необходима строгая изоляция ядер между приложениями, либо для ресурсоёмких микросервисов, которым нужны продвинутое планирование и предиктивные возможности DRS в ESX.
По мере увеличения числа сервисов Supervisor накладные расходы памяти PodVM могут стать узким местом. Благодаря оптимизации памяти PodVM внутренние тесты показывают, что накладные расходы памяти снижаются примерно на 75% по сравнению со стандартной ВМ — за счёт совместного использования образа загрузки между инстансами PodVM на одном хосте. Кроме того, внутренние тесты подтверждают, что PodVM загружается до 70% быстрее, чем типичная ВМ.
Новый сервис Container Service позволяет разворачивать отдельные контейнеры без необходимости управлять полноценным кластером Kubernetes. Используя изолированные runtime-среды внутри vSphere Pods, он даёт возможность запускать отдельные контейнеры, не разворачивая и не обслуживая Kubernetes-кластер целиком.
В этом релизе также добавлен потоковый вывод STDOUT/STDERR в реальном времени со всех контейнеров внутри PodVM на внешние syslog-серверы. Это применимо только к vSphere Pods и не распространяется на гостевые кластерные нагрузки VMware vSphere Kubernetes Service (VKS).
Multi-Source Replication для кластеров vSAN
В VCF 9.0 в vSAN была представлена репликация vSAN-to-vSAN, обеспечивающая защиту ВМ из одного vSAN-кластера в другой. В нынешнем релизе эта возможность расширена дальше. Теперь можно реплицировать или защищать ВМ из любого источника — например, из хранилища VMFS или NFS — на vSAN-цель. Это даёт большую гибкость в защите существующих сред VCF, где может присутствовать смешанный набор платформ хранения. Теперь возможно защищать все ВМ среды через единую цель репликации и единый рабочий процесс — независимо от того, на какой платформе хранения они в данный момент находятся, — с политиками снапшотов и репликацией, действующими на всю инфраструктуру.
Возможности репликации доступны через VMware Site Recovery Manager (SRM) или решение VMware Advanced Cyber Compliance.
Шифрование данных
VCF 9.1 добавляет и расширяет возможности шифрования по всему стеку, включая улучшения для данных в покое, данных в движении и нагрузок confidential computing.
Confidential Computing — теперь в общедоступной версии
Confidential Computing запускает чувствительные нагрузки внутри аппаратно зашифрованных областей памяти, которые остаются недоступными даже для гипервизора, защищая данные в процессе использования на разделяемой инфраструктуре частного облака. VCF поддерживал более ранние поколения этой технологии уже несколько лет; VCF 9.1 завершает работу над поддержкой текущих реализаций — Intel TDX и AMD SEV-SNP, — переводя их в категорию общедоступных (general availability). Одно из практических улучшений — повторное включение Quick Boot на хостах, где активен Confidential Computing: раньше хосты, использующие Intel TDX или AMD SEV-SNP, не могли воспользоваться Quick Boot — функцией, позволяющей ESX перезапускаться без полного цикла аппаратной инициализации и тем самым сокращающей окна обслуживания.
Дополнительно VCF Operations теперь автоматически профилирует ESX-хосты и определяет, какие из них способны выполнять конфиденциальные ВМ и контейнеры. Это снимает с архитекторов гадания при размещении чувствительных нагрузок на защищённом оборудовании. Операторы также могут видеть, активирован ли Confidential Computing на подходящем хосте.
Confidential Computing в VCF доступен через решение VMware Advanced Cyber Compliance.
Ускоренный шифрованный vMotion с технологией Intel QuickAssist (QAT)
vMotion сам по себе может быть ресурсоёмким процессом, и эта нагрузка возрастает, когда включено шифрование. По мере того как рабочие нагрузки становятся крупнее, а частота операций vMotion растёт, потребление ресурсов на эту задачу заметно увеличивается. Перенос функции шифрования на аппаратное ускорение требует меньше критически важных ресурсов, которые освобождаются для других приложений, что в итоге сокращает затраты.
QAT включён по умолчанию на поддерживаемом оборудовании, обеспечивая более плавный пользовательский опыт и упрощённое управление жизненным циклом.
Шифрование данных в покое для vSAN Global Deduplication
В связке с переводом vSAN Global Deduplication в общедоступную версию в VCF 9.1 кластеры vSAN, использующие глобальную дедупликацию, теперь поддерживают шифрование данных в покое (Data-at-Rest Encryption). Включить Data-at-Rest Encryption можно на уровне отдельного кластера, одновременно используя на том же кластере vSAN Global Deduplication — без каких-либо компромиссов между этими двумя функциями. Дедупликация работает как фоновая постобработка и совместима с шифрованием данных в покое; включение шифрования не влияет на коэффициенты дедупликации.
Аудит и мониторинг
Централизованное управление журналами
VCF 9.1 улучшает управление логами, полностью интегрируя возможности отдельного UI VCF Operations for Logs внутрь VCF Operations и предоставляя администраторам и операторам VCF единый интерфейс для всех задач управления журналами. В интеграцию входят правила обработки логов, администрирование логов, публичные API для логов, глобальные настройки управления кластером логов, а также улучшения страницы анализа логов.
Отдельный UI больше не требуется, поскольку все возможности встроены непосредственно в VCF Operations.
Аудиторский след (Audit Trail)
Форматы лог-записей и аудиторских записей теперь стандартизированы между компонентами VCF.
Новый Audit Trail в VCF Operations идёт дальше и предоставляет централизованное представление пользовательской активности с временными срезами по всем компонентам (включая VKS), упрощая разбор для форензики, выявление ключевых событий и сокращая время аудита. Когда меняются правила межсетевого экрана или фиксируются неудачные попытки входа, операторы могут проследить всю цепочку событий через весь стек.
Идентификация и доступ
VCF 9.1 расширяет возможности единого SSO, управления паролями и сертификатами, представленные в предыдущем релизе, — добавляя более широкое покрытие компонентов, средства управления на уровне фабрики и новые интеграции с хранилищами секретов и центрами сертификации.
Усовершенствование Identity Broker
VCF Identity Broker (VIDB) получил расширенные параметры конфигурации и улучшения развёртывания. VIDB обеспечивает SSO-связь между компонентами VCF и внешним поставщиком идентификации (Identity Provider, IDP) или службой каталогов. Identity Broker теперь устанавливается в момент развёртывания или обновления VCF и больше не требует отдельной загрузки в качестве предусловия для настройки единого входа.
Identity Broker можно настраивать в embedded-режиме или режиме appliance — через VCF Operations или API. Развёртывание Identity Broker в виде кластера из трёх узлов обеспечивает более высокую производительность, масштабируемость и высокую доступность; такой вариант рекомендован для промышленной эксплуатации. Узлы Identity Broker теперь могут разворачиваться за пределами management-кластера.
VCF 9.x также предоставляет скриптовый рабочий процесс для организаций, обновившихся с VCF 5.x, — позволяющий без прерывания работы мигрировать пользователей и группы из VMware Identity Manager (VIDM) в Identity Broker. В процессе обновления Identity Broker разворачивается автоматически. Скрипт запускается уже после завершения обновления. Далее Identity Broker можно интегрировать с выбранным поставщиком идентификации; существующие пользователи и группы при этом не затрагиваются.
Усовершенствование управления паролями
VCF Operations 9.1 расширяет управление паролями, добавляя политики уровня фабрики, интеграцию с хранилищами секретов и покрытие дополнительных компонентов.
Теперь возможно задавать единые политики паролей между компонентами VCF и проводить проверки соответствия паролей с последующей коррекцией. Созданные политики применяются на уровне фабрики VCF или для отдельных компонентов VCF. Кроме того, администраторы могут управлять паролями для VCF Operations workload mobility (ранее известного как HCX) и балансировщиков Avi, развёрнутых или обновлённых до VCF 9.1.
Пароли break-glass-учётных записей больше не сохраняются — что устраняет одну из распространённых причин для процедур принудительной смены паролей. Дополнительно новые API для интеграции с корпоративными хранилищами паролей поддерживают сторонние инструменты — в частности, CyberArk. Корпоративные парольные хранилища, управляемые через API, потребуют плагина для VCF.
Усовершенствование управления сертификатами
В VCF 9.1 добавлены конфигурация центров сертификации на уровне фабрики, расширенная поддержка Microsoft CA и OpenSSL, а также массовые операции с сертификатами. Центр сертификации (Certificate Authority, CA) теперь настраивается на уровне фабрики VCF, а не отдельного инстанса, что позволяет управлять сертификатами на уровне всей фабрики.
Поддержка Microsoft CA и OpenSSL расширена и теперь охватывает как компоненты VCF instance, так и компоненты управления VCF. В предыдущем релизе Microsoft CA и OpenSSL поддерживались только для компонентов VCF instance (vCenter, NSX и ESX), тогда как компоненты управления можно было настраивать исключительно с использованием Microsoft CA.
В UI VCF Operations операторы теперь могут выполнять массовые операции с сертификатами. Запросы на подпись сертификатов, их обновление и импорт — всё это выполняется пакетно, сокращая время и дополнительно упрощая операции по управлению сертификатами. API VCF Operations можно использовать для интеграции со сторонними решениями и автоматизации управления сертификатами для всех компонентов VCF.
Дополнительные материалы
VCF 9.1 содержит последние достижения технологии виртуализации VMware. Релиз объединяет Zero Trust-безопасность и устойчивость на каждом уровне: vSphere, NSX, vSAN, VMware vSphere Kubernetes Service, VCF Private AI Services, VCF Operations и VCF Automation, помогая организациям защитить инфраструктуру частного облака от продвинутых, ускоренных AI-угроз.
Также материалы по усилению безопасности, соответствию требованиям и часто задаваемые вопросы по конкретным функциям доступны в репозитории GitHub: https://brcm.tech/vcf-security.
Во времена, когда на счету каждый доллар или сотня рублей, а каждая минута простоя стоит дорого, команды, отвечающие за инфраструктуру, оказались в "идеальном шторме" вызовов: дефицит оборудования, который прогнозируется вплоть до 2027 года, изолированные среды, возникающие из-за сосуществования старых и современных архитектур, постоянно меняющиеся требования к компетенциям и нарастающая сложность управления установками, обновлениями и обслуживанием в разнородных системах. Параллельно с этим эволюция угроз и рост числа и изощрённости кибератак требуют детальной и точной видимости поведения гостевой ОС и активности рабочих нагрузок. Традиционные подходы перестают быть жизнеспособными: организации испытывают сильное давление, заставляющее минимизировать совокупную стоимость владения (TCO) и одновременно добиваться измеримой отдачи от каждой инвестиции. Нужна не просто большая инфраструктура — нужна более умная инфраструктура, которая по максимуму использует уже имеющиеся ресурсы за счёт инновационных подходов. Именно здесь vSphere в составе VMware Cloud Foundation (VCF) 9.1 меняет правила игры, привнося прорывные нововведения, которые фундаментально переопределяют экономику инфраструктуры, её производительность и безопасность.
Экономика модернизации без замены оборудования
В vSphere внедрён набор возможностей, нацеленных на то, чтобы выжать максимум из уже сделанных инфраструктурных инвестиций и снизить TCO. vSphere в VCF 9.1 также включает функции, существенно сокращающие накладные расходы и повышающие операционную эффективность. Речь идёт не о точечных улучшениях, а о фундаментальных сдвигах в том, как инфраструктура создаёт ценность.
Память по-новому: интеллектуальный NVMe-тиринг
Стоимость памяти долгое время оставалась ограничителем при масштабировании инфраструктуры, а сегодня этот фактор стал ещё острее из-за стремительно растущих цен на память на фоне всплеска интереса к AI. vSphere полностью меняет это уравнение. Усовершенствованная функция тиринга памяти на NVMe позволяет снизить TCO сервера до 40% и одновременно убирает операционные неудобства.
Что делает версию 9.1 по-настоящему трансформирующей — это устранение барьеров для внедрения. Например, отменяется требование перезагрузки для включения тиринга памяти. Уведомления в интерфейсе позволят без усилий определять подходящие кластеры и рабочие нагрузки, а проактивный мониторинг состояния устройств обеспечит их замену ещё до того, как они выйдут из строя.
Появление зеркалирования RAID 1 для тиринга памяти обеспечивает критически важную отказоустойчивость, не позволяя сбоям отдельных устройств перерастать в масштабные простои виртуальных машин. Для нагрузок, активно работающих с данными, — аналитики больших данных, e-commerce-платформ и сервисов видеостриминга — это означает резкое расширение доступной памяти без пропорционального наращивания «железа». При улучшенном соотношении ядер и памяти организации добиваются более плотной консолидации ВМ и более высокой загрузки CPU, что усиливает экономический эффект от снижения TCO.
Время — деньги: Quick Patching для vCenter
Требования к безопасности и соответствию нормативам диктуют необходимость регулярного патчинга, однако традиционные окна обслуживания дорого обходятся: они нарушают работу и истощают ресурсы ИТ-команд. Функция Quick Patching для vCenter сокращает общее время операции примерно на 80% — окно патчинга уменьшается приблизительно с 30 минут до менее чем 5 минут.
Это резкое сокращение — не только про экономию времени. Quick Patching интеллектуально классифицирует сервисы vCenter по степени их влияния и оптимизирует процедуру обновления под каждый тип. В итоге улучшается соблюдение требований по критическим патчам, снижается риск ручных ошибок и заметно уменьшается административная нагрузка. В то время как у конкурентов на ручной патчинг уходят значительные человеко-часы, автоматизированный подход vSphere превращается в конкурентное преимущество, которое со временем только усиливается.
Эластичное развертывание в любых масштабах
Развёртывание инфраструктуры исторически было медленным ручным процессом, что затрудняло быстрое масштабирование. Технология vSphere Elastic Provisioning (Zero-Touch Provisioning) превращает это узкое место в отлаженную операцию. Используя UEFI HTTP для безопасной загрузки и vSphere Configuration Profiles для настройки среды в желаемом состоянии, организации могут быстро разворачивать инфраструктуру в масштабе при минимальном ручном вмешательстве.
Оптимизация производительности для требовательных нагрузок
По мере того как рабочие нагрузки становятся всё более ресурсоёмкими, а архитектуры процессоров эволюционируют, традиционные подходы к оптимизации производительности создают узкие места, ограничивающие масштабируемость и эффективность. vSphere в VCF 9.1 решает эти задачи в лоб с помощью интеллектуальных улучшений производительности, которые устраняют накладные расходы, не жертвуя при этом ни безопасностью, ни непрерывностью операций.
Производительность без накладных расходов: ускорение шифрованного vMotion
Для ресурсоёмких нагрузок с большими буферами кадров традиционный зашифрованный vMotion способен создавать существенные узкие места по производительности во время живой миграции. vSphere в VCF 9.1 задействует технологию Intel Quick Assist Technology (QAT), чтобы выгружать на сторону железа задачи шифрования, дешифрования и сжатия с CPU хоста в процессе vMotion.
Какой эффект? Значительно ускоряется этап переключения vMotion — и при этом не страдает безопасность. Организации сохраняют непрерывность работы даже для самых требовательных нагрузок, безопасно передавая данные без потерь в производительности. В средах, где каждая секунда миграции имеет значение — будь то окна обслуживания, балансировка нагрузки или восстановление после сбоев, — такая оптимизация даёт ощутимую бизнес-ценность и операционную гибкость.
Максимум производительности: планирование с учётом топологии
Процессоры с большим числом ядер раздвигают границы прежних NUMA-архитектур, создавая такие проблемы, как переполнение узлов, лишние миграции и неоптимальная производительность на системах AMD и системах с включённым SNC. Планирование с учётом топологии в vSphere меняет то, как платформа работает с этими процессорами высокой плотности нового поколения.
Обновлённый NUMA-планировщик теперь работает скорее по принципу DRS: используется та же модель справедливости с пулами ресурсов и параметрами min/max shares, а для эффективности применяется многоресурсная модель «качества», учитывающая стоимость миграции страниц памяти. Такой интеллектуальный подход принимает во внимание архитектурные особенности процессоров нового поколения и оптимизирует алгоритмы планирования, обеспечивая лучшую производительность, более эффективное использование ресурсов и более предсказуемое поведение нагрузок на самых разных аппаратных конфигурациях.
Безопасность: встроенная защита на всех уровнях стека
vSphere представляет собой по-настоящему защищённую платформу, расширяющую защиту до данных в обработке (data-in-use), детектирующую угрозы в реальном времени и обеспечивающую соблюдение нормативных требований и отраслевых рекомендаций по конфигурации безопасности «из коробки».
Безопасность без простоев: расширенный Live Patching
По мере того как организации переходят на серверы с TPM (а такие машины составляют почти 90% нового железа), vSphere в VCF 9.1 распространяет поддержку Live Patching на хосты с TPM и включает эту функцию по умолчанию. Возможность позволяет применять важные патчи к инфраструктуре платформы ESX без перевода хостов в офлайн и без эвакуации виртуальных машин, доставляя критические обновления безопасности быстро в рамках фиксированных SLA и поддерживая надёжные обновления без ошибок.
Confidential Computing: защита данных в обработке
Защита данных не ограничивается хранением и передачей: следующий рубеж — это защита данных непосредственно в процессе их обработки. vSphere в VCF 9.1 переводит в общую доступность Confidential Computing с поддержкой Intel TDX и AMD SEV-SNP. Эти аппаратные средства шифрования памяти и контроля её целостности изолируют рабочие нагрузки от инфраструктурного стека, формируя защищённые Trust Domains (у Intel) и Confidential VMs (у AMD), благодаря чему безопасность становится неотъемлемым свойством платформы.
Глубокая видимость: интеграция с EDR
Традиционные средства Endpoint Detection and Response (EDR) хорошо справляются с мониторингом гостевых операционных систем, однако часто не имеют видимости в сам хост ESX. vSphere в VCF 9.1 позволяет агентам EDR от сторонних производителей интегрироваться непосредственно в гипервизор ESX и анализировать события на уровне процессов, файлов и сети на предмет подозрительной активности. Такая глубокая интеграция средств обнаружения угроз прямо в гипервизор крайне важна для выявления горизонтального перемещения злоумышленников, бесфайлового вредоносного ПО и эксплойтов нулевого дня — и всё это без появления узких мест по производительности.
Инфраструктура, которая окупает себя
vSphere в VCF 9.1 — это фундаментальный сдвиг в экономике инфраструктуры. Максимально используя уже установленное оборудование через тиринг памяти на NVMe, сокращая операционные накладные расходы за счёт быстрого патчинга и эластичного провижининга, устраняя узкие места по производительности через интеллектуальную выгрузку задач и обеспечивая непрерывность работы благодаря Live Patching, организации превращают инфраструктуру из статьи затрат в стратегическое преимущество.
В условиях, когда дефицит оборудования сохраняется и каждая инвестиция должна приносить измеримую отдачу, vSphere в VCF 9.1 предлагает понятный путь вперёд: использовать то, что уже есть, оптимизировать то, как выстроены операции, и масштабироваться без пропорционального роста затрат.
Для многих организаций внедрение Kubernetes начиналось как технологическая инициатива, однако превращение его в надёжную корпоративную платформу нередко оказывалось значительно сложнее, чем предполагалось. То, что задумывалось как инновация, быстро становилось источником сложностей:
Растущие операционные издержки
Фрагментированные среды
Пробелы в безопасности, нормативном соответствии и компетенциях
Замедление вывода продуктов на рынок
В то же время ставки повышаются. Инициативы в области искусственного интеллекта, приложения, работающие с большими объёмами данных, и цифровой клиентский опыт сегодня зависят от инфраструктуры, которая должна быть не только масштабируемой, но и предсказуемой, безопасной и эффективной. Согласно последнему отчёту State of Platform Engineering Report, 64% специалистов по платформенной инженерии называют Kubernetes одним из ключевых направлений для достижения автоматизированного, надёжного и стандартизованного развёртывания приложений.
С появлением VMware Cloud Foundation (VCF) и развитием её компонента VMware vSphere Kubernetes Service (VKS) фокус сместился с управления инфраструктурой как такового на достижение конкретных бизнес-результатов.
VCF закрывает ключевые приоритеты, предоставляя единую платформу для контейнеров и виртуальных машин со встроенной сертифицированной CNCF средой выполнения Kubernetes, реализованной через компонент VKS. VMware VKS даёт инженерам платформ возможность развёртывать и обслуживать кластеры Kubernetes, опираясь на богатый набор облачных сервисов, входящих в VCF, а также на сторонние CNCF-совместимые сервисы (рис. 1). VKS — одна из первых Kubernetes-платформ, получивших сертификацию AI conformant, которая к тому же упрощает управление множеством кластеров, позволяя предприятиям уверенно запускать ИИ и другие современные рабочие нагрузки.
Рис. 1. VKS предлагает комплексный набор облачных сервисов вместе со всеми сторонними CNCF-совместимыми сервисами.
Императив CIO: меньше сложности, больше скорости
Сегодня перед ИТ-директорами стоит двойная задача — обеспечить безопасность, управляемость, контроль и нормативное соответствие, одновременно ускоряя инновации, и всё это при неизменном или сокращающемся бюджете.
Исторически эти цели вступали в противоречие. Однако благодаря снижению совокупной стоимости владения (TCO), более быстрому выходу на ценность, повышенной безопасности и упрощённой операционной модели VKS быстро становится предпочтительной средой выполнения Kubernetes для современных приложений. Чтобы помочь клиентам максимизировать отдачу от инвестиций, VKS в составе VCF 9.1 предоставит три ключевых преимущества:
1. Повышенный масштаб и производительность для поддержки критически важных бизнес-задач.
2.
Более высокую операционную эффективность, снижающую затраты и сложность.
3.
Встроенную по умолчанию безопасность и соответствие требованиям.
VCF 9.1: краткий обзор улучшений Kubernetes
VMware VKS в VCF 9.1 принесёт улучшения сразу по трём важнейшим направлениям:
Масштаб и производительность: 500 кластеров на один control plane, ускорение развёртывания кластеров до 70%, ускорение обновлений до 75%, поддержка нескольких сетей.
Операционная эффективность: интеллектуальное размещение пулов узлов, несколько кластеров в одной зоне, распределённый transit gateway.
Безопасность и соответствие требованиям: автоматизированное внедрение секретов и тонкое управление доступом.
Повышенный масштаб и производительность для критически важных бизнес-задач
Будь то пиковые нагрузки в розничной торговле, глобальные сервисы или крупномасштабные AI-задачи — инфраструктура должна реагировать мгновенно и при этом не терять стабильности.
В VCF 9.1 возможности VKS позволят:
Быстро выделять ресурсы — время развёртывания сократится до 70%.
Достигать огромного масштаба — до 500 кластеров в рамках одного control plane.
Повышать производительность — изолировать критически важные приложения для лучшего качества обслуживания.
Выгоды для бизнеса:
Более быстрый запуск новых сервисов, улучшенный клиентский опыт во время пиковых нагрузок и возможность поддерживать требования современных рабочих нагрузок без перепроектирования инфраструктуры.
Выгоды для платформенной инженерии:
Современный ландшафт приложений охватывает широкий спектр требований к производительности — от высокопроизводительных и чувствительных к задержкам приложений до интенсивных по GPU AI-нагрузок. Организации стремятся к более сильной изоляции, уменьшению зоны поражения при сбоях и кастомизированным требованиям к кластерам, что увеличивает потребность в большем количестве кластеров.
Рис. 2. VKS поддержит до 500 рабочих кластеров на один control plane для лучшей изоляции рабочих нагрузок и значительно меньшей площади атаки.
Для более крупных инфраструктур можно развернуть несколько экземпляров control plane и централизованно управлять ими через VCF Automation (VCFA). Это обеспечивает горизонтальное масштабирование при сохранении единообразия операций.
Внезапные всплески спроса, типичные для электронной коммерции в сезон распродаж, потокового видео или финансовых приложений во время рыночной волатильности, требуют инфраструктуры, способной реагировать в реальном времени. Кроме того, организациям часто сложно оперативно подготавливать зеркальные среды для тестирования перед выводом в производственную среду. Чтобы ответить на эти потребности, VKS повысит операционную скорость: развёртывание новых кластеров ускорится до 70%, а окна обновлений сократятся до 75%.
Чтобы обеспечить лучшее качество обслуживания для трафикоёмких потоковых приложений, чувствительных к задержкам финансовых сервисов или регулируемых приложений с требованиями к классифицированному доступу, VKS в VCF 9.1 представит расширенные сетевые возможности. Узлы кластера смогут разворачиваться с несколькими vNIC, что позволит изолировать трафик на уровне узла (рис. 3). Это даёт возможность разделять трафик приложений, систем хранения и управления, а также выделять отдельные сетевые маршруты для нагрузок, чувствительных к задержкам или требующих высокой пропускной способности, повышая производительность, стабильность и операционный контроль.
Рис. 3. Рабочий узел VKS изолирует высокопроизводительный трафик за счёт поддержки нескольких vNIC.
Повышение операционной эффективности для снижения стоимости инноваций
Одна из самых существенных скрытых статей расходов в корпоративной ИТ-инфраструктуре — операционное трение. VKS в VCF 9.1 получит как улучшения, специфичные для Kubernetes, так и более широкие платформенные возможности, появившиеся в VCF:
Интеллектуальное размещение пулов узлов — на основе алгоритма vSphere Distributed Resource Scheduler, что устраняет инфраструктурные узкие места, замедляющие развёртывание.
Несколько кластеров в одной зоне — для неразрушающего управления жизненным циклом оборудования и масштабирования без ручной работы.
Организации добиваются более быстрого выхода на ценность за счёт ускорения пути инноваций от концепции к продуктивной эксплуатации. Кроме того, приложения остаются доступными и прибыльными во время миграции сервисов и текущих работ по обслуживанию оборудования, что снижает потери от простоев.
Выгоды для платформенной инженерии:
При развёртывании рабочих нагрузок размещение пулов узлов является критически важной, но зачастую сложной задачей. Инженерам платформ приходится учитывать широкий спектр приложений: AI-приложениям нужен доступ к GPU, потоковым — высокопроизводительное хранилище, e-commerce — высокая доступность. При этом инженеры платформ не должны быть обременены глубокой инфраструктурной экспертизой, необходимой для работы со специализированными ресурсами — таких как доступ к GPU, требования к высокоёмкому хранению, осведомлённость о зонах, доступность ресурсов между зонами, распределение нагрузки и ограничения, связанные с отказоустойчивостью (HA), которые предъявляют современные рабочие нагрузки.
Благодаря интеллектуальному размещению пулов узлов VKS снизит требования к глубокой инфраструктурной экспертизе инженеров платформ (рис. 4 ниже). Такая автоматизация обеспечит гибкость без фрагментации развёртываний и даст инженерам платформ согласованный, предсказуемый и надёжный опыт работы. Эти улучшения существенно сокращают трение при развёртывании рабочих нагрузок, исключая сбои при размещении и трудноотлаживаемые проблемы с распределением ресурсов.
Рис. 4. Снижение трения при развёртывании благодаря интеллектуальному размещению пулов узлов.
С поддержкой нескольких кластеров в одной зоне администраторы облака смогут заменять, выводить из эксплуатации или обновлять оборудование без влияния на доступность приложений и без нарушения «желаемого состояния», что даёт инженерам платформ спокойствие (рис. 5). Такая абстракция также позволит инфраструктуре динамически реагировать на растущие потребности в вычислительных и дисковых ресурсах: масштабирование больше не требует сложной переработки среды.
Рис. 5. Несколько кластеров в одной зоне с нулевым простоем при обслуживании жизненного цикла и улучшенным масштабированием.
Инженеры платформ смогут быстрее подключать новые рабочие нагрузки и получать лучшую производительность сети благодаря Distributed Transit Gateway (DTGW), который обеспечивает более простой и согласованный способ подключения нагрузок к коммутирующей фабрике. DTGW также улучшает задержки и масштабирование: хост ESX подключается напрямую к коммутирующей фабрике, без необходимости использовать полный edge-кластер NSX.
Усиленная безопасность и соответствие требованиям, встроенные, а не «прикрученные сверху»
После того как вопросы производительности и масштаба решены, следующий важный рубеж — безопасность и соответствие требованиям. Безопасность в Kubernetes-средах часто фрагментирована: для управления секретами и применения политик доступа требуется множество инструментов и ручных процессов.
VKS в VCF 9.1 упростит эту задачу, встраивая средства контроля безопасности в саму платформу:
Интегрированные процессы управления секретами уменьшают объём ручной настройки.
Детальное управление доступом обеспечивает соблюдение принципа минимальных привилегий.
Единообразное применение политик улучшает аудируемость и готовность к соответствию.
Это позволит командам платформ автоматизировать работу с секретами и согласованно применять границы доступа во всех кластерах, снижая операционные риски и повышая готовность к проверкам на соответствие.
Выгоды для бизнеса:
Организации получат сокращённую площадь атаки и сниженный риск утечек данных, что обеспечит защиту критической инфраструктуры от современных угроз. Такой единый подход естественным образом формирует более прочный профиль соответствия за счёт согласованного применения политик и повышает уверенность при развёртывании регулируемых и чувствительных рабочих нагрузок.
Выгоды для платформенной инженерии:
Клиенты смогут достичь более устойчивого профиля безопасности благодаря упрощённому автоматизированному способу внедрения секретов в процесс развёртывания (рис. 6 ниже). Гарантируя безопасную обработку чувствительных данных без ручной настройки, это улучшение усилит общую безопасность, повысит аудируемость и предоставит единый механизм управления секретами для всех рабочих нагрузок.
Рис. 6. Упрощённое и автоматизированное внедрение секретов.
Инженеры платформ также смогут настраивать гранулированные политики доступа рабочих нагрузок к секретам, сокращая площадь атаки и гарантируя, что секреты получают только авторизованные нагрузки. Это поможет заказчикам соответствовать требованиям комплаенса и регуляторов.
Container-as-a-Service в VCF 9.1
VCF 9.1 представит среду исполнения Container Service, поставляемую через VCF Automation, с полным управлением жизненным циклом. Эта упрощённая контейнерная среда исполнения будет работать непосредственно на ESX без накладных расходов на кластер, обеспечивая изоляцию рабочих нагрузок и эффективность использования ресурсов. Платформа VCF полностью автоматизирует планирование, изоляцию, оптимизацию производительности и обновления. Когда архитектура приложения эволюционирует, пользовательский интерфейс сгенерирует согласованный YAML для плавного перехода к кластерам VKS — обеспечивая мягкий переход от простых развёртываний контейнеров к полноценным возможностям Kubernetes.
О релизе VKS 3.6
Хотя VKS входит в единую интегрированную программную платформу облака, циклы выпуска компонента VKS отделены от графика релизов VCF: для VKS предусмотрено три обновления в год. Такое отдельное расписание было разработано специально, чтобы обеспечить плавную синхронизацию с релизами upstream-проекта CNCF Kubernetes. С выходом в феврале VKS 3.6 заказчики могут разворачивать полностью соответствующие требованиям кластеры на актуальной версии Kubernetes 1.35. Для удобства планирования VKS 3.6 также позволяет одновременно развёртывать и обслуживать кластеры Kubernetes версий 1.33 и 1.34 наряду с последним релизом.
Инфраструктурные команды сталкиваются с парадоксом: среды становятся все сложнее, а бюджеты и численность персонала остаются прежними. VMware Cloud Foundation (VCF) 9.1 призвана ответить на эту проблему инновациями, которые повышают эффективность, ускоряют доставку приложений и усиливают киберустойчивость, сохраняя при этом простоту эксплуатации. За последние несколько лет разговор об инфраструктуре изменился. Вопрос уже не только в том, где выполняются рабочие нагрузки, но и в том...
Развёртывание Kubernetes в производственной среде требует не просто установки кластера — необходимо с самого начала принять правильные архитектурные решения, от которых будут зависеть масштабируемость, доступность и управляемость платформы. Вебинар специалистов Broadcom Professional Services и MomentumAI посвящён ключевым принципам проектирования VMware vSphere Kubernetes Service (VKS) поверх VMware Cloud Foundation (VCF). Докладчики — Vijay Appani, Solution Architect компании Broadcom, и Caleb Washburn, CTO и основатель MomentumAI — рассматривают проверенные шаблоны проектирования, которые их команды применяют в реальных enterprise-проектах.
Что такое VKS и зачем запускать Kubernetes на VCF
VMware vSphere Kubernetes Service (VKS) — это встроенный механизм запуска Kubernetes на платформе vSphere, интегрированный непосредственно в VMware Cloud Foundation. В отличие от сторонних дистрибутивов, VKS использует подтверждённую CNCF версию Kubernetes и глубоко интегрирован с инфраструктурными компонентами VCF: вычислительным слоем (vSphere), сетью (NSX) и хранилищем (vSAN). Это позволяет организациям строить современную private cloud-платформу, избегая «лоскутных» решений и накапливаемого технического долга.
Ключевая идея заключается в том, что VCF предоставляет единую платформу, объединяющую ресурсы compute, network и storage в согласованный операционный слой. Kubernetes в таком окружении получает доступ к корпоративным политикам хранения, сетевой изоляции на уровне неймспейсов и интеграции с порталом самообслуживания VCF Automation — всё это без необходимости разворачивать и поддерживать внешние инструменты.
Три модели развёртывания Supervisor-кластера
Центральным компонентом VKS является Supervisor-кластер — уровень управления Kubernetes, развёртываемый поверх рабочего домена VCF. Существует три основные топологии его размещения, и выбор между ними определяет поведение платформы при сбоях, требования к ресурсам и сложность эксплуатации.
Модель 1: Single Cluster. Supervisor-кластер и рабочие нагрузки размещаются в одном vSphere-кластере. Это наиболее простой с точки зрения конфигурации вариант. Он подходит для начального знакомства с платформой или сред разработчиков, однако не обеспечивает разделения плоскости управления и плоскости данных. При сбое кластера теряется и управление, и рабочие нагрузки.
Модель 2: Multi-Cluster с разделёнными зонами. Supervisor-контрольная плоскость развёртывается в отдельном управляющем домене, а рабочие нагрузки — в выделенных рабочих доменах. Такое разделение обеспечивает независимость управляющего слоя от прикладного, что принципиально важно для инфраструктуры среднего масштаба. Недостатком является необходимость большего числа хостов и более сложная настройка сети и зон.
Модель 3: vSphere Zones (рекомендуется для enterprise). Виртуальные машины управляющей плоскости Supervisor-кластера распределяются по трём vSphere Zones — логическим группам, каждая из которых соответствует отдельному физическому кластеру. Рабочие нагрузки могут совместно использовать те же три зоны или размещаться в выделенных. Платформа выдерживает полный отказ одной зоны без потери доступности — ни управляющий слой, ни приложения не затрагиваются. Данная модель рекомендуется для крупных enterprise-развёртываний, требующих гарантий высокой доступности на уровне инфраструктуры.
Сетевые опции: NSX или VDS
При настройке сети для VKS на VCF доступны два варианта: NSX и vSphere Distributed Switch (VDS). Выбор между ними оказывает существенное влияние на функциональность платформы и возможности автоматизации.
NSX является рекомендованным выбором для любого нового (greenfield) развёртывания VCF. Overlay-сеть на основе Geneve/VXLAN обеспечивает полную изоляцию на уровне неймспейсов, встроенный распределённый файрвол, встроенный балансировщик нагрузки уровней L4 и L7 (NSX Advanced Load Balancer / AVI), а также глубокую интеграцию с VCF Automation. Именно NSX позволяет реализовать портал самообслуживания, где разработчики и команды самостоятельно запрашивают ресурсы, не взаимодействуя напрямую с vSphere-администраторами.
VDS применяется в случаях, когда NSX не может быть развёрнут — например, при модернизации существующей инфраструктуры или при строгих ограничениях лицензирования. VDS поддерживает базовые возможности VKS, однако не поддерживает VCF Automation, overlay-сети и встроенный балансировщик нагрузки. При использовании VDS в производственной среде потребуется внешний балансировщик, что добавляет операционную сложность.
Отдельно подчёркивается, что если требования к приложению предполагают L4 или L7 балансировку, использование выделенного балансировщика нагрузки является обязательным — независимо от выбранного сетевого варианта.
Хранилище: vSAN, политики и управление томами
Хранилище в архитектуре VKS разделяется на два типа: эфемерное (ephemeral) и постоянное (persistent). Эфемерное хранилище используется для дисков самих узлов Kubernetes (Control Plane VMs и Worker Nodes) и временных томов Pod'ов. Оно берётся из основного или дополнительного хранилища рабочего домена и настраивается при активации Supervisor-кластера.
Постоянные тома (Persistent Volumes, PV) предназначены для stateful-приложений — баз данных, очередей сообщений, систем хранения состояния. Доступ к постоянному хранилищу управляется через Storage Policies — политики хранения vSAN, которые администратор создаёт в vCenter. Политики описывают параметры производительности, доступности (RAID-1, RAID-5/6) и шифрования. Каждый арендатор (tenant) в мультитенантной конфигурации получает доступ только к тем политикам хранения, которые ему явно назначены.
Если арендатору не назначена ни одна storage policy, он не сможет создавать Persistent Volume Claims (PVC) — это удобный механизм ограничения: организации могут предоставлять namespace без прав на stateful-хранение там, где это нежелательно. Поддерживаются режимы доступа RWO (ReadWriteOnce) и RWX (ReadWriteMany) — последний обычно требует дополнительных компонентов типа vSAN File Services или внешних NFS-решений.
Мультитенантность и интеграция с VCF Automation
Одним из ключевых преимуществ VKS на VCF является встроенная поддержка мультитенантности через механизм namespace и интеграцию с VCF Automation. Каждый неймспейс представляет собой изолированную рабочую область, которой могут быть назначены: квоты на CPU и RAM, доступные storage policies, сетевые профили NSX, а также права доступа пользователей или групп из Active Directory / LDAP.
VCF Automation предоставляет портал самообслуживания, через который подразделения и команды разработчиков могут самостоятельно запрашивать Kubernetes namespace, инициировать развёртывание приложений и управлять ресурсами — без участия администратора vSphere. Платформа автоматически создаёт необходимые ресурсы: сетевые сегменты NSX, политики хранения, RBAC-права. Это, по словам авторов вебинара, является «новейшим и наиболее зрелым способом организации современного private cloud».
Рекомендуется начинать с NSX в качестве сетевого стека при любом новом greenfield-развёртывании VCF именно потому, что VCF Automation поддерживает только NSX, и без него модель самообслуживания недоступна.
Рекомендации по проектированию production-платформы
По итогам вебинара сформулированы следующие практические рекомендации для команд, проектирующих VKS на VCF в производственной среде:
Используйте топологию vSphere Zones для любого развёртывания с требованиями к высокой доступности — она обеспечивает автоматический failover при отказе целого кластера без вмешательства администратора.
Выбирайте NSX как сетевой стек при greenfield-развёртывании — только с NSX доступна полная интеграция с VCF Automation и портал самообслуживания.
Планируйте storage policies заранее: определите требования к производительности и отказоустойчивости для разных классов рабочих нагрузок ещё до запуска первых неймспейсов.
Разграничивайте доступ к хранилищу на уровне арендаторов — не назначайте storage policies тем неймспейсам, которым stateful-хранение не нужно.
Если среда требует L4/L7 балансировки, включайте NSX Advanced Load Balancer (AVI) в архитектуру с самого начала — добавить его позднее значительно сложнее.
Не смешивайте управляющую и рабочую плоскости в одном кластере для производственной среды: выделяйте отдельный рабочий домен для приложений, даже если это требует дополнительных хостов.
Вопросы и ответы: ключевые моменты
В ходе сессии вопросов и ответов слушателей интересовали несколько практических аспектов. На вопрос о поддержке собственных сервисов поверх VKS ответ был однозначным: технически это возможно, однако рекомендуется использовать интегрированный стек — vSAN, NSX и VCF Automation — поскольку именно на нём строится поддержка и будущее развитие платформы.
На вопрос об источниках эфемерного хранилища пояснялось, что при активации Supervisor-кластера администратор указывает datastore, из которого берётся эфемерное хранилище для узлов Kubernetes и временных томов Pod'ов. Это может быть как vSAN, так и дополнительное (supplemental) хранилище рабочего домена.
Относительно нестандартных конфигураций — в частности, развёртывания VKS поверх существующей vSphere-среды без полного стека VCF — авторы отметили, что такие варианты существуют, но лишены ключевых преимуществ интегрированной платформы: автоматизации, самообслуживания и единого управления жизненным циклом.
Итог
VMware vSphere Kubernetes Service на VMware Cloud Foundation представляет собой зрелую enterprise-платформу для запуска production-Kubernetes с полной интеграцией в корпоративную инфраструктуру. Правильный выбор топологии Supervisor-кластера, сетевого стека и модели хранения на этапе проектирования определяет, насколько легко платформа будет масштабироваться и насколько просто её будет эксплуатировать в долгосрочной перспективе. Ознакомиться с предстоящими вебинарами серии VCF можно по ссылке go-vmware.broadcom.com/VCFWebinars.
Современный разработчик привык к беспрепятственному доступу к инфраструктуре. В публичном облаке достаточно нажать кнопку или вызвать API — и через несколько минут кластер Kubernetes, виртуальная машина или база данных готовы к работе. Но что происходит, когда требования к суверенитету данных, соответствию нормативным требованиям или прогнозируемости затрат обязывают развёртывать нагрузки на собственной инфраструктуре?
Исторически онпрем-инфраструктура означала создание заявок в IT-систему и ожидание ресурсов в течение дней или даже недель. Такие задержки превращались в серьёзное препятствие для вывода продуктов на рынок. Разработчики, уставшие от очередей, нередко поднимали собственные «теневые» базы данных на неуправляемых виртуальных машинах — только чтобы двигаться быстрее. Результатом становились бесконтрольное разрастание баз данных, дрейф конфигураций, отсутствие управления и серьёзные угрозы безопасности.
Платформенная инженерия на базе VMware Cloud Foundation (VCF) изменила эту картину. Используя платформу частного облака VCF, организации могут устранить разрыв между IT-операциями и командами разработчиков. VCF обеспечивает настоящее «от платформы до данных» самообслуживание, сравнимое с возможностями публичного облака: разработчики получают нужную им скорость, а платформенные инженеры — централизованное управление всем парком ресурсов.
Соответствие публичному облаку: эквиваленты на on-prem VCF
Чтобы оценить возможности VCF как платформы частного облака, полезно сопоставить её функциональность с сервисами публичного облака, которые разработчики уже хорошо знают. Для тех, кто работал с AWS, on-prem-эквиваленты в VCF выглядят следующим образом:
Amazon EC2 > VCF VM Service: позволяет разработчикам декларативно развёртывать традиционные виртуальные машины и управлять ими совместно с контейнерами.
Amazon EKS > VCF VKS (vSphere Kubernetes Service): предоставляет конформные Kubernetes-кластеры с самообслуживанием, нативно встроенные в VCF.
Amazon RDS > VCF DSM (Data Services Manager): реализует инструмент управления парком баз данных в режиме Database-as-a-Service (DBaaS) по запросу.
Совместное использование этих трёх компонентов позволяет платформенным командам предлагать разработчикам комплексный каталог сервисов, управляемый через API, непосредственно из собственного датацентра.
Рабочий процесс платформенного инженера: установка границ
Архитектурный принцип этого решения — управление через персоны. Системный администратор или платформенный инженер определяет «правила игры» и сохраняет контроль, а разработчик потребляет ресурсы строго в заданных рамках. Рабочий процесс устроен следующим образом.
1. Создание границ. Администратор инфраструктуры создаёт vSphere namespace в VCF. Этот namespace выступает границей tenancy: к конкретному проекту или команде разработчиков привязываются лимиты вычислительных ресурсов, памяти и хранилища.
2. Определение инфраструктуры и политик. В рамках namespace платформенный инженер задаёт правила взаимодействия:
Вычислительные ресурсы: размеры кластеров, пулы ресурсов и классы ВМ (размеры: small, medium, large) — чтобы разработчики не превышали допустимое потребление.
Хранилище и сеть: конкретные политики хранения (vSAN или NFS) и привязка нагрузок к нужным VLAN и VPC-подсетям.
Сервисы данных в DSM: разрешённые движки баз данных и их версии, предварительно проверенные командой DBA.
Опыт разработчика: развёртывание в режиме самообслуживания
После того как администратор задал политики, платформенный инженер открывает доступ команде разработки через защищённый API-токен. С этого момента разработчики полностью самостоятельны — никакого ожидания в очереди задач и утверждений. Используя стандартный инструментарий Kubernetes (kubectl), портал или API DSM либо собственные Terraform-пайплайны, они могут:
поднять новый Kubernetes-кластер (VKS) для тестирования микросервисов;
выбрать движок базы данных — PostgreSQL, MySQL или Microsoft SQL Server (появится в версии 9.1).
При этом все самостоятельно подготовленные ресурсы автоматически соответствуют корпоративным политикам резервного копирования, сети и безопасности, установленным администратором.
Автоматизация и интеграция с Infrastructure-as-Code
Всю описанную среду можно полностью автоматизировать с помощью подхода Infrastructure as Code. Платформенная команда может управлять пространствами имен и конфигурациями сервисов через различные инструменты в зависимости от предпочтений: Kubernetes CRD, Terraform-манифест или корпоративный блупринт, охватывающий целый комплекс ресурсов — VKS-кластер с набором виртуальных машин, сервисы данных DSM и даже ArgoCD для доставки приложений в VKS-кластеры — всё в рамках единого набора API-вызовов.
Ниже — пример CRD для декларативного развёртывания базы данных в namespace, демонстрирующий простоту этого подхода. CRD можно использовать как часть GitOps-процесса:
День второй: операционное управление после запуска
Одно из наиболее значимых преимуществ платформенного подхода, особенно с Data Services Manager, состоит в том, что он не заканчивается на первоначальном «нажатии кнопки». Платформа автоматизирует критически важные операции второго дня жизненного цикла — когда приложению предстоит выйти в продуктив. Задачи, которые традиционно поглощали ресурсы DBA, теперь решаются простым изменением декларативного параметра в CRD:
Высокая доступность: автоматическое развёртывание кластеров для немедленной отказоустойчивости.
Масштабируемость: возможность легко добавлять read-реплики по мере роста нагрузки на приложение.
Защита данных: автоматическое резервное копирование и восстановление до точки во времени (PITR) — «из коробки».
Управление: централизованная видимость для платформенной команды с контролем использования и устранением разрастания баз данных по всем рабочим доменам.
Поддержка OSS-баз данных корпоративного уровня: DSM предоставляет возможности и поддержку коммерческого класса, недоступные в бесплатных open-source версиях PostgreSQL или MySQL.
Заключение
Создание каталога самообслуживания — от платформы до данных — не требует переноса всего в публичное облако. Используя VCF, VKS и DSM, организации получают гибкость публичного облака в сочетании с безопасностью и контролем собственной частной инфраструктуры. Платформенные инженеры при этом трансформируются из ИТ-привратников в enabler'ов — обеспечивая разработчиков API-эндпоинтами, Kubernetes-кластерами и управляемыми базами данных, необходимыми для более быстрой и безопасной разработки ПО, готового к производственному окружению.
В последнем выпуске подкаста Virtually Speaking Ли Ховард, руководитель IAM Product Management в Broadcom, рассказал, как Identity Security для VMware Cloud Foundation (VCF) обеспечивает безопасный, масштабируемый доступ с нулевым доверием в современных средах частного облака.
Этот выпуск является частью серии VCF Advanced Services, где освещаются возможности, усиливающие безопасность, соответствие требованиям и операционный контроль сверх базовой инфраструктуры.
В этом видео объясняется, почему идентификация больше не может рассматриваться как дополнительная функция безопасности. В мире Kubernetes-нагрузок, приложений, управляемых через API, систем AI и требований суверенных облаков идентификация должна быть фундаментальной.
От статической аутентификации к Zero Trust
Традиционные стратегии управления идентификацией строились вокруг служб каталогов, статических политик и базового единого входа. Эта модель работала, когда приложения были централизованы, а пользователи действовали в пределах определённых сетевых границ. Современное частное облако устроено иначе.
Пользователи распределены. Приложения контейнеризированы. Сервисы аутентифицируются друг перед другом. AI-агенты и платформы автоматизации действуют самостоятельно. В такой среде идентификация должна быть непрерывной, контекстной и учитывающей риски.
Архитектура нулевого доверия оценивает не только то, кто входит в систему, но и как, откуда и к чему именно пытается получить доступ. Безопасность идентификации становится динамической, адаптируясь к поведенческим сигналам, уровням привилегий и контексту среды. Именно здесь современные возможности IAM и PAM становятся критически важными.
IAM и PAM в VMware Cloud Foundation
Identity and Access Management (IAM) управляет аутентификацией, авторизацией и федерацией, используя такие стандарты, как SAML и OpenID Connect. В частном облаке, построенном на VMware Cloud Foundation, IAM должен быть управляемым через API и дружественным к DevOps, позволяя командам разработки интегрировать идентификацию в современные рабочие процессы без жёстких проприетарных ограничений.
Privileged Access Management (PAM) защищает наиболее чувствительный уровень среды: административный доступ и доступ уровня root. PAM обеспечивает доступ с минимально необходимыми привилегиями, хранит учётные данные в защищённых хранилищах, автоматически ротирует пароли и записывает привилегированные сессии. Это снижает риск внутренних угроз, злоупотребления учётными данными и горизонтального перемещения во время взлома.
Важно, что безопасность идентификации теперь распространяется не только на человеческих администраторов. Машинные идентификаторы, сервисные аккаунты и системы автоматизации также должны находиться под управлением. По мере роста Kubernetes-нагрузок и AI-систем управление секретами и доступом нечеловеческих субъектов становится столь же важным, как и управление входом пользователей.
Нативная для Kubernetes идентификация в частном облаке
Платформа Identity Security работает на Kubernetes внутри VMware Cloud Foundation. Такая облачно-нативная архитектура обеспечивает быстрое развертывание, автоматическое масштабирование при всплесках аутентификации и обновления без простоев.
Сервисы идентификации являются критически важными. Если аутентификация не работает, не работает ничего. Архитектура на базе Kubernetes обеспечивает устойчивость и операционную эффективность, одновременно устраняя необходимость избыточного резервирования ресурсов, характерную для устаревших систем идентификации.
Идентификация как ключевая возможность платформы
По мере того как организации пересматривают размещение нагрузок, требования суверенности и стратегии внедрения AI, идентификация становится центральным элементом архитектуры частного облака. Она должна поддерживать доступ по модели нулевого доверия, соответствие нормативным требованиям, управление машинными идентификациями и единый контроль в разных средах.
Безопасность идентификации больше не ограничивается входом в систему. Речь идёт о контроле доступа повсюду — для пользователей, приложений, сервисов и данных. И в современной среде VMware Cloud Foundation она встроена непосредственно в саму платформу.
Что дальше в серии роликов?
Этот выпуск является частью продолжающейся серии Virtually Speaking, посвящённой Advanced Services, доступным в VMware Cloud Foundation. В каждом выпуске специалисты VMware подробнее рассматривают конкретный сервис и практические результаты, которые он обеспечивает, вместе с людьми, которые ежедневно создают и внедряют эти решения.
В следующих выпусках будут освещаться сервисы, расширяющие возможности VCF за пределы базовой инфраструктуры, включая такие области, как продвинутые сети, безопасность, сервисы данных, наблюдаемость и AI. Цель этих роликов — показать, как эти возможности работают вместе, помогая организациям модернизировать инфраструктуру, защищать приложения и ускорять инновации.
Компания VMware выпустила новый документ "VMware vSAN Frequently Asked Questions", представляющий собой подробное руководство с ответами на наиболее распространённые вопросы о технологии VMware vSAN — программно-определяемой системе хранения (Software-Defined Storage), встроенной в гипервизор VMware ESX и используемой в средах VMware vSphere.
vSAN объединяет локальные диски серверов в общий распределённый датастор, который используется виртуальными машинами и управляется через интерфейс vSphere. Такой подход позволяет создавать гиперконвергированную инфраструктуру (HCI), где вычисления и хранение данных объединены в одном кластере серверов.
FAQ-документ охватывает широкий спектр тем:
Архитектуру vSAN (Original Storage Architecture и Express Storage Architecture)
Требования к оборудованию и сети
Варианты развертывания кластеров
Масштабирование и отказоустойчивость
Интеграцию с другими функциями VMware
Основные разделы FAQ
Вопросы распределены по большим тематическим блокам:
General Information — общая информация о vSAN
Express Storage Architecture (ESA)
Availability — отказоустойчивость
Cloud-Native Storage
vSAN File Services
vSAN Storage Clusters (disaggregated storage)
Stretched clusters и 2-node clusters
Networking
Capacity и Space Efficiency
Operations
Performance
Security
vSAN Data Protection
Каждый из этих разделов содержит от нескольких до нескольких десятков вопросов (всего более 180 вопросов и ответов), поэтому документ на 56 страниц фактически представляет собой большой справочник по эксплуатации и архитектуре vSAN. Это один из самых подробных FAQ-документов VMware по продукту vSAN, он помогает понять архитектуру решения, требования к оборудованию и лучшие практики внедрения vSAN в корпоративных средах.


 RSS