Искусственный интеллект несёт в себе потенциал для преобразования бизнеса, однако его промышленное внедрение на предприятиях по-прежнему ограничено. Приватность, защита интеллектуальной собственности и соответствие нормативным требованиям представляют собой серьёзные экзистенциальные угрозы. Организациям приходится устанавливать детальные границы доступа и оберегать проприетарные данные. Стремительный переход к агентному AI многократно усиливает эти исходные точки трения, порождая критически важные проблемы эксплуатации, стоимости и управления. В отличие от традиционных моделей вывода с одиночным вызовом, автономные агенты работают в динамических циклах, что приводит к непредсказуемому нелинейному росту затрат на токены и перегружает унаследованную ИТ-инфраструктуру.
Новые вызовы эпохи агентного AI
В эпоху агентного AI перед предприятиями встают дополнительные задачи, которые необходимо решать.
- Эксплуатационная сложность: агентные рабочие нагрузки ведут себя не так, как традиционные запросы на вывод. Агенты выстраивают цепочки из десятков вызовов моделей, обращений к инструментам и циклов рассуждений. Традиционная инфраструктура попросту не создавалась под такой устойчивый и динамичный характер спроса. К трудностям развёртывания относятся:
- Развёртывание Day 0: вычислительные ресурсы, сети, хранилище, Kubernetes и сетевая инфраструктура.
- Эксплуатация Day 2: управление жизненным циклом, включая установку исправлений, обновления, версионирование моделей и миграции между фреймворками, — всё это превращается из отдельных проектов в непрерывные, накладывающиеся друг на друга циклы.
- Рост затрат на токены: AI-агенты работают в итеративных циклах, поэтому потребление токенов масштабируется нелинейно. Более того, по прогнозам, к 2030 году стоимость токенов вырастет вплоть до 24 раз. Раздувание контекста, обмен сообщениями между несколькими агентами, исправление ошибок и рефлексия, а также внутренние промпты «размышления» — всё это примеры причин непредсказуемого удорожания токенов. Облачные LLM тарифицируются по числу токенов, и их пользователи уже сталкивались с неожиданным ростом расходов.
- Пробелы в управлении: инженерные команды создают приложения и разворачивают автономных агентов быстрее, чем за ними успевают процессы приватности, безопасности, управления и эксплуатации. В результате возникла разрозненная среда, в которой у руководителей может не быть централизованной картины того, какие модели, инструменты и агенты используются и каким именно образом. Инфраструктура обязана обеспечивать детальный контроль приватности, а также доступа к инфраструктуре и данным, ограничивая то, что каждый агент может читать и изменять, — даже если сама базовая модель считается доверенной.
VMware Private AI Cloud
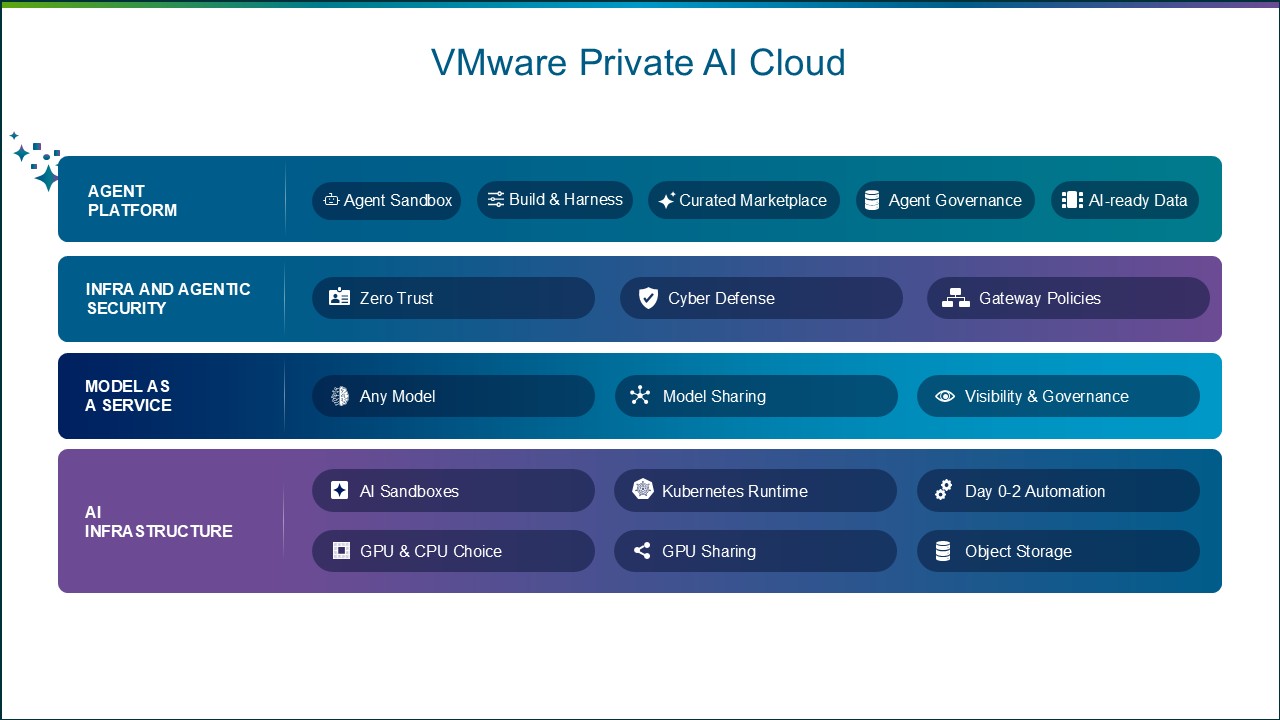
Для решения этих задач компания Broadcom представила VMware Private AI Cloud — решение, позволяющее предприятиям экономично масштабировать AI, работать более безопасно и быстро внедрять инновации. Построенный на передовых программных возможностях Broadcom, VMware Private AI Cloud даёт организациям готовый к промышленной эксплуатации путь к безопасной разработке, запуску и управлению нагрузками вывода, агентными приложениями и традиционными корпоративными нагрузками — совместно, на платформе VCF, с широким выбором оборудования, моделей и ускорителей.
- Экономичное масштабирование AI: VMware Private AI Cloud охватывает три основных источника затрат на AI — капитальные вложения в оборудование, эксплуатационную сложность и экономику токенов (токеномику). VCF поддерживает графические процессоры, CPU и ускорители ведущих производителей, а также серверное оборудование крупных OEM- и ODM-поставщиков, что позволяет заказчикам экономично эксплуатировать гетерогенные кластеры. Для оптимизации токеномики и использования ресурсов предусмотрены мониторинг токенов, мультитенантное совместное использование моделей, расширенный учёт GPU/vGPU и панель наблюдаемости AI-метрик. Одна из ключевых инноваций VMware Private AI Cloud — VMware AI Factory, обеспечивающая быстрый путь от развёртывания на «голом железе» до запуска первой модели.
- Более безопасная эксплуатация: платформа VCF построена по принципу эшелонированной защиты в соответствии с NIST CSF 2.0 и противостоит угрозам, усиленным средствами AI, за счёт минимизации поверхности атаки и обеспечения непрерывного соответствия требованиям. Автоматические обновления, не нарушающие работу сервисов, поддерживают системы в актуальном состоянии, а VMware vDefend применяет виртуальное патчирование и горизонтальную защиту на уровне гипервизора с микросегментацией, реализуя принцип Zero Trust и блокируя эксплойты. Кроме того, многоуровневая защита от угроз vDefend, а также межсетевой экран уровня веб-приложений и защита API в VMware Avi Load Balancer предотвращают сложные атаки.
- Быстрые инновации для эпохи агентного AI: в отличие от традиционных приложений, автономные AI-агенты способны действовать бесконтрольно, выходить за рамки своих полномочий или неверно истолковывать инструкции. Соответственно, доверие к ним зависит от надёжных механизмов контроля и целостности данных. VMware Tanzu Platform в связке с VMware vDefend формирует основу для доверенных корпоративных агентов за счёт архитектуры с запретом по умолчанию, готовой обвязки (harness) и курируемого маркетплейса.
Ниже — подробности о VMware AI Factory, ключевой инновации в составе VMware Private AI Cloud.
VMware AI Factory: движущая сила VMware Private AI Cloud
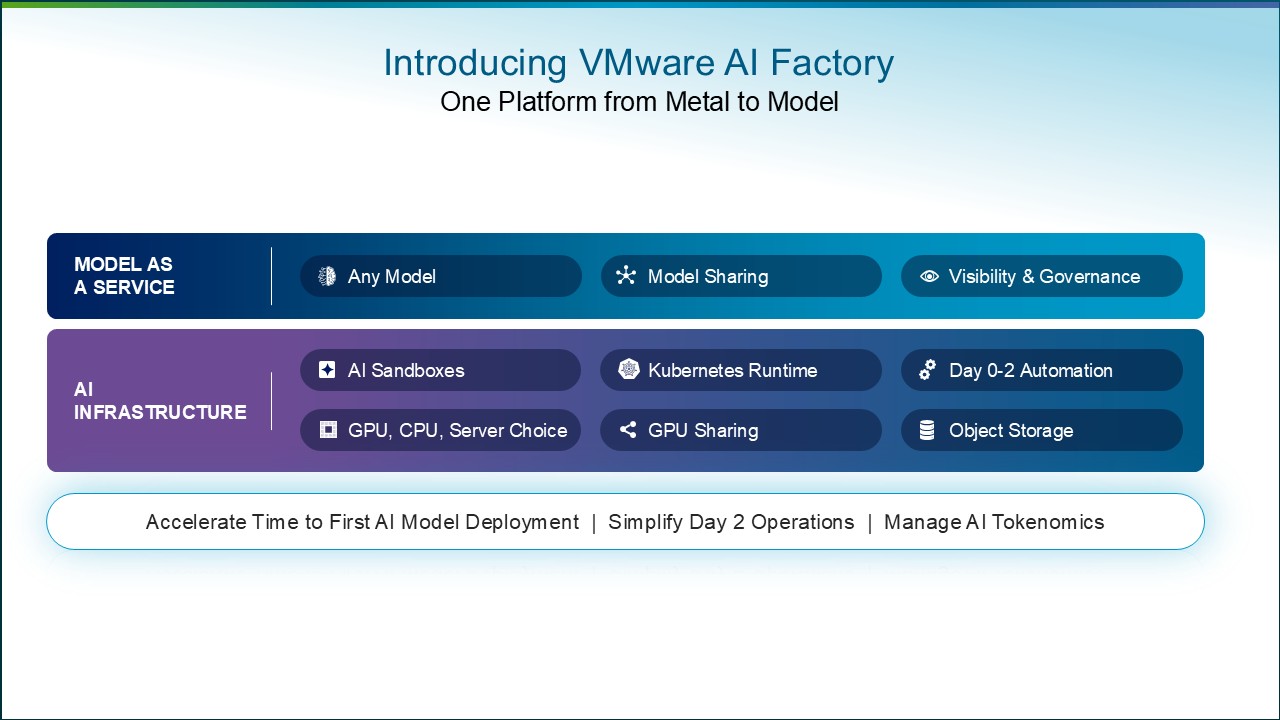
VMware AI Factory — это программно-определяемый фундамент VMware Private AI Cloud. Он даёт заказчикам упрощённый путь к промышленному AI благодаря новым средствам автоматизации развёртывания инфраструктуры, готовой к ИИ-нагрузкам, и поддержки операций Day 2. С VMware AI Factory заказчики могут быстрее выйти на развёртывание первой модели и эффективнее управлять токеномикой AI.
VMware AI Factory приближает AI-приложения непосредственно к корпоративным приватным данным внутри защищённой среды частного облака. Уникальные возможности автоматизации инфраструктуры в VCF позволяют сократить время от развёртывания сервера на «голом железе» до обслуживания первой AI-модели с недель до считанных часов. VMware AI Factory упрощает управление AI-инфраструктурой, полностью автоматизируя выделение оборудования, включение программного стека и сквозное управление жизненным циклом. Объединяя операции с оборудованием и программным обеспечением в единое автоматизированное решение, организации получают возможность быстро масштабировать AI-нагрузки при минимальной эксплуатационной сложности.
Партнёрства, обеспечивающие работу VMware AI Factory
VMware AI Factory сочетает VCF с сертифицированными серверами Dell PowerEdge и узлами VCF AI ReadyNodes от Cisco, Lenovo, Supermicro и других вендоров, а также с предпочитаемыми заказчиком программными средствами AI и архитектурами ускорителей.
Broadcom и AMD совместно работают над вариантом VMware AI Factory, объединяющим VCF с графическими процессорами AMD Instinct и открытой программной экосистемой AMD ROCm. Технология zero-touch provisioning будет оркестрировать сквозное развёртывание всего стека — от vSphere и vSAN до Kubernetes и оператора AMD GPU, — а драйвер AMD DVX сможет подключать графические процессоры к крупным виртуальным машинам, которые использует кластер VMware vSphere Kubernetes Service.
Для дальнейшего упрощения развёртывания VCF AI Factory Broadcom объявила о новом партнёрстве с MetalSoft, в рамках которого будет реализована интегрированная гетерогенная автоматизация работы с «голым железом» для VCF, сокращающая время подготовки физических серверов с недель до минут. Интеграция поможет ИТ-специалистам выделять или переразвёртывать физические серверы разных производителей напрямую через консоль управления VCF, объединяя жизненный цикл программного обеспечения и оборудования в единую операционную модель и снимая необходимость в специфичных для каждого вендора инструментах управления оборудованием и прошивками.
Новые возможности VMware AI Factory
Сервисы VCF Private AI Services помогают сделать AI управляемым, контролируемым и экономически эффективным и входят в состав VMware Cloud Foundation (VCF). Число сервисов, предлагаемых в рамках VCF Private AI Services, будет и дальше расширяться. Рассмотрим эти возможности подробнее.
Доступно в общем релизе
Мультитенантное совместное использование моделей
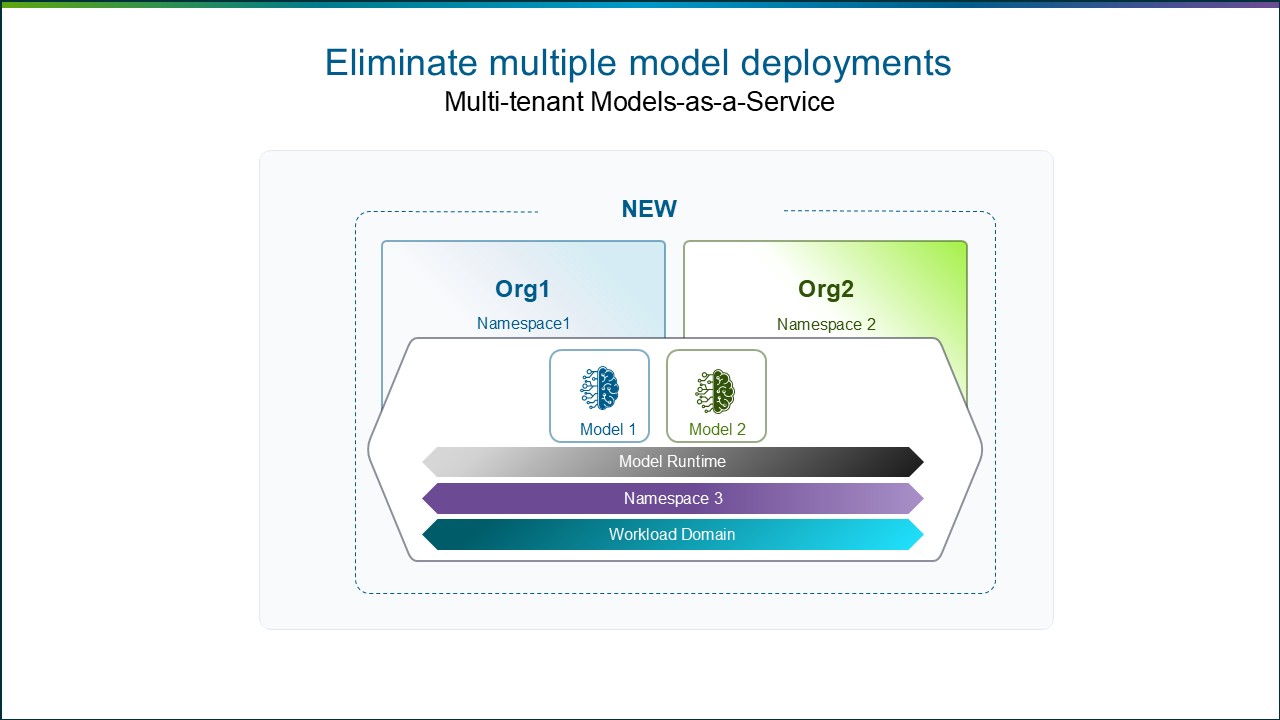
В релизе VCF 9.1.1 компонент Model Runtime был доработан так, чтобы обеспечить безопасное совместное использование AI-моделей между тенантами или отдельными направлениями бизнеса в их пространствах имён при полном сохранении приватности данных каждого из них. На практике это означает, что предприятия и облачные провайдеры теперь могут иметь один запущенный сервис Model Runtime, который обслуживает и масштабирует модели для всей организации, тогда как каждая команда или подразделение располагает отдельным приватным и защищённым пространством имён для своих данных. Эта возможность устраняет необходимость разворачивать избыточные копии модели, впустую расходуя выделенные GPU и инфраструктурные ресурсы. Одновременно сохраняются приватность и изоляция данных при оптимизации совокупной стоимости владения.
Возможности будущих релизов
AI Gateway
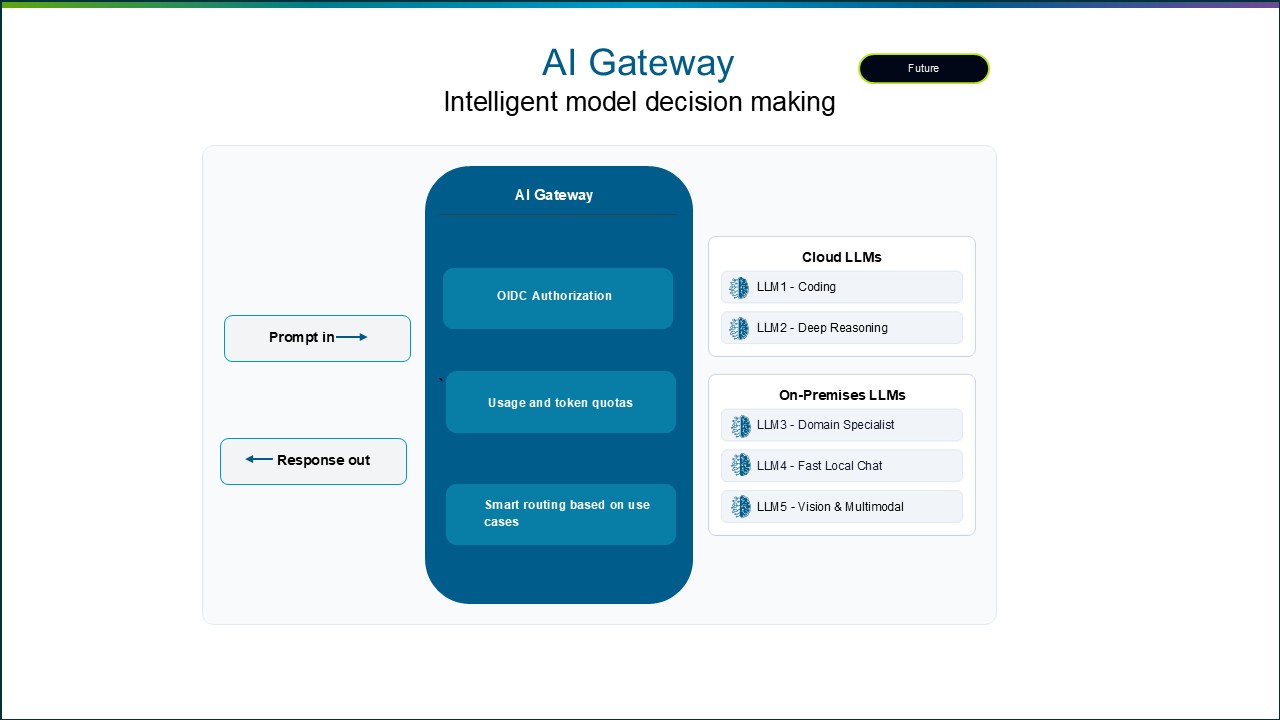
Чтобы сбалансировать сегодняшние потребности в оптимизации стоимости токенов, сценариях использования и производительности, предприятиям нужны модели, развёрнутые и в облаке, и локально. Облачные LLM могут потреблять большое количество токенов, поэтому управление ими приобретает первостепенное значение. Возможность AI Gateway существенно поможет в разрешении этих конкурирующих компромиссов. Вот конкретные детали:
- Интеллектуальная маршрутизация промптов: динамически сопоставляет и распределяет входящие запросы между наиболее подходящими локальными или облачными моделями с учётом таких факторов, как сценарий использования, специализация в предметной области и стоимость токенов, — для оптимизации производительности.
- Ограничение использования и токенов: ограничение потребления и числа токенов на уровне пользователя помогает минимизировать расход токенов.
- Авторизация приложений: определяет приложение, отправившее запрос, до маршрутизации промпта. AI Gateway использует авторизацию на основе токенов OpenID Connect для применения политик доступа.
Secure Agent Framework
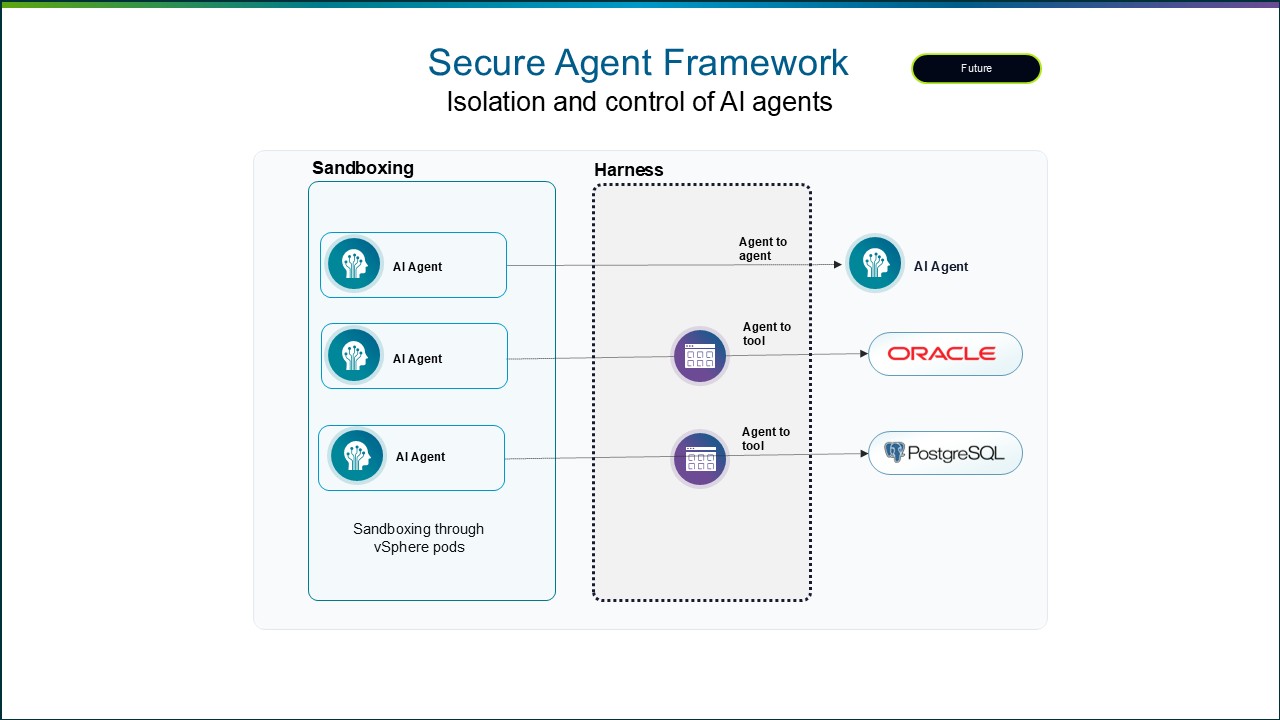
Автономные AI-агенты динамически генерируют и выполняют код, что без строгого контроля создаёт значительные риски безопасности. Бесконтрольный агент — не имеющий детерминированных ограничений на то, к чему он может обращаться, — способен случайно выполнить катастрофические команды, например удалить виртуальные машины или стереть локальные базы данных, как это продемонстрировали тестовые агенты нескольких облачных AI-провайдеров, вышедшие из-под контроля.
Будут выпущены две связанные возможности, обеспечивающие контроль и защитные механизмы для AI-агентов:
- Sandboxing: создаёт защищённое виртуализированное контейнерное пространство, в котором динамически сгенерированный агентом код изолируется и исполняется без влияния на остальную среду.
- Agent Harness: формирует уровень управления, определяющий, как вызываются агенты, к каким инструментам они имеют доступ, как они взаимодействуют друг с другом и как проверяются результаты их работы, прежде чем по ним будут предприняты действия.
Автоматическое масштабирование моделей
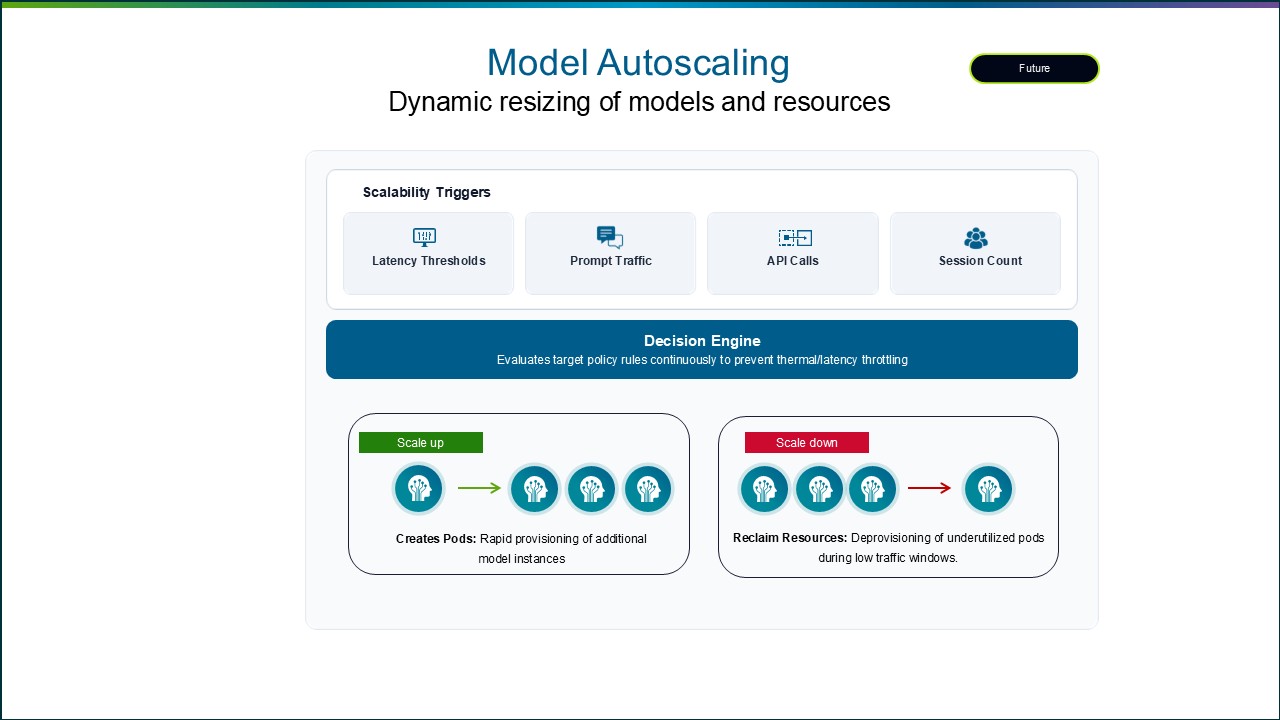
AI-нагрузки не умеют динамически реагировать на внезапные всплески запросов или агентные циклы. Для решения этой проблемы будет представлена возможность Model Autoscaling. С её помощью администратор или AI-оператор сможет задать пороговые значения по задержке и числу сессий, и при их достижении AI-модель будет масштабироваться автоматически, чтобы соблюдались SLA по задержке и производительности. Когда нагрузка опускается ниже порогового значения, рабочая нагрузка масштабируется в обратную сторону.
Благодаря этой возможности предприятия получат прирост производительности и снижение совокупной стоимости владения за счёт событийно-управляемого масштабирования, которое удерживает задержку по токенам на низком уровне, и смогут избежать избыточного выделения ресурсов GPU. Кроме того, организации смогут дополнительно оптимизировать вложения в AI за счёт более эффективного совместного использования дорогостоящих графических процессоров разными рабочими нагрузками.
Другие AI-новинки и анонсы с Explore
Поддержка Broadcom широкого спектра моделей в составе VCF
Стремительно развивающаяся область ИИ требует доступности разных моделей. Потребность в разнообразии AI-моделей вытекает из нескольких конкурирующих факторов: приватность, безопасность, управление, стоимость токенов, а также специализация и экспертиза в предметной области.
Broadcom намерена помогать предприятиям справляться с этими конкурирующими факторами, поддерживая как модели с открытыми весами, так и строго коммерческие решения. VMware AI Factory даёт предприятиям готовый к промышленной эксплуатации путь к запуску ведущих AI-моделей локально. Использование vLLM в качестве среды исполнения моделей по умолчанию позволяет заказчикам запускать на VCF более 150 моделей с открытым исходным кодом с оптимизацией по производительности. Broadcom объявила, что на работоспособность в VCF протестированы следующие модели:
- Nemotron 3: семейство открытых мультимодальных моделей NVIDIA Nemotron 3 обеспечивает ведущую точность и эффективность, помогая агентам быстрее выполнять задачи. Сочетание гибридной архитектуры Mamba-Transformer MoE, контекстного окна в один миллион токенов и обучения с подкреплением в нескольких средах позволяет Nemotron 3 поддерживать масштабируемые длительные агентные рабочие процессы в корпоративных приложениях.
- Gemma 4: новейшее семейство мультимодальных моделей Google DeepMind с открытым исходным кодом и открытыми весами, созданное специально для разработчиков и исследовательского сообщества, обеспечивающее локальное исполнение и позволяющее предприятиям создавать и разворачивать автономных AI-агентов.
- cotomi: проприетарная AI-модель компании NEC, оптимизированная для японского языка и обученная на тщательно отобранных, высоконадёжных наборах данных. Она сочетает высокую скорость обработки с повышением эффективности использования токенов на 40%.
- Qwen3.8-27B: разработанная Alibaba модель Qwen3.8-27B — плотная визуально-языковая модель с открытыми весами от команды Qwen. Она подходит для написания кода, профессиональных рабочих процессов, исследований, мультимодального взаимодействия и длительных агентных задач, а режим «размышления» в ней можно включать и отключать. Это нативно мультимодальная плотная модель на 27 млрд параметров, рассчитанная на эффективное локальное развёртывание и коммерческое использование.
- GLM 5.2: General Language Model с открытым исходным кодом от Z.ai (ранее Zhipu AI) позволяет предприятиям локально разворачивать агентов для написания кода и рассуждений в многошаговых автономных сценариях с соблюдением суверенитета данных и оптимальной производительностью оборудования.
VCF получила сертификацию NVIDIA: производительность AI-нагрузок подтверждена на уровне, близком к «голому железу»
Недавно NVIDIA запустила программу NVIDIA-Certified Hypervisors. Она удостоверяет, что участвующие в ней гипервизоры обеспечивают для AI- и HPC-нагрузок производительность, близкую к «голому железу».
VMware vSphere 9.1 (и все будущие релизы vSphere 9) получили сертификат NVIDIA-Certified Hypervisor. Таким образом, ИИ- и HPC-нагрузки на VCF теперь официально сертифицированы на работу с производительностью, близкой к «голому железу». Эта сертификация позволяет заказчикам уверенно использовать VCF в качестве оптимизированной по производительности платформы частного облака с поддержкой со стороны основных партнёров экосистемы — для обеспечения работы AI-приложений и приложений ускоренных вычислений в корпоративных центрах обработки данных. Более подробно об этом рассказано в недавно опубликованной статье.
Новые партнёры экосистемы VCF Private AI Services
Работа по укреплению корпоративной экосистемы ИИ продолжается. Помимо развития базовых функций, VCF Private AI Services расширяет охват за счёт новых стратегических альянсов. К числу новых партнёров относятся:
- Appian: Appian предоставляет AI-автоматизацию для критически важных задач, автоматизируя сложные процессы в крупных предприятиях и государственных структурах. Платформа Appian известна своей надёжностью и масштабируемостью, подкреплёнными более чем 25-летним опытом в области корпоративных операций. Документация по установке Appian на VCF доступна на этой странице.
- ClearML: ClearML предоставляет уровень оркестрации AI, управляющий доступом к GPU, моделями и агентами в рамках VMware Cloud Foundation. Это повышает утилизацию графических процессоров и снижает стоимость выполнения AI-нагрузок, давая предприятиям встроенный путь к модели AI-as-a-Service. Подробнее о ClearML можно узнать здесь.
- Eve Security: Eve обеспечивает управление, наблюдаемость и контроль времени исполнения, необходимые предприятиям для безопасного масштабирования AI-агентов. Её агент, встроенный в контур, автоматически проверяет высокорисковую или аномальную активность, обогащает решения контекстом из систем управления идентификацией, DLP и нижележащих систем, а при необходимости применяет средства контроля в реальном времени. Подробнее об Eve Security — здесь.
- Solo.io: Solo.io создаёт агентную инфраструктуру с открытым исходным кодом для предприятий, эксплуатирующих AI в продуктивной среде. Среда исполнения kagent и плоскость данных agentgateway дают платформенным командам возможность разворачивать AI-агентов и контролировать каждый вызов модели, инструмента и обращение агента к агенту — на инфраструктуре, которой они владеют и управляют. Дополнительные сведения о сотрудничестве Solo.io и Broadcom приведены в этой статье.
- TrueFoundry: TrueFoundry предоставляет AI Gateway корпоративного уровня, объединяющий LLM Gateway, MCP Gateway и Agent Gateway, что позволяет предприятиям подключать, наблюдать и контролировать агентные AI-приложения разных провайдеров из единой плоскости управления. Дополнительные подробности о TrueFoundry доступны здесь.
Читать далее... - читать дальше и комментировать
|
Недавно в Лас-Вегасе прошла конференция VMware Explore 2026 — со встречами с заказчиками и партнёрами, техническими сессиями и воркшопами. К мероприятию приурочен анонс общей доступности VMware Cloud Foundation (VCF) 9.1.1 — первого maintenance-релиза для ветки VCF 9.1.
Примечание: хотя для maintenance-релизов и экспресс-патчей (EP) жёсткая последовательность установки не задана, для релиза VCF 9.1.1 предусмотрено особое исключение — несколько компонентов необходимо обновлять в строго определённом порядке (соответствующие предварительные проверки уже встроены в релиз). В одном из будущих maintenance-релизов эти исключения будут сняты, но пока о них следует помнить.
- Fleet LCM необходимо обновить до 9.1.1 прежде, чем обновлять до 9.1.1 остальные компоненты VCF.
- VCFMS необходимо обновить до 9.1.1 прежде, чем обновлять до этой же версии Identity Broker и компонент Salt Master/RaaS.
- VCF Automation (VCFA) необходимо обновить до 9.1.1 прежде, чем обновлять компонент VCD Migrator.
Как maintenance-релиз он включает все накопленные исправления ошибок и обновления безопасности из ранее вышедших экспресс-патчей (EP), а также улучшения стабильности платформы и доработки, упрощающие переход на VCF 9.1.
Улучшений в этом релизе много, но ниже разобраны десять, которые заслуживают отдельного внимания.
1. Поддержка обновления с back-in-time релизов
После выхода VCF 9.1 было опубликовано несколько релизов vSphere и VMware Cloud Foundation (VCF), которые считались back-in-time релизами: прямого пути обновления до VCF 9.1 у них не было. С выходом VCF 9.1.1 для всех этих релизов появился поддерживаемый сценарий обновления.
| Исходная версия | 9.1.0 | 9.1.1 |
|---|
| VCF 9.0.2 EP02 (9.1.0.0200) | Нет | Да |
| VCF 5.2.4 | Нет | Да |
| vSphere 8.0 U3J-U3K | Нет | Да |
2. Поддержка актуальных версий компонентов VCF в VCF Download Tool (VCFDT)
Экспресс-патчи (EP) для компонентов VCF выходят всё чаще, и определить актуальные версии всех компонентов, необходимых для новой установки или обновления VCF, становится всё сложнее. VCF Download Tool (VCFDT) позволяет без труда узнать последнюю версию отдельного компонента, но с определением актуальных версий по всему программному стеку VCF всё обстояло не так просто.
В VCFDT 9.1.1 задачу упрощает новый флаг --latest: он автоматически отбирает необходимые компоненты VCF в их последних версиях с экспресс-патчами — как для сценария установки, так и для сценария обновления.
Команда для вывода списка последних бинарных файлов VCF 9.1.0, необходимых только для первоначальной установки:
vcf-download-tool binaries list --depot-download-token-file=/Users/lamw/vcf_download_token.txt --vcf-version=9.1.0 --sku=VCF --type=INSTALL --automated-install --latest

Команда для загрузки последних бинарных файлов VCF 9.1.0, необходимых только для первоначальной установки:
vcf-download-tool binaries download --depot-download-token-file=/Users/lamw/vcf_download_token.txt --depot-store=/Volumes/Storage/Software/VCF-LATEST --vcf-version=9.1.0 --sku=VCF --type=INSTALL --automated-install --latest
3. Поддержка OCI-артефактов, а также образов vSphere Supervisor, VKS и VKR в VCF Download Tool
Унифицированный VCF Software Depot представляет собой единый репозиторий, в котором хранятся все бинарные файлы, используемые развёртыванием VCF, — OVA, ZIP-архивы, PAK-файлы и артефакты в формате OCI. VCFDT остаётся основным инструментом взаимодействия с онлайновым VCF Software Depot: с его помощью загружают содержимое и создают офлайновый VCF Software Depot. Однако одно ограничение сохранялось — инструмент не умел работать с артефактами в формате OCI, включая vSphere Kubernetes Releases (VKR).
В VCF 9.1.1 в VCFDT появилась новая команда artifacts, которая упрощает загрузку сервисов vSphere Supervisor, включая vSphere Kubernetes Service (VKS), и, что особенно важно, релизов vSphere Kubernetes Releases (VKR). Новая команда позволяет выбрать, какие именно VKR нужно загрузить. Раньше подписка на онлайновую библиотеку контента VKR делала доступными для развёртывания сразу все релизы VKR, и у операторов платформы не было простого способа контролировать, какие из них используются.
В составе подкоманды artifacts появился также фильтр по категориям, который позволяет быстро отобрать конкретный тип бинарных файлов для просмотра или загрузки:
- SUPERVISOR — обновления управляющего уровня vSphere Supervisor
- VKS — обновления vSphere Kubernetes Service
- SUPERVISOR_SERVICE — обновления сервисов vSphere Supervisor
- VCF_CLI — VCF Consumption CLI и плагины к нему
- VCF_SERVICE — сервисы VCF, предоставляемые VCF Automation
- DSM — обновления Data Service Manager
Команда для вывода списка релизов VKR:
vcf-download-tool artifacts list --depot-download-activation-code-file=/Users/lamw/vcf_activation_code.txt --sku=VCF --vcf-version=9.1.0 --component=VKR

Команда для загрузки конкретного релиза VKR:
vcf-download-tool artifacts download --depot-download-activation-code-file=/Users/lamw/vcf_activation_code.txt --sku=VCF --vcf-version=9.1.0 --component=VKR --depot-store=/Volumes/Storage/Software/VKR --component-version=1.36.1+vmware.4-vkr.5
4. Уменьшенный ресурсный след VCF Management Services (VCFMS)
Когда в VCF 9.1.0 появился компонент VCF Management Services (VCFMS), размеры его виртуальных машин подбирались с расчётом на самый крупный из опциональных сервисов Day-N. Это снижало вероятность того, что при включении дополнительных сервисов потребуется переход на более крупную конфигурацию ВМ. Но в средах, где такие опциональные сервисы Day-N не разворачивались, часть виртуальных машин VCFMS оказывалась больше, чем необходимо.
В VCF 9.1.1 размеры VCFMS оптимизированы под первоначальное развёртывание Day-0. Кроме того, отдельные компоненты VCFMS были дополнительно перенастроены так, чтобы каждый сервис резервировал только те ресурсы, которые ему действительно требуются, — это повышает общую эффективность использования ресурсов. Например, при развёртывании Simple (без высокой доступности) теперь будет на один рабочий узел VCFMS меньше (12 vCPU / 24 ГБ памяти).

У тех, кто обновляет существующее развёртывание VCF 9.1 до версии 9.1.1, текущие размеры VCFMS останутся без изменений. При этом воспользоваться уменьшенным футпринтом VCFMS всё же можно — запустив после обновления скрипт перенастройки размеров, когда все компоненты VCFMS будут обновлены до 9.1.1.
5. Поддержка развёртывания Small HA для VCF Management Services (VCFMS) в VCF Installer
В VCF 9.1.0 конфигурация Small для VCFMS поддерживалась, но была доступна только в модели развёртывания Simple (без высокой доступности). В результате тем, кому требовалась высокая доступность управляющих узлов VCFMS, приходилось разворачивать следующий по размеру вариант VCFMS, обменивая дополнительное потребление ресурсов на повышенную доступность.
В VCF 9.1.1 для VCF Management Services (VCFMS) появился новый вариант развёртывания Small HA: высокой доступности можно добиться, не выходя за пределы ресурсов самой компактной конфигурации.

Если эта возможность используется через JSON API VCF Installer, в качестве значения размера развёртывания в секции vspClusterSpec, описывающей конфигурацию VCF Management Services (VCFMS), указывается small_ha.
Если VCF Fleet развёрнут в варианте Small без высокой доступности, масштабировать его до Small HA можно как операцию Day-N — через интерфейс VCF Operations в разделе Build > Lifecycle > VCF Management > Components > VCF Services Runtime, выбрав Action > Scale.
6. Поддержка HTTP и произвольного URL для офлайнового депо в интерфейсе VCF Installer
Возможность настроить офлайновый депозиторий VCF через HTTP-эндпоинт, включая поддержку произвольного пути в URL, появилась в API VCF Installer ещё в VMware Cloud Foundation (VCF) 9.1.0. Начиная с VCF 9.1.1 то же самое доступно непосредственно в интерфейсе VCF Installer: средам, которым не нужен HTTPS и/или которые используют собственный URL офлайнового депо, больше не требуется обращаться к API VCF Installer.

7. Поддержка дисков вне HCL vSAN ESA в интерфейсе VCF Installer
В лабораторных и пилотных развёртываниях доступ к NVMe-накопителям, сертифицированным для vSAN ESA, есть далеко не всегда. По умолчанию VCF Installer допускает использование с vSAN ESA только сертифицированных NVMe-устройств. Раньше это поведение можно было переопределить, добавив соответствующую настройку в VCF Installer. Начиная с VCF 9.1.1 поддержка несертифицированных NVMe-устройств с vSAN ESA встроена непосредственно в VCF Installer, и ручная настройка больше не нужна.

Важно: в продуктивных средах VVF и VCF с vSAN ESA поддерживаются только NVMe-устройства, перечисленные в Broadcom Compatibility Guide (BCG).
Для использования этой возможности через JSON API VCF Installer в секцию vsanSpec добавлено новое свойство skipHclAutoDiskClaim. Установка его в true включает то же поведение, что и в интерфейсе VCF Installer.
"datastoreSpec": {
    "vsanSpec": {
        "vsanDedup": false,
        "failuresToTolerate": 1,
        "esaConfig": {
            "enabled": true,
            "skipHclAutoDiskClaim": true
        },
        "datastoreName": "vsanDatastore",
        "encryptionConfig": {
            "dataInTransitConfig": {
                "enable": false
            }
        }
    }
}
8. Поддержка развёртывания на одном хосте ESX в интерфейсе VCF Installer
В лабораторных и пилотных средах с ограниченными аппаратными ресурсами выполнить минимальные требования к количеству хостов ESX удаётся не всегда. Хотя обходной путь через переопределение настройки доступен ещё с VCF 5.x, интерфейс VCF Installer всё равно требовал соблюдения минимального числа хостов и блокировал развёртывание даже при заданном переопределении. В результате развёртывание приходилось выполнять через Cloud Builder или JSON API VCF Installer.
Начиная с VCF 9.1.1 интерфейс VCF Installer учитывает такое переопределение, и подобные развёртывания можно выполнять прямо из UI. Для тех, кто только начинает знакомиться с VCF в лабораторных и пилотных средах, это заметно упрощает работу.

Важно: в продуктивных развёртываниях VVF и VCF поддерживается только официальная минимальная конфигурация хостов ESX.
9. Поддержка дисков вне HCL vSAN ESA в процедуре ввода хостов в эксплуатацию
При добавлении нового домена рабочей нагрузки VCF или расширении существующего, если в нём используется vSAN ESA, для ввода в эксплуатацию хостов ESX с несертифицированными NVMe-устройствами раньше требовалось дополнительное переопределение настроек. Продолжая линию на упрощение работы, заданную в VCF 9.1.1, ввод хостов ESX в эксплуатацию теперь выполняется прямо из интерфейса vCenter Server или SDDC Manager без этого дополнительного переопределения.

Прежде чем добавлять введённый в эксплуатацию хост ESX с несертифицированными NVMe-устройствами в кластер vSAN ESA, необходимо убедиться, что функция vSAN Managed Disk Claim отключена. По умолчанию она автоматически захватывает сертифицированные NVMe-устройства для использования с vSAN ESA. Несертифицированные устройства требуют ручной обработки, поэтому в противном случае операция будет заблокирована.

Важно: в продуктивных средах VVF и VCF с vSAN ESA поддерживаются только NVMe-устройства, перечисленные в Broadcom Compatibility Guide (BCG).
10. Поддержка VPC на базе VLAN без Overlay Tunnel Endpoint (TEP)
С появлением Distributed Transit Gateway (DTGW) для начала работы с Virtual Private Cloud (VPC) достаточно распределённой группы портов (DVPG) на базе VLAN, однако дополнительно всё равно приходилось настраивать overlay-сеть для Tunnel Endpoint (TEP) между хостами ESX. В VCF 9.1.1 у DTGW появился ещё один вариант — на базе VLAN и без необходимости настраивать сеть TEP на каждом хосте ESX, что сокращает объём конфигурации, требуемой для начала работы с VPC.

Примечание: новый вариант развёртывания VPC на базе VLAN полностью совместим с vSphere Kubernetes Service (VKS) и VCF Automation (VCFA), но имеет ряд ограничений. В их числе — отсутствие приватных подсетей VPC, сервисов SNAT/DNAT/VPN и поддержки протоколов, отличных от IP (например, VRRP и Multicast).
Источник. Читать далее... - читать дальше и комментировать
|
С выпуском VMware Cloud Foundation (VCF) 9.1.1 стали доступны новые возможности по эксплуатации инфраструктуры. За счёт расширения средств наблюдаемости, появившейся опции настроить диалогового AI-ассистента в помощь повседневным рабочим процессам, а также усиления безопасности VCF 9.1.1 помогает ИТ-командам быстрее устранять неполадки и масштабировать инфраструктуру.
По мере роста инфраструктуры частного облака перед командами эксплуатации встаёт сразу несколько препятствий: управление смешанными средами из виртуальных машин (VM), контейнеров и Kubernetes, поддержание безопасности в масштабах всего парка систем и удержание среднего времени устранения инцидента (MTTR) на низком уровне. Компонент VMware Cloud Foundation Operations в составе VCF 9.1.1 предоставляет операции с использованием искусственного интеллекта, сквозную наблюдаемость Kubernetes на всех уровнях стека и расширенные средства обеспечения безопасности. Ниже приведены подробности о новых возможностях, доступных в VCF Operations в релизе VCF 9.1.1.
AI Assistant for VCF
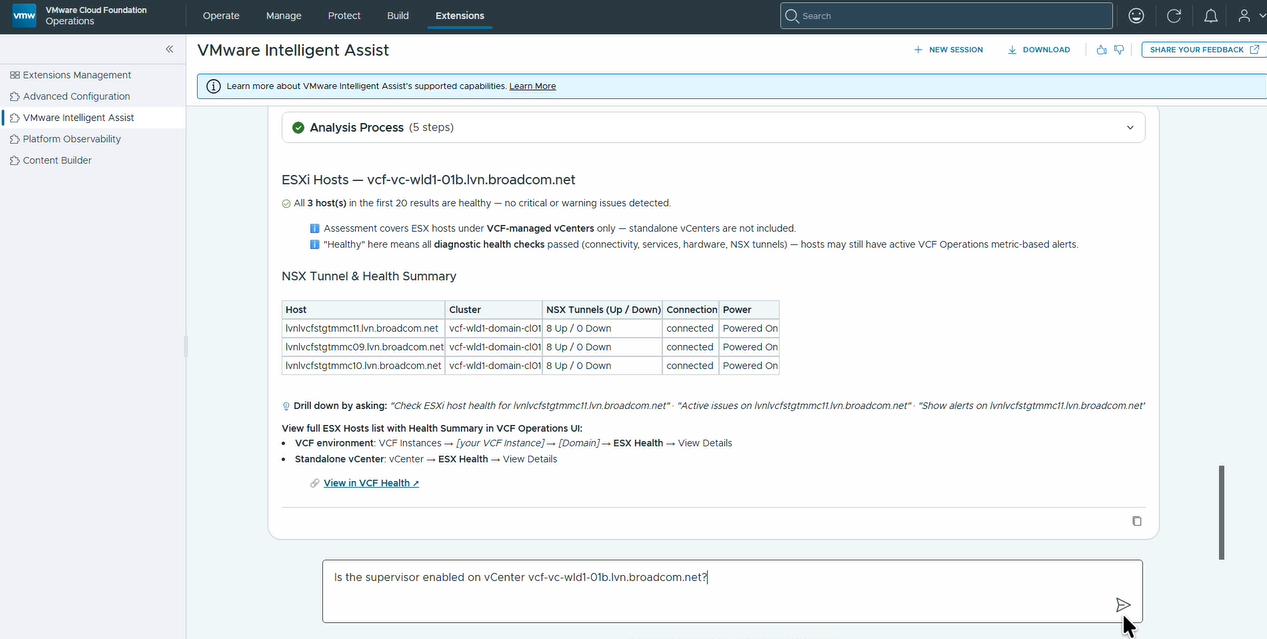
Рисунок 1. Функция AI Assistant for VCF упрощает операции Day-2 за счёт диалогового поиска неисправностей и диагностики.
В VCF 9.1.1 появилась функция, которая даёт возможность встроить диалоговый AI-интерфейс непосредственно в пользовательский интерфейс VCF Operations, настроив его локально с выбранной моделью. Эта функция изначально поддерживает различные большие языковые модели (LLM), работающие на Private AI Services (PAIS), либо частный экземпляр Google Gemini. Требуется ли администратору помощь в поиске причин проблем инфраструктуры или в управлении сторонними интеграциями — функция AI Assistant for VCF способна содержательно и безопасно помогать в эксплуатации частного облака.
Диалоговая диагностика. Функция AI Assistant for VCF даёт администраторам любого уровня подготовки возможность управлять средами частного облака с помощью простых запросов на английском языке.
Интеллектуальная видимость состояния. Функция AI Assistant for VCF также может помочь администратору в устранении проблем с работоспособностью VCF. Новые возможности обеспечивают диагностическую видимость для VMware vSphere и служб управления VCF. Администраторы могут сопоставлять проактивные оповещения о состоянии, конфигурацию и журналы.
Конструктор пакетов управления. Администраторы, использующие функцию AI Assistant for VCF, могут повысить видимость сторонней инфраструктуры, чтобы быстрее находить первопричины сбоев. Возросшая видимость помогает выстраивать связи между VCF и смежными валидированными средами и тем самым снижать взаимные обвинения между поставщиками при возникновении проблем. Кроме того, администраторы могут создавать пакеты управления с помощью искусственного интеллекта, не обладая экспертизой в области API.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026:
From Tokens to Traces: AI Observability in VMware Cloud Foundation Operations [CLOB1168LV]
Сквозная видимость и наблюдаемость Kubernetes
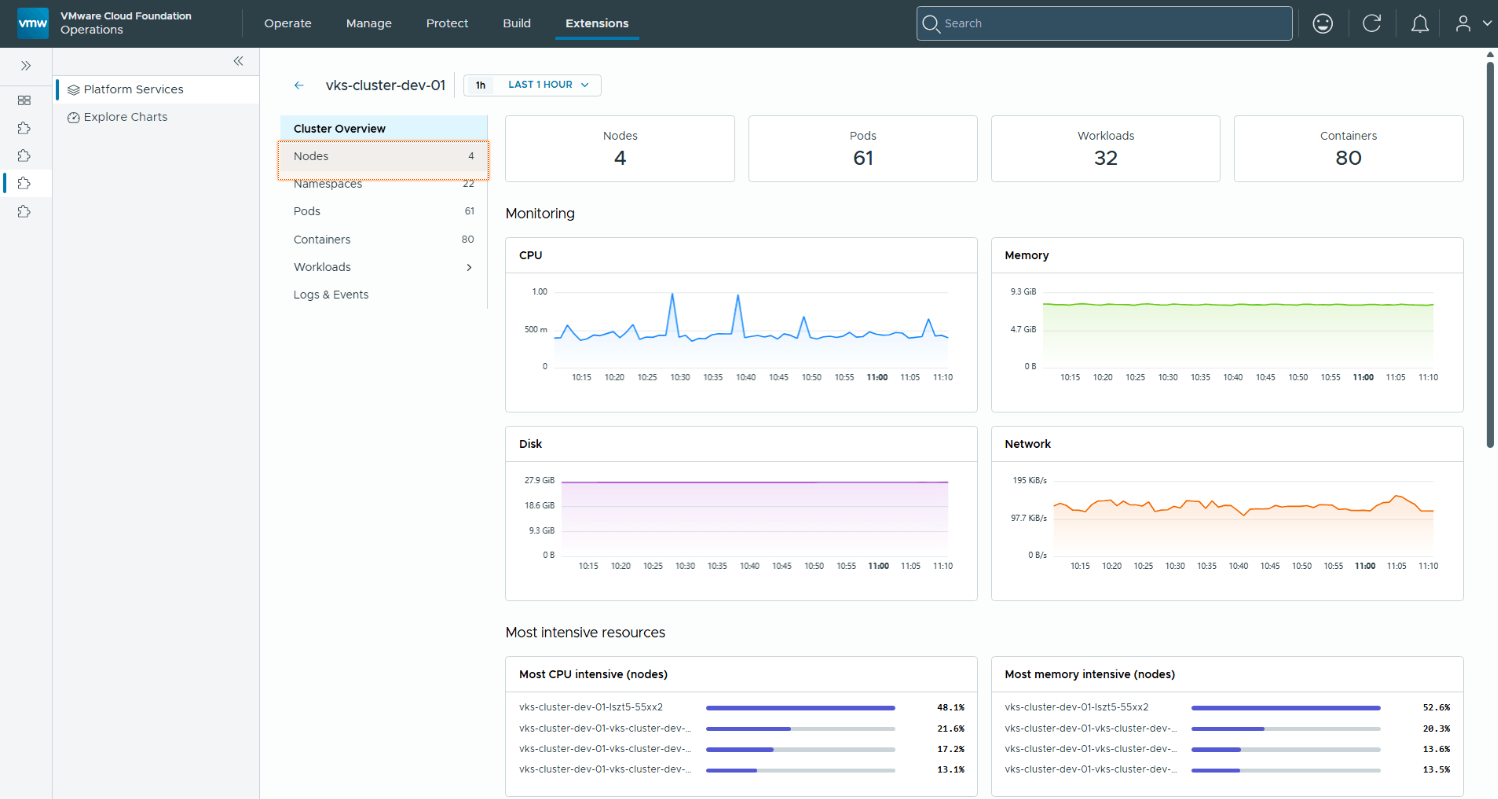
Рисунок 2. VCF Operations обеспечивает наблюдаемость VKS и поиск неисправностей в реальном времени.
Поскольку контейнеры быстро масштабируются и так же быстро завершают работу, традиционный опрос инфраструктуры оставляет слепые зоны. VCF 9.1.1 обеспечивает выполнение операций Kubernetes в реальном времени в рамках управления инфраструктурой.
Наблюдаемость VMware vSphere Kubernetes Service (VKS). Администраторы могут сопоставлять метрики вычислительных ресурсов, сети и хранилища, получаемые в реальном времени, с системными журналами и событиями, чтобы быстро изолировать первопричины. Стандартные пятиминутные интервалы опроса теперь можно сократить до секунд. В VCF Operations появилась потоковая передача метрик в реальном времени с интервалом 2 секунды для кластеров VKS. Используя стандарт OpenTelemetry, команды могут оперативно обнаруживать короткоживущие поды, всплески потребления памяти и кратковременные узкие места производительности.
Мониторинг нескольких кластеров VKS. Администраторы получают централизованную видимость всех кластеров Kubernetes благодаря автоматизированному сбору данных OpenTelemetry без написания кода.
Импорт дашбордов Grafana. Администраторы могут беспрепятственно импортировать существующие дашборды Grafana или дашборды из библиотеки сообщества Grafana, чтобы отслеживать рабочие нагрузки Kubernetes из VCF Operations и одновременно просматривать нативные дашборды VKS.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026.
Kubernetes Observability for Platform Operators: VMware vSphere Kubernetes Service and Application Services [CLOB1167LV]
Расширенные средства безопасности и управления идентификацией
Управление доступом, учётными данными и соответствием требованиям в больших масштабах требует бесшовного централизованного контроля.
- Динамическое управление идентификацией по запросу. При настройке единого входа (SSO) для доступа к различным компонентам VCF необходимость в предварительно созданных учётных записях пользователей осталась в прошлом. VCF 9.1.1 поддерживает запросы к Active Directory и OpenLDAP (Lightweight Directory Access Protocol) в реальном времени. Членство пользователя в группах вычисляется динамически ровно в момент входа в систему, что упрощает выдачу временного группового доступа и обеспечивает соответствие прав текущему состоянию каталога.
- Упрощённое управление паролями. VCF Operations выступает единой точкой для управления парольными политиками и их применения в рамках всего парка систем. Применять парольные политики стало проще, поскольку в рабочем процессе доступно больше компонентов. Администраторы могут отслеживать актуальность учётных данных по компонентам, включая теперь и учётные записи приложений для VMware vCenter, VMware Cloud Foundation Automation, средств управления парком VMware Cloud Foundation Operations и коллекторов VMware Cloud Foundation Operations for Networks.
- Расширенное управление сертификатами. Управление жизненным циклом сертификатов теперь охватывает NSX Edges, супервизоры VMware vSphere, серверы лицензирования, cloud proxy для VCF Operations и коллекторы VCF Operations for Networks. Система обеспечивает непрерывное отслеживание сроков истечения, автоматические оповещения о сбоях автоматического обновления и интеграцию со сторонними удостоверяющими центрами (CA). Также реализована поддержка сертификатов, не относящихся к TLS. Эта возможность даёт расширенную видимость компонентов VCF и помогает свести к минимуму перебои во взаимодействии настроенных компонентов при истечении срока действия сторонних сертификатов. С помощью VCF Operations администраторы могут заменять самоподписанные сертификаты на сертификаты, выпущенные удостоверяющим центром.
- VMware Salt for VCF Component APIs. Новые для VCF интерфейсы VMware Salt for VCF Component APIs построены на базе VMware Salt и дают командам всесторонний программный контроль над управлением конфигурациями. Опираясь на нативные конструкции Salt, эта новая возможность задействует целый ряд встроенных параметров конфигурации, которые единообразно работают во всём VCF. Более 300 доступных настроек позволяют администраторам поддерживать согласованное операционное состояние всего стека.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026:
What’s New in VMware Cloud Foundation Operations [CLOT1139LV]
Гибкость развёртывания и масштабирование
Компактный форм-фактор. Для организаций, которым нужно развернуть частное облако меньшего размера, в VCF 9.1.1 предложен новый компактный форм-фактор, сокращающий требования к процессорным ресурсам и памяти до 40%. Он включает конфигурацию из двух узлов для обеспечения высокой доступности. Кроме того, такая упрощённая архитектура позволяет импортировать в VCF существующие экземпляры VMware vCenter из brownfield-сред без перенастройки сетевых портгрупп.
Поддержка IPv6 на сервере лицензирования. Развёртывание современного частного облака можно ускорить благодаря нативной поддержке IPv6 в сервере лицензирования. В этот релиз также вошли дашборды состояния лицензирования и оповещения о лицензировании в VCF Operations.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026:
Lifecycle Management in VMware Cloud Foundation 9.1 for VMware vSphere Admins [CLOB1568LV]
Итог
Компонент VCF Operations в составе VCF 9.1.1 приносит наблюдаемость Kubernetes на базе OpenTelemetry, управление идентификацией в масштабах всего парка систем и автоматизацию работы с сертификатами. Встроенный AI-ассистент помогает эффективно строить, обслуживать, эксплуатировать и защищать частное облако, а гибкая интеграция с LLM сохраняет суверенитет данных. Полное описание новых возможностей VCF Operations приведено в документации Broadcom и заметках о выпуске. Читать далее... - читать дальше и комментировать
|
Разработчик отечественной observability-платформы Proto перешёл под контроль «Базиса». Proto Observability Platform в России рассматривают как импортонезависимую замену американской Dynatrace.
Условия сделки
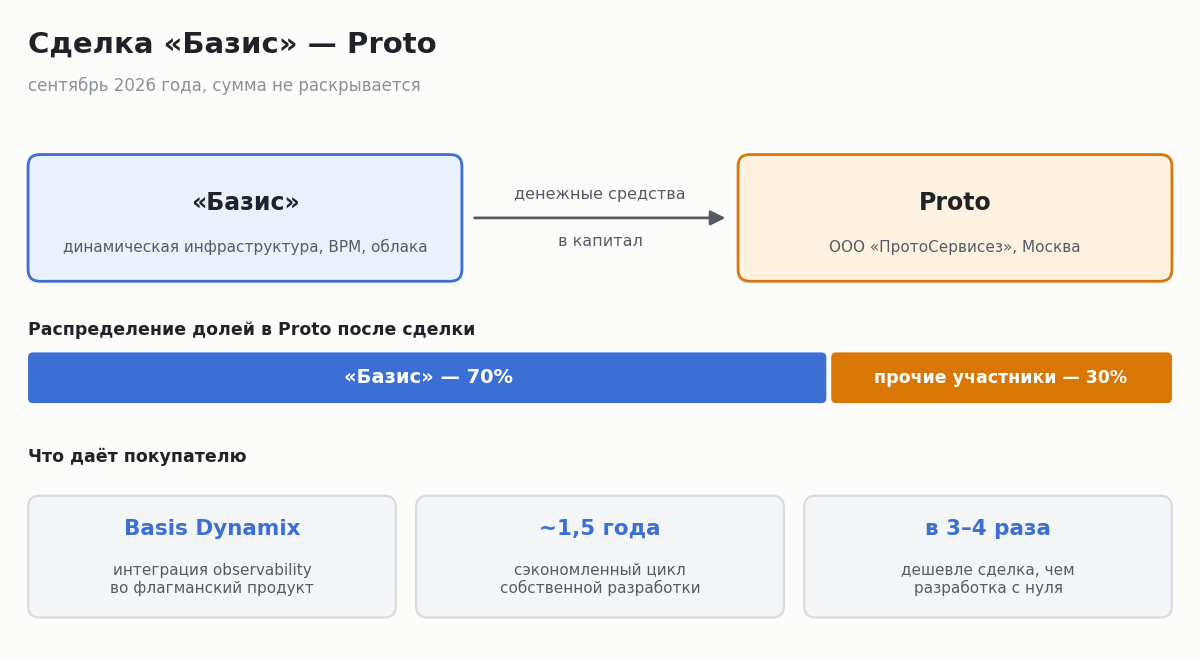
«Базис», поставляющий решения для динамической инфраструктуры, виртуальных рабочих мест и облачных сервисов, забрал себе Proto — команду, которая делает платформу наблюдаемости и аналитики операционных данных на базе искусственного интеллекта. Покупателю досталась доля в 70%. Оформлено приобретение через внесение денег в капитал Proto, и эти средства пойдут на доработку AI-платформы и её встраивание в экосистему «Базиса». Сумму и прочие параметры стороны раскрывать не стали.
Смысл покупки для «Базиса» двоякий: усилить собственное предложение в сегменте серверной виртуализации и обзавестись внутренним центром компетенций по мониторингу. Proto войдёт в структуру группы на правах дочерней компании, а её коллектив обещают не только сохранить, но и нарастить.

Сегодня платформы наблюдаемости и аналитики операционных данных становятся важной частью современной ИТ-архитектуры. По мере роста распределённых систем, контейнерных сред и облачных платформ заказчикам уже недостаточно мониторинга отдельных компонентов, им необходима сквозная видимость инфраструктуры, приложений и связанных с ними бизнес-процессов в едином контуре. Именно поэтому мы рассматриваем приобретение Proto как стратегически значимое для дальнейшего развития экосистемы «Базиса», — прокомментировал сделку генеральный директор «Базиса» Давид Мартиросов.
Сама Proto видит в новом владельце сильного союзника — с солидным запасом ресурсов и широкой клиентской базой.
Партнерство с таким игроком позволяет нам быстрее реализовать наше видение развития Proto и масштабировать продукт вместе с одной из ведущих российских ИТ-компаний, — отметил генеральный директор и сооснователь Proto Денис Безкоровайный.
Что умеет Proto Observability Platform
Класс observability-решений нужен для того, чтобы разобраться в происходящем с объектом наблюдения на глубинном уровне. Достигается это за счёт сбора метрик, журналов и трассировок — собранные данные систематизируются, анализируются и позволяют вычленить проблемные участки.
В Proto Observability Platform встроены средства анализа, работающие на машинном обучении. AI-модуль пропускает через себя метрики, логи, трейсы и события инфраструктуры, вычисляет первопричину инцидента и оформляет рекомендации в том виде, который понятен инженеру. Кроме того, он сопоставляет между собой телеметрию, подсказывает вероятные источники сбоев и тем самым сокращает время разбора происшествий.
Расчёт покупателя
Интерес «Базиса» сосредоточен именно на технологиях Proto: их предстоит встроить в собственную программную экосистему. Такой путь избавляет компанию от расходов на создание аналогичной по возможностям разработки с чистого листа.
Приобретение Proto позволило сократить цикл самостоятельной разработки технологий наблюдаемости примерно на полтора года. По внутренней оценке, создание собственного продукта обошлось бы компании в три-четыре раза дороже M&A-сделки, без учета возможного роста себестоимости разработки в будущем, — заявил Давид Мартиросов.
Технологии Proto планируется перенести во флагманские продукты вендора, и прежде всего в Basis Dynamix — платформу виртуализации серверов и контейнеров. За счёт этого заказчики получат предиктивную аналитику состояния ИТ-инфраструктуры и прогнозирование инцидентов средствами искусственного интеллекта. Тем, кто инфраструктурными продуктами «Базиса» не пользуется, оставят возможность настраивать платформу самостоятельно.
Профиль Proto
Proto — российская компания, специализирующаяся на мониторинге и поддержании стабильности цифровых сервисов. В этой области она работает свыше 12 лет, занимаясь в том числе контролем производительности высоконагруженных систем и отслеживанием киберугроз.
На домашнем рынке компании противостоят «Ключ-Астром», Monq, Volgablob, Gmonit и Sage. Если смотреть шире, зарубежными аналогами продукта выступают Dynatrace, Instana Observability, Datadog и New Relic.
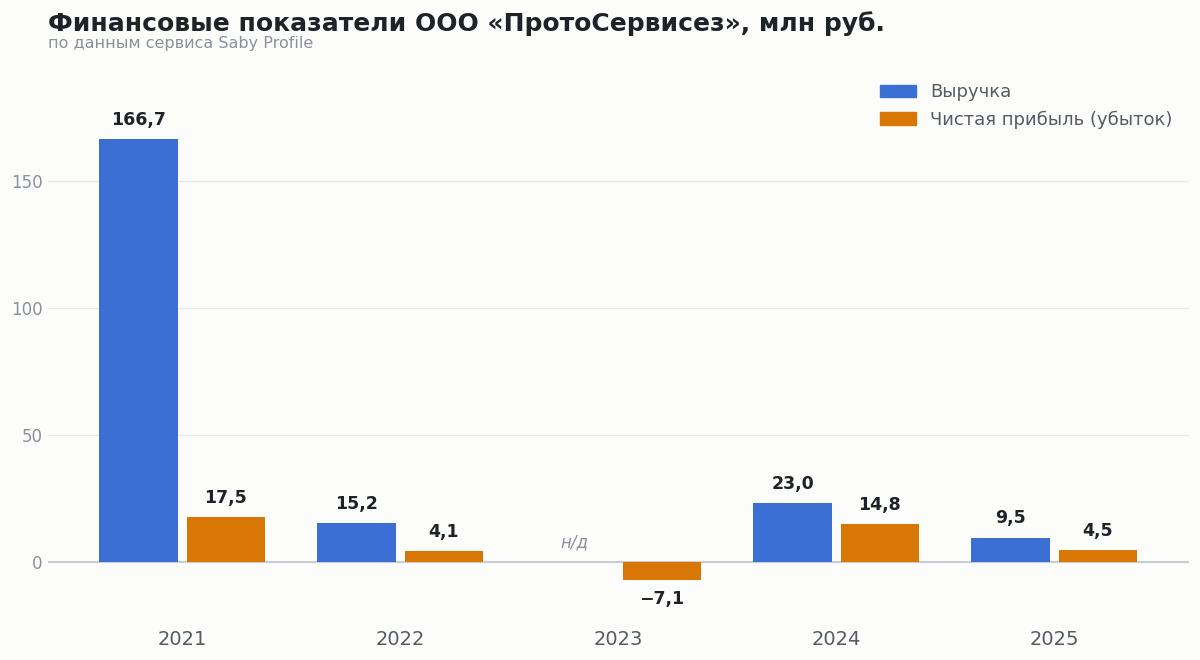
Юридическое лицо — ООО «ПротоСервисез» — зарегистрировано в Москве в мае 2014 г. Уставный капитал составляет 25 тыс. руб. и поделён поровну между Надеждой Борисовной Фердман и Денисом Игоревичем Безкоровайным; последний занимает пост генерального директора. За 2025 г. выручка ООО «ПротоСервисез» составила 9,5 млн руб. при чистой прибыли 4,5 млн руб. Годом ранее показатели были заметно выше: 23 млн руб. доходов и 14,8 млн руб. прибыли.
Рекордным для компании остаётся 2021 г. — тогда выручка достигла 166,7 млн руб., а чистая прибыль — 17,5 млн руб. Уже в 2022 г. доходы просели примерно в десять раз, до 15,2 млн руб., прибыль опустилась до 4,1 млн руб., а 2023 г. и вовсе завершился убытком в 7,1 млн руб.
Одноимённую платформу Proto Observability Platform компания представила рынку в 2022 г. Продукт предназначен для сквозного контроля бизнес-систем, приложений, пользовательского опыта и ИТ-инфраструктуры. В Единый реестр отечественного ПО Минцифры России его внесли в начале августа 2022 г.
Чем известен «Базис»
Выручка «Базиса» по итогам 2025 г. прибавила 37% и достигла 6,3 млрд руб. Показатель OIBDA составил 3,84 млрд руб., чистая прибыль в годовом сопоставлении выросла на 8,6%, до 2,22 млрд руб. В декабре 2025 г. компания вышла на биржу с IPO.
Платформа Basis Dynamix Enterprise возглавила рейтинг российских платформ виртуализации CNewsMarket 2026. Для флагманского продукта вендора это третья победа кряду: он набрал 695 баллов и оторвался от ближайшего преследователя на 25 баллов. Двумя годами ранее, в 2024 г., «Базис» забрал себе «Рустэк» — на тот момент одного из лидеров отечественного рынка средств виртуализации. Разработка «Рустэка» ещё в 2023 г. занимала первую строчку среди российских платформ по версии CNews.
В мае 2026 г. материнская структура «Базиса» — «РТК-ЦОД», компания «СкайФолл Лабс» (SkyFLabs) и Proto подписали соглашение о технологическом партнёрстве. Партнёры договорились строить общую платформу управления ИТ-инфраструктурой и сервисами, которая сведёт воедино инструменты ITSM/ESM, ITAM, мониторинга, наблюдаемости, автоматизации и сервисного взаимодействия. Читать далее... - читать дальше и комментировать
|
Вслед за успешно прошедшей конференцией VMware Explore в Лас-Вегасе и майским запуском VMware Cloud Foundation (VCF) 9.1 объявлено о переходе в стадию общей доступности версии VCF 9.1.1. Этот релиз развивает возможности VCF 9.1 и приносит усиленную защиту, объектное хранилище vSAN Object Storage (в статусе технического превью, о чём сообщалось ранее), а также новые функции, призванные сделать частное облако лучшей площадкой для запуска AI-нагрузок, управления ими и их защиты — при одновременном снижении совокупной стоимости владения (TCO) и операционной сложности.
Рассмотрим, что нового появилось в этой версии.
Multi-Tenant Model Sharing: безопасное совместное использование AI-моделей
По мере того как организации разворачивают всё больше моделей AI в разных бизнес-подразделениях, они сталкиваются с хорошо знакомым противоречием: команды хотят самостоятельно и без ограничений использовать модели, тогда как MLOps-специалисты и платформенные инженеры обязаны обеспечивать конфиденциальность данных и соблюдение регламентов. Поддержка отдельного стека моделей для каждого тенанта увеличивает затраты и порождает разрастание инфраструктуры.
Механизм Multi-Tenant Model Sharing решает эту задачу, позволяя безопасно делиться моделями между тенантами или отдельными направлениями бизнеса с сохранением конфиденциальности данных. Команды получают доступ к общим моделям без раскрытия чувствительных обучающих данных и без необходимости создавать изолированные инфраструктурные «острова».
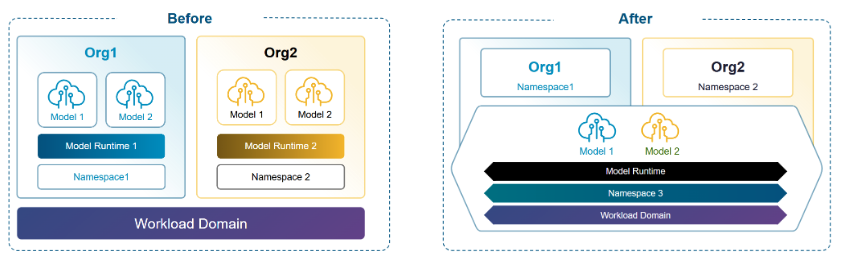
Рисунок 1: Multi-Tenant Model Sharing в VMware Cloud Foundation
К операционным преимуществам такого подхода относятся:
- Снижение TCO за счёт общей инфраструктуры моделей вместо дублирующих развёртываний для каждого тенанта.
- Упрощение операционной сложности благодаря единой плоскости управления доступом к моделям и политиками.
- Сохранение конфиденциальности данных за счёт изолированных по тенантам средств контроля доступа.
Именно так выглядит платформа, изначально спроектированная под AI, а не дополненная соответствующими функциями постфактум.
AI Assistant for VCF: диагностика и конструктор management packs
Инфраструктурные команды тратят значительное время на анализ первопричин сбоев и на поиск проблем в смежной инфраструктуре. По мере роста среды до сотен хостов и кластеров Kubernetes эти трудозатраты только накапливаются.
Помощник AI Assistant for VCF берёт на себя диагностику и построение пакетов управления (management packs). Диагностика на базе AI сокращает среднее время устранения неисправностей (MTTR), помогая командам быстрее выявлять первопричины. С помощью AI пользователи могут разбирать инциденты — например, конкуренцию за ресурсы процессора и память на ESX или иные диагностические аномалии — не обладая узкоспециализированными навыками. Другой пример работы помощника при устранении неполадок — совместный анализ множества ошибок vMotion, позволяющий точно определить, почему миграция vMotion даёт сбой в рамках всей среды vCenter.
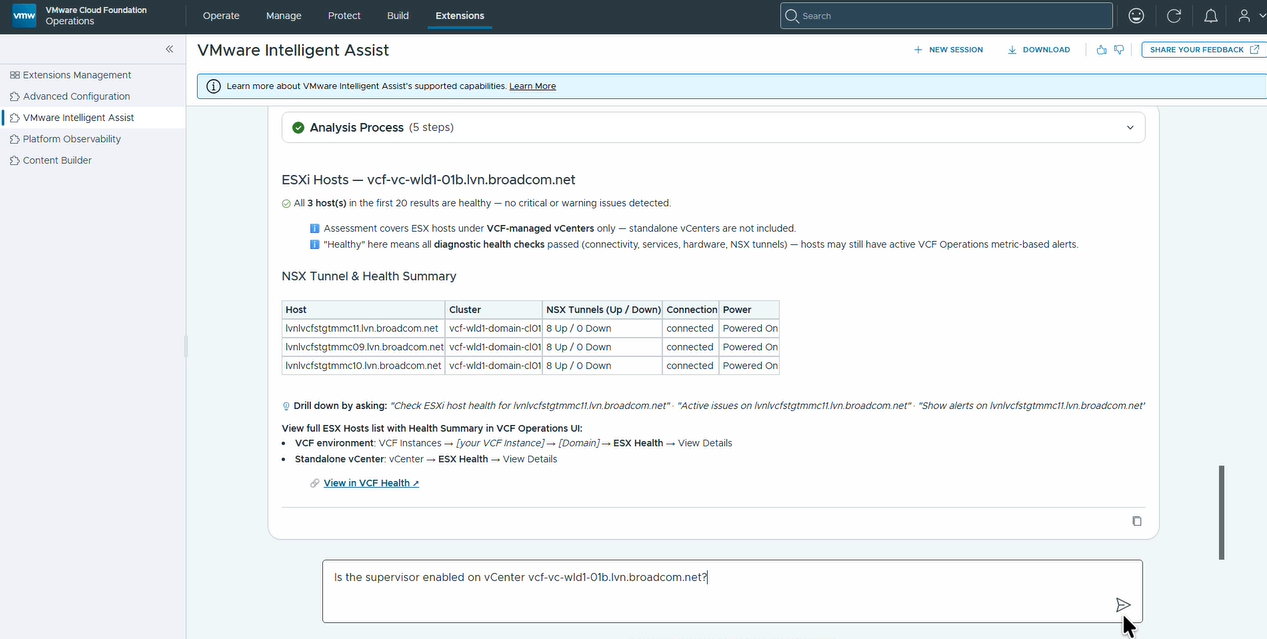
AI Assistant for VCF также помогает заказчикам создавать интеграции со сторонними продуктами: конструктор контента задействует API для формирования management packs и content packs, которые в противном случае пришлось бы готовить вручную.
Сочетание диагностики на основе AI с более глубокой видимостью сторонних систем позволяет современным частным облакам устранять операционные узкие места, благодаря чему инфраструктурные команды работают на опережение, а не в режиме реагирования на инциденты.
Новый сервис GitOps [техническое превью]: Argo CD внутри VCF
Команды платформенного инжиниринга всё активнее опираются на GitOps для автоматизации развёртывания и управления жизненным циклом. Однако интеграция инструментов GitOps исторически означала работу за пределами управляющей среды VCF, что добавляло сложности в цепочку инструментов и размывало зоны ответственности при поддержке.
Новый GitOps Service (выпущен в статусе технического превью) добавляет Argo CD в качестве нативного GitOps-сервиса в рамках сервисной управляющей среды VCF. Это объединяет развёртывание и управление жизненным циклом непосредственно в интерфейсе VCF Automation, перенося процессы GitOps в ту же операционную плоскость, где находится остальная инфраструктура. Сокращая разрастание инструментария, команды повышают операционную эффективность и отдачу от вложений. Кроме того, сервис GitOps защищает доступ к конвейерам с помощью аутентификации OIDC, интегрированной с VCF Automation.
Командам платформенного инжиниринга предлагается ранний доступ в формате технического превью — чтобы вместе с ними дорабатывать функциональность под масштабы реальных платформенных команд.
По мере роста сред частного облака растёт и сетевая сложность. Сетевые команды сталкиваются с трудоёмкой настройкой, ограничениями производительности и связанными с этим сложностями при диагностике.
Архитектурные улучшения EVPN: проще и масштабируемее
В VCF 9.1.1 появились важные архитектурные улучшения EVPN, включая оптимизированный путь передачи данных между транзитными шлюзами VCF и физической фабрикой для трафика «восток - запад». Прямые туннели VXLAN между транзитным шлюзом и коммутаторами уровня leaf оптимизируют производительность датаплейна для трафика «восток - запад». Помимо этого, сетевые сервисы — NAT, балансировка нагрузки NSX, балансировка нагрузки AVI и DHCP relay — теперь доступны в режиме распределённой связности EVPN VXLAN. В совокупности эти улучшения обеспечивают критически важную мультитенантную и внешнюю связность, а также дают более высокую производительность, более простую конфигурацию и упрощённую диагностику сред EVPN.
Улучшенная совместимость с физической фабрикой означает, что сетевые команды могут проектировать и эксплуатировать более крупные и гибкие сети частного облака без той сложности, которая традиционно замедляла их работу.
Add-on Management Framework в VMware vSphere Kubernetes Service 3.7: уверенность при масштабировании
По мере роста сред Kubernetes разрастается и экосистема дополнительных инструментов — сетевых, средств наблюдаемости, безопасности, хранения данных. Основные трудности проявляются на этапе Day 2: управление жизненным циклом дополнений и устранение возникающих проблем. Ситуацию усугубляет неясность в зонах ответственности за поддержку - непонятно, к кому обращаться, когда что-то ломается. Механизм Add-on Management Framework в vSphere Kubernetes Service (VKS) 3.7 обеспечивает предсказуемую поддержку с прозрачным распределением ответственности и даёт заказчикам свободу выбора при внедрении экосистемных инструментов. Чёткие маршруты поддержки на каждом уровне сокращают время до решения проблемы, давая командам уверенность при масштабировании и скорость для внедрения инноваций.
Следующий шаг
Версия VCF 9.1.1 уже доступна. Для тех, кто уже эксплуатирует VCF 9.1, этот релиз продолжает линию регулярных обновлений с усилением безопасности, удерживающих частное облако на переднем крае AI-инфраструктуры. Для тех, кто пока только оценивает VCF, сейчас лучшее время для перехода.
Дополнительные материалы:
Читать далее... - читать дальше и комментировать
|
Передовой искусственный интеллект (frontier AI) коренным образом меняет ландшафт кибербезопасности: он повышает скорость, масштаб и изощрённость атак и одновременно сжимает окно, за которое защита успевает отреагировать. Такие ускоренные векторы атак требуют проактивной защитной позиции. Заказчикам помогают ориентироваться в новом ландшафте угроз с помощью стратегических рекомендаций, изложенных в этом материале.
Усиление защиты частного облака остаётся критически важной задачей, однако из-за внутренней сложности уникальных пользовательских сред универсальные сценарии действий оказываются неэффективными. Понимание текущего положения дел и выявление критических пробелов необходимы, чтобы расставить приоритеты среди наиболее результативных практик, особенно для ИТ-команд, работающих в условиях жёсткого дефицита времени.
Сегодня по всему миру запускается программа Frontier AI Security Readiness Program, которая предлагает заказчикам направляемую, предписывающую и адаптированную траекторию движения к более устойчивому частному облаку. Эффективная защита от угроз, управляемых AI, требует сквозного, целостного подхода к безопасности, а не разрозненных фрагментарных решений.
Программа объединяет комплексную методологию, состоящую из четырёх взаимосвязанных этапов:
- Assess (оценка): количественно измерить экспозицию и пробелы в защитной позиции, чтобы получить базовую линию, основанную на данных.
- Architect (проектирование): определить целевое состояние, объединив результаты анализа пробелов с проверенными блупринтами по пяти разрезам.
- Implement (внедрение): развернуть усиленные конфигурации, опираясь на бесшовное обновление, непрерывный мониторинг и сортировку инцидентов с помощью AI.
- Upskill (повышение квалификации): развить компетенции организации за счёт специализированных учебных курсов по VMware Cloud Foundation (VCF) 9.1 и будущей сертификации AI Resilient Infrastructure Expert (ARIE).
В эпоху передового AI автономные угрозы эксплуатируют задержки с установкой обновлений и нехватку квалификации персонала на машинной скорости. Объединяя технологии, автоматизацию и развитие кадров, эта методология обеспечивает четыре стратегических результата: построение устойчивого частного облака, минимизацию поверхности атаки, быстрое реагирование на уязвимости и поддержание адаптивной позиции безопасности.
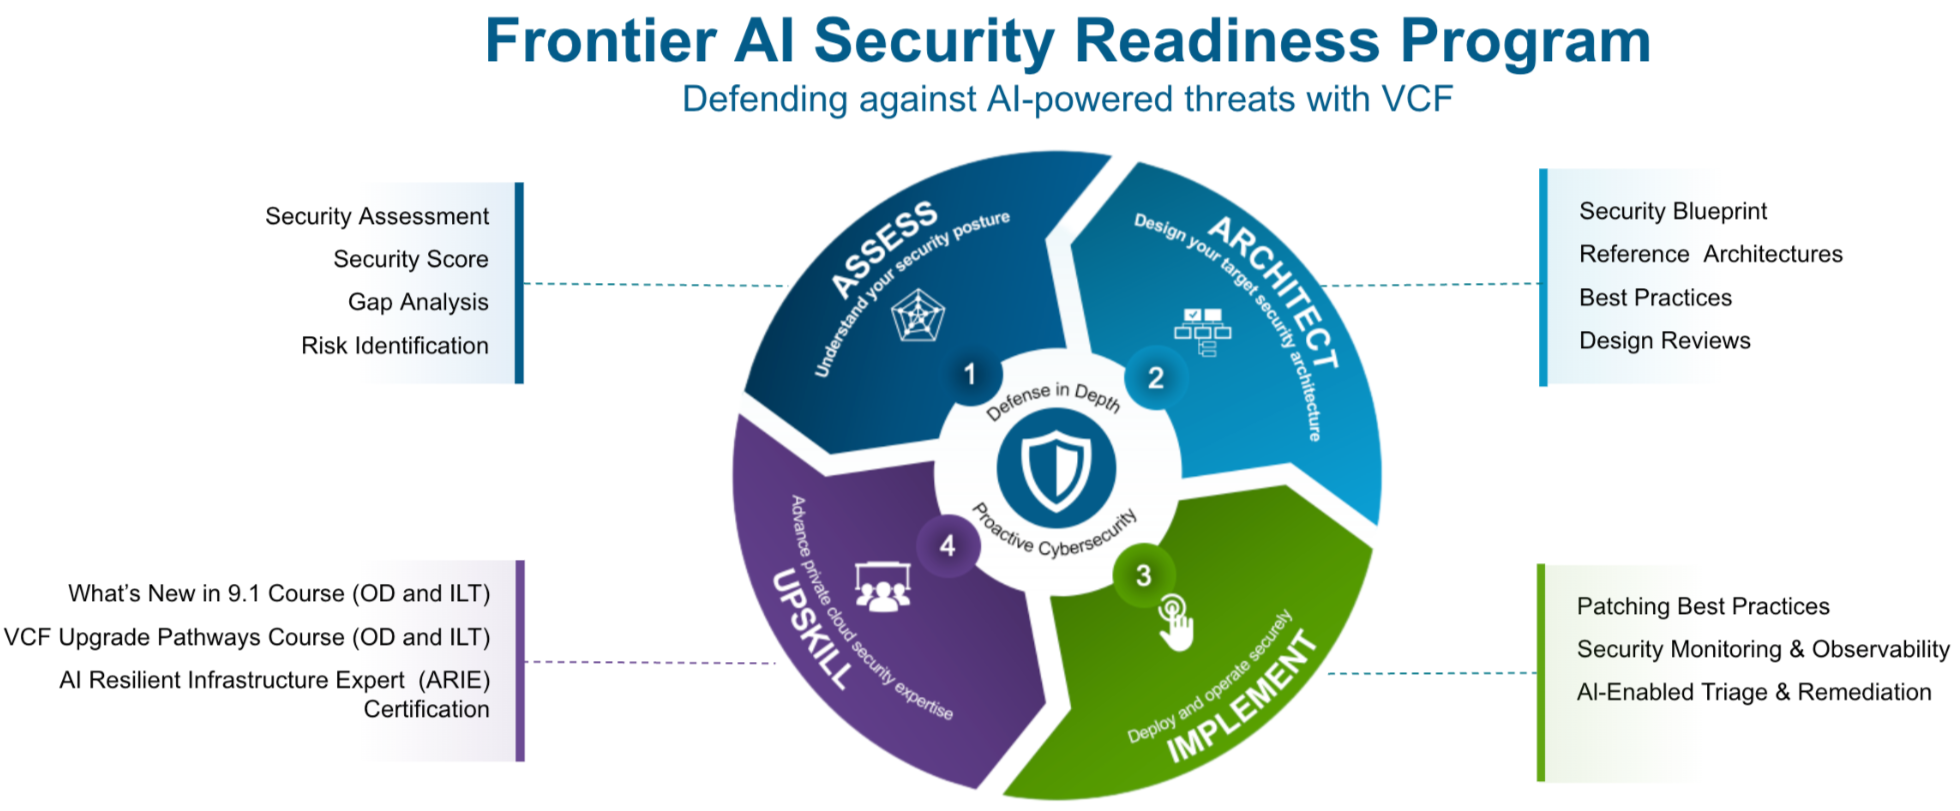
Подать заявку на участие в программе Frontier AI Security Readiness можно по ссылке, также рекомендуется обратиться к своей команде по работе с клиентами: https://go-vmware.broadcom.com/frontier-ai-security-readiness-program
Ниже разобран каждый из четырёх этапов программы.
Этап Assess
Чтобы построить устойчивое частное облако, первым фундаментальным шагом программы безопасности становится оценка, поскольку нельзя защищать то, что не измерено. Веб-инструмент VCF Security Assessment даёт объективную, основанную на баллах видимость защитной позиции по всему стеку, применяя риск-ориентированную систему оценок, чтобы приоритизировать значимые продуктивные среды и DMZ над менее критичными лабораторными нагрузками.
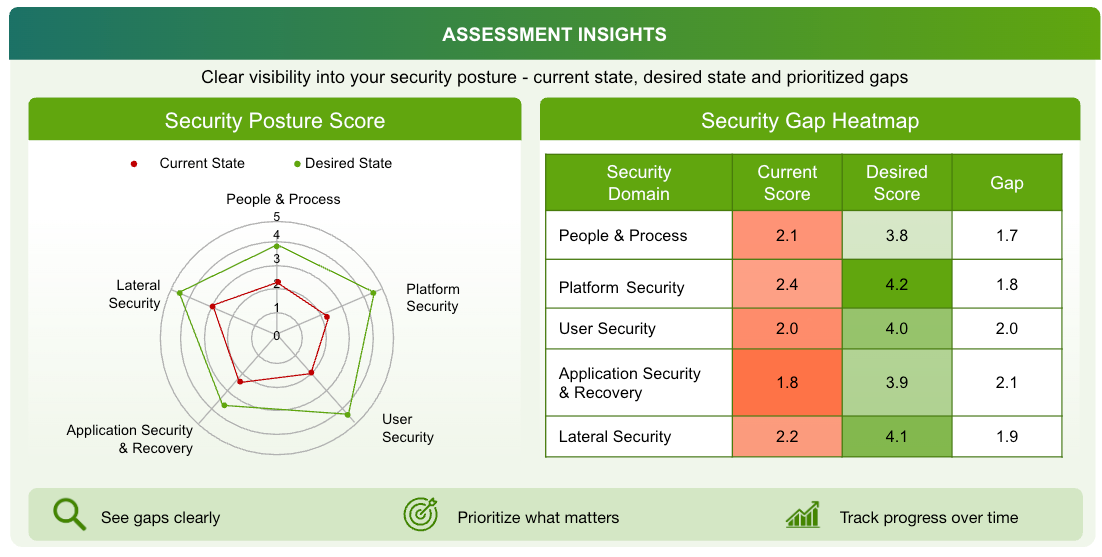
Защита частных облаков VMware Cloud Foundation (VCF) от управляемых ИИ угроз, действующих на машинной скорости, требует отказа от статических периметров в пользу автоматизированной модели secure-by-design. Лепестковая диаграмма и анализ пробелов, которые формирует опросник оценки безопасности, помогают совершить этот переход: они вскрывают критические уязвимости и дают немедленную визуальную ясность по пяти архитектурным опорам — People and Process, User Security, Platform Security, Lateral Security и Application Security & Recovery. Вооружившись этими данными, организации могут выстроить устойчивую базовую линию платформы, которая минимизирует поверхность атаки, обеспечивает строгий контроль идентичностей, ограничивает горизонтальное перемещение и позволяет быстро восстанавливаться. Тем самым реактивное управление обновлениями превращается в целенаправленную непрерывную защиту, способную выдерживать атаки эпохи Frontier AI.
Этап Architect
После того как базовая линия безопасности установлена, этап Architect переводит сырые результаты оценки в конкретный устойчивый целевой дизайн. Сочетание баллов оценки безопасности и тепловых карт пробелов с VCF Security Blueprints по тем же пяти ключевым разрезам — People & Process, Platform, User, Lateral и Application Security & Recovery — даёт чёткие предписывающие рекомендации. Это обеспечивает точный набор строительных блоков для реализации: от внедрения строгого RBAC и SSO до перехода на VCF 9.1+ ради автоматизированного обновления в рамках жизненного цикла и встраивания базовых сетевых механизмов, шифрования и средств аварийного восстановления.
С точки зрения угроз передового AI такой системный конвейер критически важен. Автономные атакующие движки используют архитектурную несогласованность, дрейф конфигураций и задержки в установке патчей, чтобы связывать эксплойты в цепочки гораздо быстрее, чем команды успевают реагировать вручную. Соединяя данные оценки с чертежами по пяти разрезам для выработки предписывающих рекомендаций, можно устранить догадки при проектировании и обеспечить стандартизированные, жёстко заданные ограничители по всему стеку VCF. Это помогает гарантировать, что архитектура структурно защищена от непрерывных атак, оркестрируемых AI.
Этап Implement
Как только целевая архитектура определена, этап внедрения и эксплуатации переводит безопасность в плоскость повседневных операций через три ключевых вида деятельности:
- Развёртывание компонентов по проверенным, усиленным блупринтам
- Выполнение бесшовного автоматизированного обновления для поддержания соответствия требованиям
- Использование сканеров безопасности для бюллетеней VMware Security Advisories, чтобы быстро приоритизировать уязвимости
Помимо этих базовых активностей интегрируются развивающиеся возможности AI, включая операции с AI-поддержкой, сортировку и устранение проблем силами AI, непрерывное применение политик и аналитику угроз в реальном времени. Эти возможности дают командам силы защищать, обнаруживать и реагировать в нужном масштабе.
С точки зрения угроз передового AI этот операционный фундамент становится передним краем обороны. Автономные атакующие агенты целенаправленно эксплуатируют операционную задержку между публикацией бюллетеня безопасности и установкой патча, выполняя эксплойты на машинной скорости. Чтобы бороться с AI при помощи AI, автоматизированные сценарии обновления, непрерывная аналитика безопасности и анализ первопричин на базе AI сокращают окно уязвимости практически до нуля. Это помогает частному облаку динамически адаптироваться и самокорректироваться, оставаясь устойчивым к современным векторам угроз.
На всех трёх этапах заказчики работают рука об руку со своими системными инженерами (SE) и техническими менеджерами (TAM), либо с партнёрами. Стоит отметить, что VCF Professional Services предлагает набор сервисов, соответствующих этапам программы (Assess, Architect, Implement), а экспертное сопровождение способно заметно ускорить сроки проектов. Подробности о VCF Professional Services можно узнать у своей команды по работе с клиентами.
Этап Upskill
Заключительная опора программы готовности к безопасности сосредоточена на готовности людей и реализуется через специализированное обучение и лидирующие в отрасли сертификации. В эпоху передового AI повышение квалификации сотрудников становится фундаментальным требованием: только так команды смогут грамотно проектировать, эксплуатировать и поддерживать структурно устойчивое частное облако перед лицом эволюционирующих угроз на машинной скорости.
Учебная программа VCF 9.1 даёт глубокое понимание современных путей обновления и функций киберустойчивости, помогая персоналу оставаться в курсе новейших архитектурных ограничителей.
Ознакомиться с актуальными обучающими материалами по VCF 9.1 можно по следующим направлениям.
Цифровое обучение по запросу (On-Demand Digital Learning):
Очное обучение с инструктором (ILT):
Сертификационный трек AI Resilient Infrastructure Expert (ARIE), скоро
Готовящийся трек ARIE предлагает три целевых учебных маршрута, рассчитанных на структурное усиление защиты платформы VCF:
- Специалисты по продажам (4 часа): фокус на свободном владении темой устойчивости к AI, позиционировании VCF как стека безопасности и эффективных стратегиях общения с CISO.
- Системные инженеры (около 10 часов): технические погружения во внутреннее устройство DFW, VM-identity, Avi WAF, Live Recovery и VulnOps для защиты на машинной скорости.
- Кандидаты VCDX (40 часов): продвинутые лабораторные работы, ведущие к сертификациям VCAP/VCDX, с упором на применение Zero Trust и автономное реагирование на угрозы.
Эти адаптированные маршруты позволяют персоналу получить предписывающую экспертизу, необходимую для защиты стека VCF от современных векторов атак. По завершении специализированной учебной программы команды будут способны:
- Проектировать архитектуры Zero Trust в соответствии с методиками NIST, CIS и MITRE.
- Обеспечивать защиту рабочих нагрузок средствами микросегментации vDefend, IDS/IPS и Avi WAF.
- Использовать Salt для автоматизации непрерывного контроля соответствия и устранения дрейфа конфигураций.
- Обеспечивать устойчивость к программам-вымогателям и выполнять быстрое ускоренное восстановление.
С обучением AI Resilient Infrastructure Expert команды не просто узнают о защите современного частного облака. Они получают сертификацию на защиту платформы VCF. Стоит учитывать, что сертификации сгруппированы по нескольким технологическим направлениям и имеют уровни как для новичков в отрасли, так и для экспертов. Подробнее об этом рассказывает страница VMware Certification.
Дальнейшие шаги
Для участия в программе Frontier AI Security Readiness нужно заполнить форму заявки: https://go-vmware.broadcom.com/frontier-ai-security-readiness-program
Во-вторых, стоит связаться со своей командой по работе с клиентами или партнёром, чтобы разобраться в предложениях VCF Professional Services, которые помогают ускорить высокоприоритетные ИТ-проекты. Наконец, стоит воспользоваться правами на обучение VCF Learning, чтобы повысить или сменить квалификацию с помощью продвинутых курсов и новых сертификаций VCAP и VCDX, а также следить за анонсом будущего трека обучения и сертификации AI Resilient Infrastructure Expert (ARIE). Читать далее... - читать дальше и комментировать
|
Одна мысль звучит от заказчиков VMware постоянно: перенос нагрузок Kubernetes на VMware vSphere Kubernetes Service (VKS) — самый важный шаг на пути внедрения VMware Cloud Foundation (VCF). Долгое время он же оставался и самым трудным для объяснения. У большого числа заказчиков миграция раз за разом всплывала как блокер номер один на пути к VCF. Опасения были реальными и повторяющимися: длинные окна переключения, риск потери данных и методы резервного копирования и восстановления, которые попросту не поспевали за масштабом крупных наборов данных. В отдельных случаях заказчикам приходилось полностью отказываться от старой среды и разворачивать новые кластеры VKS с нуля — только чтобы обойти эту сложность.
Именно эту проблему и взялись решить. За несколько последних месяцев команды профессиональных сервисов, решений и инженерная команда проверили три различных пути миграции на широком наборе исходных топологий: от Tanzu и OpenShift на vSphere до Kubernetes на «голом железе» и облачных дистрибутивов вроде EKS, GKE и AKS. Результатом стал повторяемый плейбук из трёх путей, за которым стоят скрипты, ранбуки и технические документы. Этот материал обобщает четыре документа, кодифицирующих плейбук, и даёт практическую систему выбора нужного пути под конкретную ситуацию. Полный список документов доступен по ссылкам ниже.
Четыре ситуации миграции
Большинство разговоров о миграции сводится к одной из ситуаций, на которые хорошо ложатся технические документы:
| Ваша ситуация |
Технический документ |
Исходная платформа |
| Kubernetes уже работает на vSphere (с драйвером vSphere CSI) |
Migrating vSphere-Based Kubernetes Workloads to VKS Using Zero-Copy FCD Adoption |
Tanzu Kubernetes Grid, OpenShift, Rancher, upstream-Kubernetes — всё на vSphere |
| Инфраструктура уже на VKS, перенос идёт между кластерами VKS |
Migrating Workloads Between VKS Clusters Using Cross-vCenter vMotion |
Гостевой кластер VKS в другой гостевой кластер VKS (тот же или другой Supervisor) |
| Kubernetes на vSphere, но для хранения используется сторонний CSI (NFS, Ceph, внешние массивы) |
Migrating non-vSphere Kubernetes Sources to VKS Using Filesystem Replication |
Любой Kubernetes на vSphere с хранением на стороннем CSI (NFS, Ceph, внешние SAN и NAS) |
| Kubernetes работает вне vSphere (облачный, «голое железо», стороннее хранение) |
Migrating Kubernetes Workloads to VKS Using Velero and S3-Compatible Storage |
OpenShift на «голом железе», облачные Kubernetes, любой сторонний CSI |
Методология, общая для всех сценариев
Все четыре документа опираются на один и тот же каркас — четырёхфазную методологию, которая сохраняет миграцию проверяемой и обратимой:
- Discover — инвентаризация всего: объекты Kubernetes API, топология сети, RBAC и секреты (значения никогда не выгружаются), а также перекрёстная сверка с FCD в vSphere, сопоставляющая каждый PVC с PV и с UUID диска FCD.
- Analyze — трансляция специфичных для платформы объектов в эквиваленты VKS (Routes в OpenShift становятся Ingress, SCC — Pod Security Admission, проекты Rancher — пространствами имён) и выбор пути для данных.
- Blueprint — фиксация плана в файле Solution Definition File (SDF) с тремя письменными шлюзами согласования: спонсор, платформа, комплаенс. Ни одна волна не выполняется, пока не подписаны все три.
- Execute — поволновая миграция с прогонами вхолостую, шлюзами валидации и отрепетированным откатом.
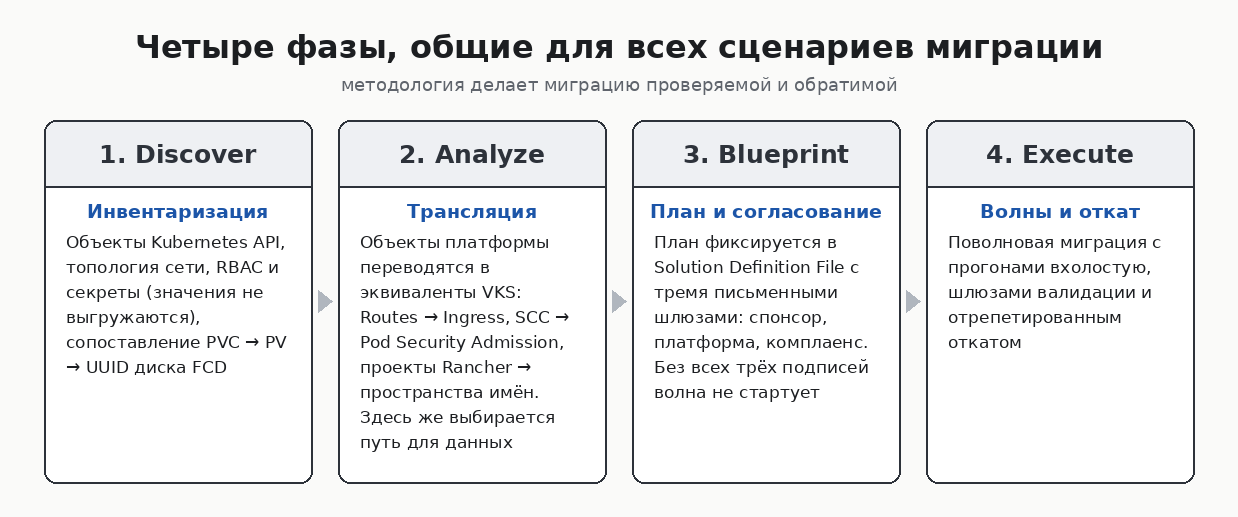
Различаются ситуации тем, какой путь для данных выбирается на второй фазе: именно он определяет простой, риск потери данных и инструментарий.
Варианты переноса постоянных данных
Это самое важное решение в любой миграции на VKS, и сводится оно к одному вопросу: находится ли диск, на котором лежит постоянный том, уже внутри vSphere?
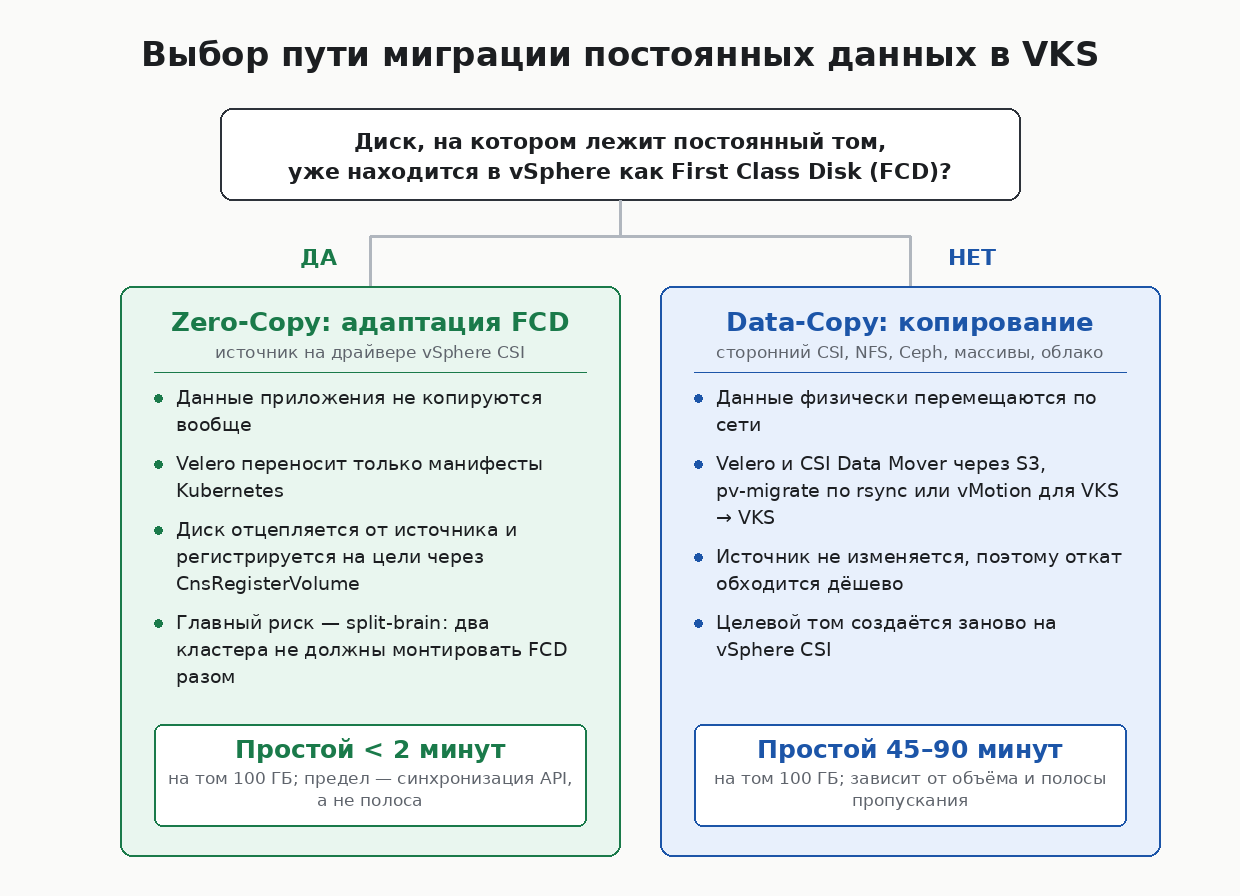
Путь 1: Zero-Copy, адаптация FCD только на уровне метаданных
Применяется, когда источник использует драйвер vSphere CSI, а диск First Class Disk (FCD) присутствует в базе данных vCenter. Данные приложения не копируются вообще. Velero переносит манифесты Kubernetes (PV, PVC и снимки при этом исключаются), а сам FCD отцепляется от источника и заново регистрируется на целевом кластере через CnsRegisterVolume. Всё это время том физически остаётся на том же хранилище данных.
- Простой: ограничен синхронизацией API, а не полосой пропускания — менее 2 минут для тома объёмом 100 ГБ.
- Риск потери данных: низкий, поскольку копирования нет, но операционный риск вполне реален — опасность в разделении состояния (split-brain). Оба кластера ни в коем случае не должны монтировать FCD одновременно, иначе повреждение данных наступает немедленно. Источник должен быть масштабирован до нуля прежде, чем целевой кластер подключит диск.
- Предварительные требования: хранение источника на vSphere CSI; FCD разрешается в vCenter; политика reclaim у PV изменена на Retain до освобождения исходного claim; проверена целостность UUID диска FCD (Storage vMotion между хранилищами может изменить UUID); подключением должен управлять драйвер CSI, а не команда
govc disk.attach.
Путь 2: Data-Copy, копирование данных
Применяется, когда хранение реализовано не на vSphere CSI (AWS EBS, Ceph, NFS, облачные блочные хранилища) либо когда FCD в vCenter отсутствует. Данные физически перемещаются через S3-совместимое объектное хранилище с помощью Data Mover для снимков CSI в Velero: встроенный в агент узла движок Kopia выполняет дедупликацию, сжатие, шифрование и выгрузку блоков, а целевая сторона создаёт новый том vSphere CSI и загружает данные в него.
- Простой: растёт вместе с объёмом тома и зависит от полосы пропускания — 45–90 минут для тома 100 ГБ. Замеры дали около 24 минут для одного PVC на 450 ГиБ при использовании движка под управлением оператора и около 86 минут для четырёх томов по 450 ГиБ (1,8 ТиБ) параллельно.
- Риск потери данных: выше, поскольку данные активно копируются. Но источник при этом не изменяется, поэтому откат обходится дёшево: достаточно удалить целевое пространство имён и заново созданные тома, а источник остаётся главным вплоть до момента переключения.
- Предварительные требования: Velero и CSI Data Mover (либо файловое резервное копирование для драйверов без поддержки снимков); общая точка BackupStorageLocation на S3, доступность которой подтверждена с обоих кластеров; сетевая доступность; класс хранения с немедленной привязкой (Immediate) на целевой стороне; MinIO или S3 объёмом не менее 1,2 от самой крупной партии.
Замечание об инструментах: путь с копированием данных использует Velero вместе с Restic или Kopia (либо Data Mover для снимков CSI в составе Velero). Для источников вне vSphere документы описывают также pv-migrate — более прямой инструмент переноса данных «точка-точка» на базе rsync. А для переездов между кластерами VKS в разных vCenter блоки FCD переносит сам vMotion, и этот вариант предпочтительнее и Velero, и pv-migrate, поскольку он уже является частью vSphere.
Какой путь выбрать: руководство по принятию решения
Ниже — практическая рекомендация для каждой ситуации.
Ситуация 1: инфраструктура уже на vSphere (TKG, OpenShift, Rancher, upstream)
Это идеальный случай, и именно на него приходится основной спрос со стороны заказчиков сегодня: более 300 кластеров на vSphere CSI ждут такого переезда. Почти наверняка такая инфраструктура подходит под zero-copy-адаптацию FCD, которая превращает многочасовое окно простоя в считанные минуты. Схема принятия решения из документа выглядит так:
- Драйвер хранения —
csi.vsphere.vmware.com, и FCD присутствует в vCenter: zero-copy через CnsRegisterVolume.
- Любой другой драйвер CSI либо отсутствие FCD в vCenter: копирование данных через Velero с Restic или Kopia.
Обязательно следует сменить политику reclaim у PV на Retain до удаления исходного PVC, проверить UUID диска FCD после любого Storage vMotion и никогда не допускать одновременного монтирования обоими кластерами. Состояние Helm нужно обрабатывать явно. Миграция пространств имён без фильтров исключения сохраняет на целевой стороне секреты релизов Helm (sh.helm.release.v1) и блокирует helm upgrade. Этап 6.5 методологии выполняет сверку или пересборку релиза с ключом --take-ownership.
Рекомендация: по умолчанию выбирать zero-copy. Копирование данных оставить для небольшого набора томов на стороннем хранилище. Рассчитывать стоит на SLA отката менее 10 минут, если что-то пойдёт не так.
Ситуация 2: инфраструктура уже на VKS, перенос между кластерами VKS
Внешне это похоже на первую ситуацию, но нюанс в том, где расположены Supervisor и vCenter.
- Тот же vCenter и то же хранилище данных: zero-copy — объекты Supervisor сохраняются, создаётся новый PV в VKS, и всё завершается менее чем за 2 минуты на каждые 100 ГБ.
- Разные vCenter: копирование данных, но силами vMotion, а не Velero и не pv-migrate. vMotion переносит блоки FCD нативно, через транспортную оболочку в виде выключенной вспомогательной виртуальной машины, после чего
CnsRegisterVolume адаптирует диск на приёмной стороне. Закладывать следует 45–90 минут на каждые 100 ГБ.
- Резервное копирование и восстановление томов средствами Velero здесь явно не выбрано как путь: промежуточное хранение в S3 добавляет задержку, которой vMotion избегает.
Два правила для сценария с разными vCenter важнее прочих. Первое: UUID диска FCD сохраняется при миграции, но его всегда необходимо заново обнаруживать после vMotion — нельзя предполагать, что он совпадает с исходным идентификатором, и нельзя передавать исходный UUID в CnsRegisterVolume. Второе: пространству имён на целевом Supervisor нужна политика хранения, назначенная этому FCD и открытая для данного пространства имён, а также трансляция реестра образов и ingress (например, AKO в Contour) через плагины ConfigMap в Velero.
Рекомендация: если оба кластера используют один vCenter и одно хранилище данных, zero-copy тривиален. Если нет — опираться следует на vMotion, а UUID диска FCD рассматривать как величину, которую всегда перепроверяют, а не принимают на веру. Откат ограничен длительностью vMotion, поэтому RTO стоит отрепетировать.
Ситуация 3: инфраструктура на vSphere, но хранение не на vSphere CSI (NFS, Ceph, внешние массивы)
Этот сценарий сбивает с толку чаще всего. Кластер Kubernetes работает на vSphere, поэтому легко предположить, что zero-copy-адаптация FCD доступна. Но постоянные тома обслуживает сторонний драйвер CSI: NFS, Ceph, внешний массив SAN или NAS либо любой другой сторонний плагин хранения. Адаптировать в vCenter нечего, FCD там просто нет, поэтому zero-copy отпадает. Документ формулирует это прямо: реализация хранения на стороне источника не имеет значения для метода переноса, пока исходный PVC является файловым томом, который задание миграции может смонтировать и прочитать.
Рекомендуемый путь — копирование данных через pv-migrate (rsync поверх SSH), тогда как манифесты Kubernetes переносит Velero. Поскольку перенос работает на уровне файловой системы по сети, источнику и приёмнику не нужно иметь общую платформу хранения, общий драйвер CSI и даже общий vCenter. Этот же документ покрывает и полностью не-vSphere источники: методология идентична, потому что абстракция хранения одна и та же.
- Простой: растёт вместе с объёмом набора данных, количеством файлов и доступной полосой пропускания — 45–90 минут для тома 100 ГБ.
- Риск потери данных: выше, чем при zero-copy, поскольку данные физически копируются, но исходный PVC не удаляется до тех пор, пока волна не принята, — граница отката сохраняется полностью.
- Предварительные требования: исходный PVC является файловым томом; pv-migrate (rsync поверх SSH) для данных; Velero для манифестов; Helm для сверки; сетевая достижимость между источником и VKS по TCP 22 до балансировщика нагрузки VKS; класс хранения StorageClass на стороне VKS.
- Ключевой принцип: исходный и целевой тома — независимые объекты хранения. Им не требуется общий vCenter, общий домен CNS, общий массив хранения, общий драйвер CSI или общий дистрибутив Kubernetes. Исходный PVC остаётся на месте и обеспечивает возможность отката до тех пор, пока волна миграции не будет принята.
Нюанс по сравнению с первой ситуацией стоит подчеркнуть: работать на vSphere — недостаточно. Решающим фактором является то, лежит ли постоянный том на диске FCD, которым управляет драйвер vSphere CSI. Если нет, то даже когда сам кластер работает на виртуальных машинах vSphere, сценарий относится к территории копирования данных.
Рекомендация: использовать pv-migrate для копирования данных и Velero для манифестов. Заложить окно по полосе пропускания, выполнить инкрементальную синхронизацию перед переключением, чтобы минимизировать финальную дельту, и сохранять исходный PVC до тех пор, пока нагрузка в VKS не пройдёт проверку. Откат чистый: достаточно удалить целевой PVC и создать его заново, источник остаётся нетронутым.
Ситуация 4: инфраструктура вне vSphere (облако, «голое железо», стороннее хранение)
Zero-copy здесь недоступен, потому что в vCenter нет FCD, который можно было бы адаптировать. Копирование данных остаётся единственным путём, а эталонная архитектура на Velero и S3 — проверенный способ его реализовать. Главная мысль этого документа в том, что источники вне vSphere заставляют встретиться с гравитацией данных лицом к лицу, поэтому работа уходит в классификацию и тонкую настройку, а не в изобретательные приёмы с хранилищем.
- Каждый объект классифицируется до переключения по одной из трёх проекций: MIGRATE_AS_IS (переносимый, восстанавливается без изменений), REVIEW_REQUIRED (нужен трансформирующий оверлей — Route в Ingress, DeploymentConfig в Deployment, SCC в Pod Security Admission) или BLOCK_MIGRATION (на целевой стороне отсутствует CRD или оператор — сначала установить, либо исключить). Скрипты проверяются по записанным ожидаемым вердиктам, поэтому неверная классификация всплывает как дефект инструментария до переключения, а не как сломанное приложение после.
- Предпочтительна установка под управлением оператора: на источнике это OADP в OpenShift. По результатам проверки она оказалась примерно в 4 раза быстрее нативного Velero для одного PVC на 450 ГиБ (24 минуты против примерно 90), потому что плагин CSI, Data Mover и агент узла остаются согласованными по версиям и обновляются как единое целое. На целевой стороне VKS всегда работает нативный Velero.
- Ориентироваться следует на ресурсы DataUpload и DataDownload, а не на фазу Backup или Restore: именно ресурсы данных являются источником истины. PartiallyFailed — нормальное конечное состояние для восстановления, и только постпроверочное сканирование вместе с чек-листом приёмки решают, прошла ли партия.
- Асимметрия ёмкости: файловые системы вне vSphere (например, CephFS) сообщают всю номинальную ёмкость как доступную, тогда как целевые тома на vSphere CSI с ext4 заранее выделяют таблицы inode (около 1,7%) и резервируют 5% для root. Исходные PVC следует заполнять не более чем на 90%, а целевые PVC для патологически заполненных томов делать больше.
Рекомендация: планировать копирование данных с самого начала. Заложить окно по полосе пропускания, классифицировать объекты заранее, предпочесть установку Velero под управлением оператора и выполнить дельта-партию непосредственно перед переключением, чтобы последние записи источника попали на целевую сторону. Откат обходится дёшево, поскольку источник не изменяется, поэтому фиксироваться следует только в момент переключения.
Сводим воедино: краткая таблица решений
| Если источник… |
А хранение… |
Использовать путь |
Простой (100 ГБ) |
Основной инструментарий |
| Kubernetes на vSphere (TKG, OpenShift, Rancher, upstream) |
vSphere CSI и FCD в vCenter |
Zero-copy |
Менее 2 минут |
Velero (манифесты) и CnsRegisterVolume |
| VKS в VKS, разные vCenter |
vSphere CSI |
Копирование данных через vMotion |
45–90 минут |
vMotion и CnsRegisterVolume |
| Kubernetes на vSphere |
Сторонний CSI, FCD отсутствует |
Копирование данных |
45–90 минут |
Velero с Restic или Kopia либо pv-migrate |
| Kubernetes вне vSphere (облако, «голое железо») |
Любое хранение вне vSphere |
Копирование данных |
45–90 минут |
Velero, CSI Data Mover и S3 |
Несколько правил, действующих для всех четырёх методов
Каким бы ни был выбранный путь, эти правила работают всегда:
- Разделять конфигурацию без состояния и хранение с состоянием. Velero переносит манифесты, путь хранения переносит данные. Смешивать их не нужно.
- Никогда не обслуживать трафик с обеих сторон одновременно. Перед финальной партией источник нужно остановить или масштабировать вниз, либо выполнить дельта-партию прямо перед переключением. Две расходящиеся живые копии — самый быстрый способ получить повреждение данных.
- Сохранять метаданные PVC, принадлежащие приложению (метки и аннотации для Helm и операторов), но никогда не копировать метаданные привязки и выделения, сгенерированные самим Kubernetes: на восстановленной целевой стороне они не совпадут.
- Явно обрабатывать состояние Helm. Не удалять вслепую секреты релизов Helm; до переключения извлечь значения и версию чарта из источника и выполнить сверку с ключом
--take-ownership.
- Проверять до продвижения. Шлюз продвижения контролирует, что PVC находится в состоянии Bound, реплики готовы, а конечная точка проверки состояния приложения отвечает healthy. До перевода волны в стабильное состояние должны пройти все четыре проверки.
- Откат всегда репетируется. Zero-copy даёт RTO менее 10 минут, копирование данных даёт дешёвый откат, поскольку источник не тронут. В любом случае RTO нужно знать до переключения.
Итог
Правильная стратегия миграции — та, что соответствует месту, где данные уже находятся. Если тома уже являются дисками FCD в vSphere, zero-copy-адаптация превращает миграцию в операцию с метаданными, измеряемую минутами. Если нет, хорошо настроенный конвейер копирования данных на Velero и S3, с дисциплинированной классификацией объектов и отрепетированным откатом, приведёт к цели столь же безопасно, просто по графику, который упирается в полосу пропускания. А если инфраструктура уже работает на VKS, vMotion вместе с CnsRegisterVolume позволяет переезжать между кластерами вообще без копирования на уровне Kubernetes.
Обратная связь
Описанные пути миграции проверены, но не заморожены. По мере того как всё больше команд будет прогонять их на реальных производственных нагрузках, именно этот опыт отточит следующую редакцию плейбука. Обратная связь здесь по-настоящему важна. Связаться с Broadcom за подробностями можно, используя эту форму. Читать далее... - читать дальше и комментировать
|
Шифрованный vMotion уже много лет остаётся одним из краеугольных камней защиты рабочих нагрузок в средах VMware. Он гарантирует, что данные виртуальной машины защищены при передаче каждый раз, когда ВМ перемещается между хостами, и для большинства продуктивных сред это попросту обязательное требование. С выходом VMware Cloud Foundation (VCF) 9.1 эта защита становится ещё эффективнее: криптографическая работа перекладывается на Intel QuickAssist Technology (QAT) — аппаратный ускоритель, встроенный в современные процессоры Intel Xeon. В VCF 9.1 функция включена по умолчанию и не требует какой-либо настройки. Команде инженеров было важно понять, сколько именно вычислительной мощности CPU возвращается заказчику, когда шифрованием занимается QAT, а не процессор. Тесты были проведены, и результаты дают вполне однозначную картину.
Как работает разгрузка на QAT
Когда запускается миграция vMotion, данные ВМ шифруются на исходном хосте и расшифровываются на целевом. При использовании разгрузки на QAT в VCF 9.1 работа по шифрованию и расшифровке выполняется аппаратным ускорителем QAT, а не центральным процессором. Процессоры на обеих сторонах освобождаются и могут заниматься выполнением рабочих нагрузок. Для администратора функция прозрачна и на поддерживаемом оборудовании Intel Xeon включена по умолчанию. Подробнее о разгрузке шифрованного vMotion на Intel QAT в VCF 9.1 рассказывается в отдельной статье.
Стенд для тестирования
Для испытаний требовалась нагрузка, чувствительная к доступности CPU, — такая, на которой было бы отчётливо видно, что происходит с производительностью приложения, когда процессор получает обратно такты, ранее уходившие на шифрование. Выбор пал на базу данных Oracle под управлением HammerDB — OLTP-нагрузку с интенсивным профилем дисковых операций. Основной метрикой состояния системы на протяжении всех испытаний служила пропускная способность транзакций Oracle (операций в секунду).
Методика миграции была следующей: на этапе измерений в установившемся режиме выполнялось восемь последовательных операций vMotion с паузой в 120 секунд между соседними миграциями. Восемь прогонов дают статистически честную картину вместо одной-единственной точки данных.
Тестировались три конфигурации:
- Шифрование отключено: теоретический потолок без каких-либо криптографических накладных расходов.
- QAT Off: шифрованный vMotion полностью выполняется программно силами CPU.
- QAT On: шифрованный vMotion разгружен на аппаратный ускоритель Intel QAT.
Результаты
Медианные значения по всем восьми миграциям:
| Метрика |
Шифрование отключено |
QAT OFF |
QAT ON |
| Время миграции (секунды) |
57,22 |
86,97 |
84,71 |
| Пропускная способность предварительного копирования (МБ/с) |
10 871 |
7 592 |
7 146 |
| CPU исходного хоста (среднее число одновременно занятых ядер) |
7,8* |
20,1 |
7,7 |
| CPU целевого хоста (среднее число одновременно занятых ядер) |
18,8* |
13,6 |
10,5 |
| Пропускная способность Oracle (операций/с) |
51 319 |
44 306 |
50 634 |
| Время простоя ВМ (секунды)** |
0,42 |
0,33 |
0,78 |
* Эта конфигурация завершает миграции за существенно меньшее астрономическое время, поэтому её показатель среднего числа одновременно занятых ядер отражает ту же фоновую работу CPU, сжатую в более короткое окно, и не является корректной точкой сравнения с конфигурациями QAT On и QAT Off. Приводится исключительно для справки.
** Время простоя в обеих конфигурациях оставалось близким к целевому, а наблюдаемый разброс обусловлен характером передачи страниц (page-in) на конкретно этой нагрузке, а не работой QAT. Разгрузка шифрования не оказывает причинно-следственного влияния на время простоя.
Экономия CPU на исходном хосте
Загрузка CPU исходного хоста падает с примерно 20,1 ядра при QAT Off до примерно 7,7 ядра при QAT On — это около 62% сокращения вычислительной мощности, расходуемой на шифрование vMotion на стороне источника. Процессорные ресурсы, ранее занятые шифрованием, теперь могут быть отданы работе Oracle. Целевой хост тоже выигрывает: накладные расходы на расшифровку сокращаются примерно на 23% (с ~13,6 до ~10,5 ядра). Больший выигрыш достаётся исходному хосту, поскольку шифрование из этих двух операций вычислительно более затратно.
Пропускная способность Oracle
При QAT Off пропускная способность Oracle в окне миграции составляла 44 306 операций в секунду. При QAT On она восстановилась до 50 634 операций в секунду, что на 14% больше, чем при чисто программном шифровании. Для OLTP-среды, где темп транзакций напрямую отражается на бизнес-результате, эта возвращённая пропускная способность имеет вполне ощутимую ценность.
Время миграции
Конфигурации QAT On и QAT Off дают практически одинаковое время миграции — 84,71 против 86,97 секунды. Разгрузка на QAT и не рассчитана на то, чтобы ускорять саму миграцию. Операции копирования по сети и работы с памятью занимают одинаковое время в обоих случаях. Меняется другое — сколько процессорного запаса остаётся работающей нагрузке, пока идёт эта передача.
Стабильность и джиттер
Разгрузка на QAT полностью развязывает шифрование и планирование выполнения на CPU, и это проявляется в измеримо меньшем разбросе как времени миграции, так и пропускной способности гостевой системы при повторяющихся миграциях. Для нагрузок, работа которых регламентирована SLA, такая предсказуемость имеет вполне реальную эксплуатационную ценность.
Результаты при одновременных миграциях vMotion
Результаты по одиночной ВМ показывают лишь часть картины. Сценарии эвакуации хоста подразумевают множество одновременных миграций. Такие тесты также были проведены.
При невысокой степени параллелизма (от 4 до 6 ВМ одновременно на каналах 25–50 GbE) QAT обеспечивает сокращение нагрузки на CPU на 40–45% без изменения времени завершения миграций. При более высокой степени параллелизма, характерной для полной эвакуации хоста, миграции завершаются практически с той же скоростью, что и без QAT, тогда как потребление CPU на исходном хосте снижается вплоть до ~39%. Плановое обслуживание или аварийная эвакуация — в обоих случаях QAT возвращает задействованным хостам заметный запас процессорной мощности.
Возврат CPU рабочим нагрузкам
Основная ценность разгрузки на QAT состоит не в скорости миграции. Она в том, что именно возвращается системе. Каждое ядро вычислительной мощности, которое QAT удерживает от работы по шифрованию, — это ядро, которое рабочая нагрузка забирает себе для полезной работы. В проведённых тестах это выразилось в 14% приросте пропускной способности Oracle, удерживаемом на протяжении всего окна миграции, и примерно 62% сокращении вычислительной мощности, потребляемой шифрованием на исходном хосте, что эквивалентно примерно 12 освободившимся ядрам во время миграции.
Для команд, эксплуатирующих плотные OLTP-среды, эти возвращённые такты могут стать разницей между сохранением темпа транзакций в окне обслуживания и его проседанием. Для более широкого класса смешанных нагрузок профиль выигрыша аналогичен. Процессор хоста может уделять больше внимания выполнению рабочих нагрузок, пока шифрованием занимается QAT.
Есть и эксплуатационный аспект. Поскольку QAT снимает с исходного хоста основную часть «процессорного налога» во время миграций, хосты с частой активностью vMotion — активные кластеры DRS или площадки с насыщенным графиком обслуживания и эвакуаций — сохраняют больший запас CPU для продуктивных нагрузок на протяжении всех этих операций, вместо того чтобы закладывать дополнительный резерв под накладные расходы на шифрование.
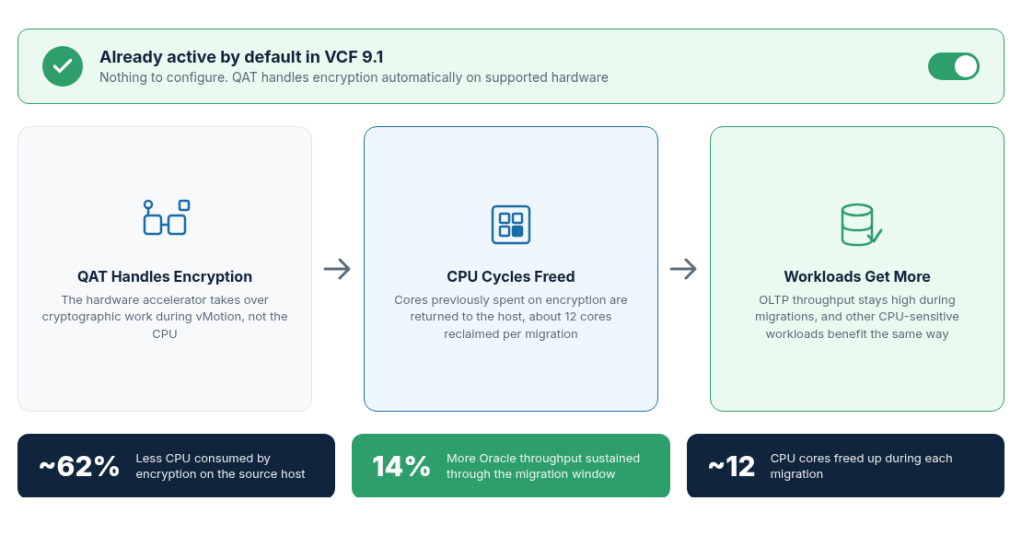
Что это значит на практике
Если VCF 9.1 уже работает на поддерживаемом оборудовании Intel Xeon, разгрузка на QAT уже активна. В среде виртуализации настраивать ничего не требуется. Практический вопрос в другом — что именно дадут конкретной инфраструктуре возвращённые процессорные такты. Для нагрузок с интенсивным OLTP-профилем вроде Oracle ответ очевиден: это пропускная способность транзакций, которую QAT возвращает приложению. Для других чувствительных к CPU нагрузок профиль выигрыша схож.
Итоги
Разгрузка на QAT в VCF 9.1 даёт примерно на 62% меньше накладных расходов CPU на исходном хосте, на 14% более высокую пропускную способность Oracle, удерживаемую в течение окна миграции, и меньший разброс времени миграции и производительности приложения при повторяющихся прогонах. Всё это происходит прозрачно на уровне инфраструктуры, на оборудовании, которое уже присутствует в большинстве развёртываний на Intel Xeon. Шифрованный vMotion продолжает делать ровно то же, что делал всегда: защищать рабочие нагрузки при передаче. Разгрузка на QAT лишь позволяет ему делать это, одновременно возвращая процессорные ресурсы тем нагрузкам, которым они нужны.
Тем, кто ещё не перешёл на VCF 9.1, это даёт конкретный измеримый повод для обновления. Для тех, кто уже работает на этой версии, описанный механизм уже действует в их среде. Проверить, поддерживает ли конкретная модель Intel Xeon технологию QAT, можно на ark.intel.com — и начать возвращать процессорные такты уже сегодня. Читать далее... - читать дальше и комментировать
|
Для администраторов vSphere и инженеров автоматизации ESXCLI остаётся одной из самых базовых утилит в наборе средств управления VMware. Она позволяет удалённо выполнять команды управления хостом: обращаться к хосту ESXi напрямую или работать с любым хостом под управлением vCenter Server — с локальной рабочей станции или административного jumpbox, без интерактивной SSH-сессии к самому хосту.
Недавно было объявлено о переводе автономной версии ESXCLI 9.1.0 (сборка 25692154) в статус общей доступности. Этот выпуск приносит упрощённую установку за счёт использования штатной упаковки Python, модернизацию платформы, ужесточение требований безопасности при проверке хоста, детальное управление клиентским логированием и критически важные исправления стабильности аутентификации.
Независимо от того, на какой системе выполняются задачи администрирования — Linux, macOS или Windows, — ESXCLI 9.1.0 делает удалённое управление более безопасным, доступным и надёжным.
Что нового в ESXCLI 9.1.0
1. Современные требования к Python и упрощённая поставка через PyPI
ESXCLI 9.1.0 распространяется как единый пакет Python, совместимый с PyPI. Установку и обновление автономной версии на Linux, Windows и macOS теперь можно выполнять стандартными инструментами управления пакетами Python.
Системные требования:
- Версия Python: требуется Python 3.10 или новее.
- Отказ от устаревших версий: Python 2.7 и версии Python ниже 3.10 больше не поддерживаются.
Чтобы установить ESXCLI 9.1 через PyPI, выполните:
pip install vmware-esxcli
Автономный пакет также можно загрузить напрямую с портала Broadcom Developer Portal.
2. Ужесточение требований безопасности: отказ от SHA-1
Требования стандартов безопасности в корпоративной инфраструктуре продолжают развиваться. В ESXCLI 9.1.0 отпечатки серверных сертификатов SHA-1 официально больше не принимаются.
Уведомление о критическом изменении
При установлении проверенных удалённых сессий поддерживаются только отпечатки SHA-256 и SHA-512. Это относится к следующим способам передачи отпечатка:
- параметр командной строки
--thumbprint;
- переменная окружения
VI_THUMBPRINT;
- записи, сохранённые в хранилище учётных данных ESXCLI.
Важное действие, которое нужно выполнить до обновления: проверьте автоматизированные скрипты, конвейеры CI/CD, переменные окружения и конфигурации хранилища учётных данных. Отпечатки SHA-1 необходимо заменить на отпечатки SHA-256 или SHA-512 до перехода на новую версию. Соединения, опирающиеся на отпечатки SHA-1, в версии 9.1.0 работать не будут.
Пример: запуск ESXCLI с отпечатком SHA-256
esxcli --server=vcenter.domain.local --target=esxi01.domain.local \
--username=administrator@vsphere.local \
--thumbprint=25:E3:4C:…:SHA256_THUMBPRINT… \
system version get
3. Гибкое управление клиентским логированием
В предыдущих версиях ESXCLI автоматически создавал и поддерживал ротируемый файл .log рядом с исполняемым файлом. В версии 9.1.0 поведение журналирования полностью настраивается и по умолчанию не проявляет себя никак.
- Поведение по умолчанию: клиент больше не создаёт файл журнала на диске и не пишет в него.
- Произвольный путь к журналу (
--log-file): перенаправление клиентских сообщений журнала в выбранный вами файл.
- Подробное и отладочное журналирование (
--log-verbose): включение детализации уровня debug для изучения деталей протокола и диагностики проблем с подключением или выполнением команд.
Пример: подробное журналирование в произвольный файл
esxcli --server=esxi01.domain.local \
--log-file=/var/log/esxcli-debug.log \
--log-verbose \
network nic list
Чек-лист обновления для администраторов
Прежде чем переходить на версию 9.1, держите в уме этот короткий список проверок:
- Проверьте окружение Python: убедитесь, что на административных рабочих станциях используется Python 3.10 или новее.
- Обновите отпечатки: замените все отпечатки SHA-1 в скриптах и сохранённых хранилищах учётных данных на отпечатки SHA-256 или SHA-512.
- Пересмотрите сценарии работы с журналами: если какие-либо пользовательские рабочие процессы полагаются на чтение файла журнала, который раньше создавался по умолчанию рядом с бинарным файлом ESXCLI, обновите эти сценарии так, чтобы они явно передавали
--log-file <path>.
Загрузка и документация
Начать работу можно уже сегодня:
Читать далее... - читать дальше и комментировать
|
Развёртывание контейнерных нагрузок в изолированных (air-gapped) средах всегда требовало тщательной проработки — особенно в ситуации, когда реестр платформы, который планируется использовать, не может установить сам себя без образов, которых у него ещё нет. Именно поэтому упрощение развёртывания Harbor в качестве Supervisor Service в изолированных средах VMware Cloud Foundation (VCF) стало одним из ключевых направлений работы. Раньше эффективным промежуточным решением служили наработки сообщества, например сторонние реестры, а теперь предлагается официальный, поддерживаемый в рамках VCF вариант, спроектированный специально под этот сценарий.
С выходом VMware Bootstrap Registry Appliance в полной доступности (General Availability) появилось официальное решение с поддержкой со стороны VCF: специализированный OVA-образ, который даёт заказчикам VCF чистый, безопасный и чётко регламентированный с эксплуатационной точки зрения путь первоначальной загрузки (bootstrapping) Harbor в роли Supervisor Service в изолированных средах VCF 9.0 и vSphere 8.0 Update 3.

Что такое VMware Bootstrap Registry Appliance
VMware Bootstrap Registry Appliance — это защищённый (hardened) виртуальный модуль, распространяемый в формате OVA. В его составе поставляется совместимый со спецификацией OCI реестр Harbor, работающий нативно на Photon OS 5.0. Модуль предназначен для размещения OCI-образов, необходимых для включения Harbor Supervisor Service (а также Contour) на vSphere Supervisor.
При этом модуль не является универсальным корпоративным реестром и не предназначен для обслуживания рабочих нагрузок в продуктивной среде. Его роль — Registry 0 в последовательности развёртывания изолированной среды: это временный инструмент первоначальной загрузки, который передаёт ответственность сервису Harbor Supervisor Service (Registry 1), как только тот становится работоспособным и функционирует штатно.
Чтобы обеспечить соответствие архитектурным требованиям и сохранить право на поддержку, развёртывание VMware Bootstrap Registry Appliance регулируется следующими обязательными эксплуатационными ограничениями:
- Исключительно задача bootstrap: VMware Bootstrap Registry Appliance допускается применять только для загрузки и хранения OCI-образов, необходимых для включения сервисов Contour и Harbor Supervisor на Supervisor.
- Запрет вторичных ролей: модуль не должен использоваться в инфраструктуре ни для каких иных целей. В частности, прямо запрещено его применение в качестве постоянного реестра платформы или корпоративного реестра рабочих нагрузок.
- Ограничение по версии развёртывания: использование VMware Bootstrap Registry Appliance допускается только в развёртываниях версий ниже VCF 9.1. Начиная с VCF 9.1 официально поддерживаемым решением для управления жизненным циклом изолированных сред становится Fleet Depot Service (FDS).
Загрузка VMware Bootstrap Registry Appliance
Модуль доступен на портале Broadcom Support Portal по следующим путям:
- Для vSphere 8.0: Broadcom Support Portal > My Downloads > VMware vSphere > VMware vSphere Standard > 8.0 > Drivers and Tools > VMware Bootstrap Appliance >
BOOTSTRAP_APPLIANCE-2.15.2+vmware.1-25635995.ova
- Для VCF 9.0: Broadcom Support Portal > My Downloads > VMware Cloud Foundation > VMware Cloud Foundation 9 – 9.0.2 > VMware vCenter > Drivers and Tools > VMware Bootstrap Appliance >
BOOTSTRAP_APPLIANCE-2.15.2+vmware.1-25635995.ova
Обзор процесса развёртывания
Развёртывание VCF в изолированной среде выполняется по двухфазной схеме. Сначала, на первой фазе, создаётся bootstrap-реестр на базе VMware Bootstrap Registry Appliance. На второй фазе разворачивается Harbor в качестве Supervisor Service, который затем становится продуктивным реестром для всех рабочих нагрузок.
Полное пошаговое описание, включающее развёртывание OVA, регистрацию на Supervisor, предварительную загрузку образов с помощью Carvel imgpkg и настройку data values для Harbor, требуемую при работе в изолированной среде, приведено в обновлённой статье о развёртывании: Deploying Harbor Service in Air-Gapped VMware Cloud Foundation 9.0, а также в репозитории VMware vSphere Supervisor на GitHub.
Взгляд в будущее: VCF 9.1 и Fleet Depot Service
Сегодня VMware Bootstrap Registry Appliance является подходящим решением для сред VCF 9.0 и vSphere 8.0 U3. Заказчики, которые перейдут на VCF 9.1, смогут воспользоваться преимуществами Fleet Depot Service (FDS). Этот встроенный реестр нативно обслуживает жизненный цикл первоначальной загрузки как часть платформы. В средах VCF 9.1 VMware Bootstrap Registry Appliance больше не требуется, поскольку эту роль берёт на себя FDS.
Заключение
Таким образом, VMware Bootstrap Registry Appliance закрывает пробел в сценарии развёртывания изолированных сред VCF. Он представляет собой специализированный и поддерживаемый инструмент первоначальной загрузки сервиса Harbor Supervisor Service. Решение на базе Bitnami Harbor заменяется альтернативой, готовой к промышленной эксплуатации. Этот путь рекомендуется как при развёртывании с нуля на VCF 9.0, так и при миграции уже существующей изолированной среды.
Загрузить модуль можно с Broadcom Support Portal в разделах VMware vSphere или VCF 9.0, а полное пошаговое описание приведено в обновлённом руководстве по развёртыванию Harbor в изолированной среде.
Дополнительные сведения о Harbor доступны в серии статей:
Читать далее... - читать дальше и комментировать
|
Другие посты
Архив новостей
|  |


 RSS